O DeepSeek-OCR oferece compressão de texto 10× com 97% de precisão ao tratar imagens como armazenamento comprimido para texto. Em vez de processar 1.000 tokens de texto individualmente, ele os processa como uma única imagem usando apenas 100 tokens de visão—reduzindo os custos em até 85%.
Agora disponível na Novita AI, o DeepSeek-OCR processa mais de 200.000 páginas por dia por GPU, suporta 100 idiomas e oferece cinco modos de resolução (64 a 400+ tokens). Ele vai além do OCR tradicional para analisar gráficos em dados estruturados, reconhecer fórmulas químicas, extrair figuras geométricas e possibilitar um gerenciamento inovador de memória para conversas longas.
Experimente agora no Novita AI Playground →
Procurando pela geração atual? A DeepSeek lançou desde então o DeepSeek-OCR 2, com uma pontuação mais alta no OmniDocBench e melhor precisão na ordem de leitura. Para novas integrações, veja Provedor de API DeepSeek OCR2 e use o ID do modelo
deepseek/deepseek-ocr-2.
O que é o DeepSeek-OCR?
O DeepSeek-OCR é um modelo de visão-linguagem que trata imagens como armazenamento comprimido para texto. Em vez de processar um documento com 1.000 tokens de texto individualmente (o que é computacionalmente caro), o modelo o processa como uma única imagem usando apenas 100 tokens de visão—uma redução de 10× nos custos de processamento.
Arquitetura Principal
O modelo consiste em dois componentes principais:
DeepEncoder (~380M parâmetros): Um codificador de visão especializado que processa eficientemente imagens de documentos usando uma arquitetura serial única que combina atenção por janela (SAM) e atenção global (CLIP) com uma camada de compressão 16× entre eles.
Decodificador DeepSeek3B-MoE (570M parâmetros ativos): Um modelo de linguagem compacto de mistura de especialistas que converte informações visuais comprimidas de volta para texto com notável precisão.
Essa arquitetura permite uma eficiência sem precedentes no processamento de documentos, tornando-a ideal para empresas que lidam com grandes volumes de documentos ou aplicações que exigem compreensão de contexto longo.
Por que a Compressão Óptica é Importante
O Problema Tradicional
O processamento de texto tradicional em modelos de IA escala quadraticamente—dobrar o comprimento do seu documento pode quadruplicar seus custos. Para empresas que processam milhares de documentos diariamente, isso se torna proibitivamente caro.
A Solução DeepSeek-OCR
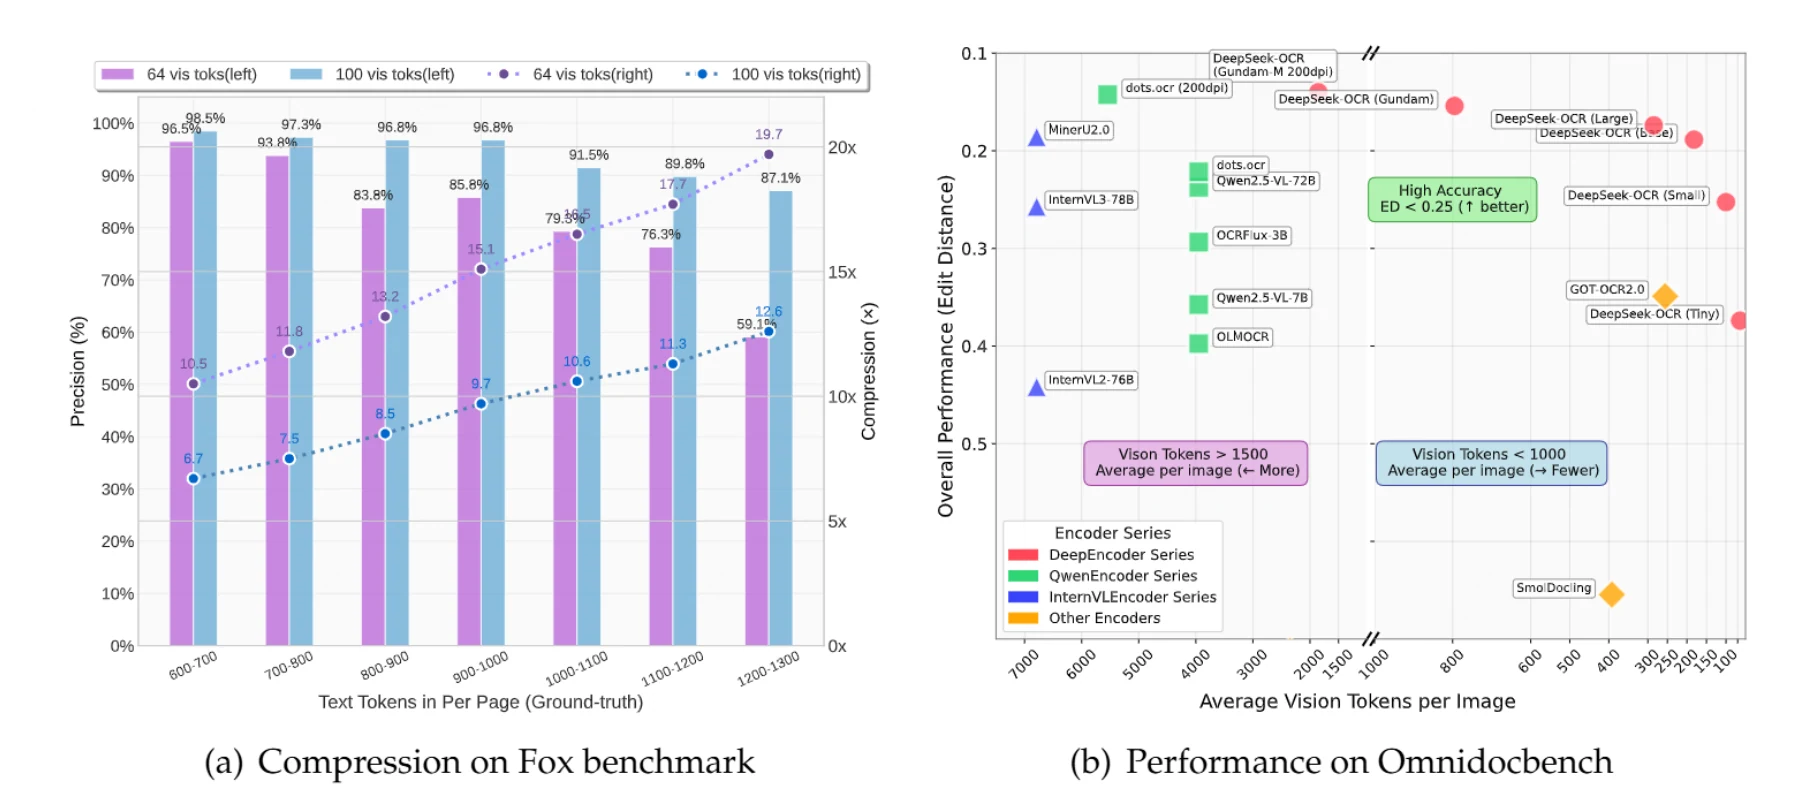
Documentos com até 1.000 tokens de texto podem ser comprimidos 10× com 97% de precisão. Mesmo com compressão de 20×, a precisão permanece em torno de 60%—muitas vezes suficiente para muitas aplicações.
Exemplo do Mundo Real:
Um documento contendo 900 tokens de texto tradicionalmente requer 900 tokens para processar. Com o DeepSeek-OCR usando o modo Pequeno (100 tokens de visão), você obtém compressão de 9,7× com 96,8% de precisão. Para documentos com 1.100 tokens de texto, você obtém compressão de 10,6× com 91,5% de precisão.
Impacto nos Negócios
Custos de API Reduzidos: Até 10× menos tokens processados para documentos típicos significa economia dramática de custos—uma empresa que processa 1 milhão de páginas mensalmente poderia economizar mais de US$ 50.000 anualmente.
Processamento Mais Rápido: Menos tokens se traduzem diretamente em tempos de resposta mais rápidos, melhorando a experiência do usuário e permitindo aplicações em tempo real.
Melhor Escalabilidade: Lide com 10× mais documentos com o mesmo investimento em infraestrutura, tornando o crescimento mais previsível e acessível.
Eficiência de Memória: Armazene o histórico da conversa como imagens comprimidas, permitindo aplicações de contexto ultra-longo sem requisitos exponenciais de memória.
Desempenho e Benchmarks
Resultados Abrangentes do OmniDocBench
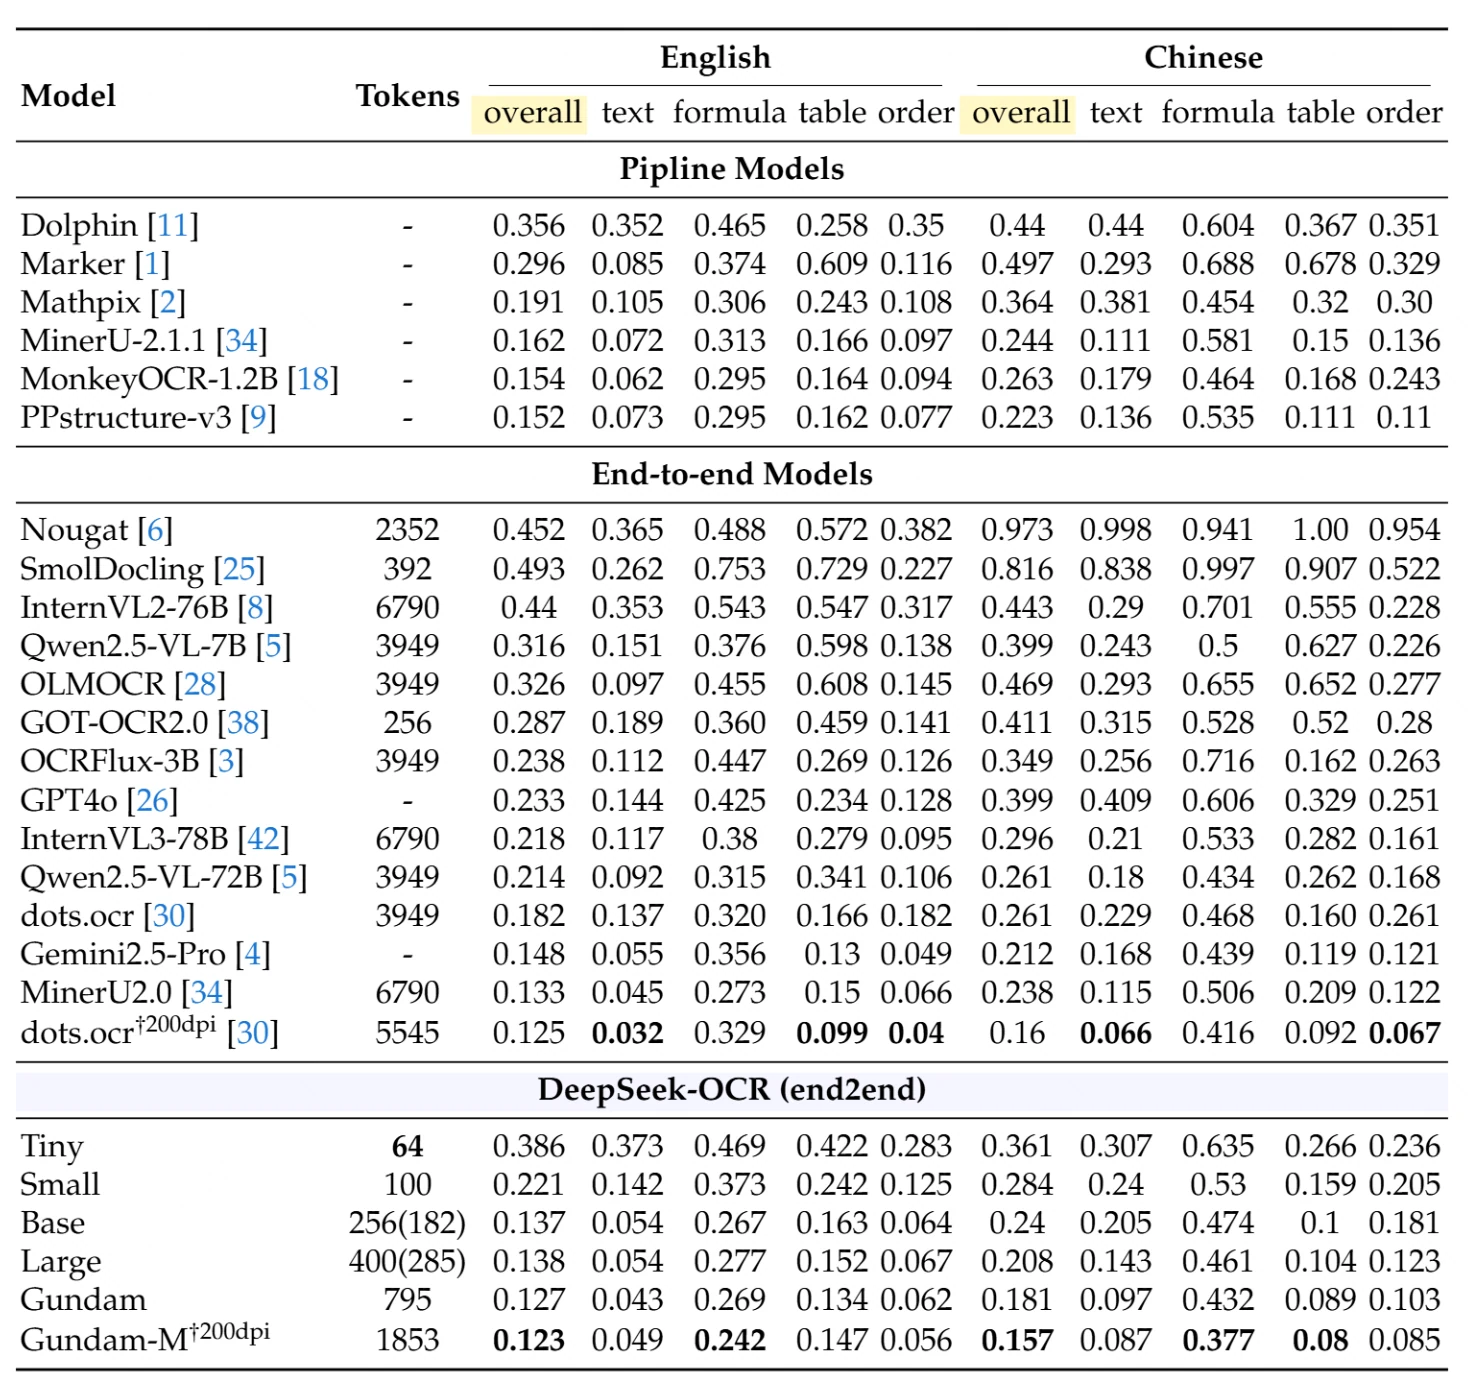
No OmniDocBench, um benchmark abrangente de análise de documentos, o DeepSeek-OCR alcança desempenho excepcional com uso mínimo de recursos. A tabela abaixo mostra comparações detalhadas entre diferentes tipos de documentos e idiomas (distância de edição - quanto menor, melhor):
Destaques Principais:
Modelos de Pipeline (abordagens tradicionais de múltiplas etapas): O modelo de pipeline com melhor desempenho, PPstructure-v3, atinge 0,152 geral em inglês e 0,223 em chinês, mas requer infraestrutura complexa de múltiplos modelos.
Modelos Ponto a Ponto (abordagens de modelo único): Entre os concorrentes, o MinerU2.0 usando 6.790 tokens atinge 0,133 em inglês e 0,238 em chinês. O Qwen2.5-VL-72B com 3.949 tokens pontua 0,214 em inglês e 0,261 em chinês.
Desempenho do DeepSeek-OCR:
- Modo Pequeno (100 tokens): 0,221 geral em inglês, 0,284 geral em chinês
- Modo Base (256 tokens): 0,137 geral em inglês, 0,240 geral em chinês
- Modo Gundam (795 tokens): 0,127 geral em inglês, 0,181 geral em chinês
- Gundam-M a 200dpi (1.853 tokens): 0,123 geral em inglês, 0,157 geral em chinês - alcançando resultados de estado da arte
Conquista Notável: O Modo Base do DeepSeek-OCR com apenas 256 tokens supera modelos que usam 15-26× mais tokens. O Modo Gundam-M alcança o melhor desempenho geral entre todos os modelos ponto a ponto, ainda usando significativamente menos tokens do que as abordagens tradicionais.
Desempenho por Categoria
Reconhecimento de Texto: DeepSeek-OCR (Gundam-M) atinge 0,049 em texto inglês e 0,087 em texto chinês, superando até mesmo o Gemini2.5-Pro.
Reconhecimento de Fórmulas: Com 0,242 em fórmulas inglesas e 0,377 em fórmulas chinesas, o DeepSeek-OCR demonstra forte capacidade em conteúdo matemático.
Extração de Tabelas: Pontuações de 0,147 em tabelas inglesas e 0,08 em tabelas chinesas mostram extração robusta de dados estruturados.
Capacidades de Produção
Velocidade de Processamento: Uma única GPU A100-40G pode processar mais de 200.000 páginas por dia. Escale para 20 nós (160 GPUs) e você terá 33 milhões de páginas por dia—o suficiente para as cargas de trabalho empresariais mais exigentes.
Eficiência de Custo: Para uma empresa que processa 1 milhão de páginas de documentos por mês, a diferença é gritante. Modelos tradicionais que exigem 6.000 tokens por página consomem 6 bilhões de tokens no total. DeepSeek-OCR a 800 tokens por página usa apenas 800 milhões de tokens—uma redução de 87% no uso de tokens e custos associados.
Principais Recursos e Capacidades
1. Suporte a Múltiplos Idiomas
O DeepSeek-OCR suporta quase 100 idiomas, desde os principais idiomas mundiais (inglês, chinês, espanhol, árabe, hindi) até escritas especializadas (tailandês, hebraico, cirílico). Isso elimina a necessidade de serviços de OCR específicos por idioma e simplifica as operações internacionais.
2. Entendimento Avançado de Documentos
O modelo reconhece muito mais do que apenas texto. Ele analisa gráficos em dados estruturados, extrai formulas matemáticas com formatação LaTeX, identifica figuras geométricas com saída SVG e mantém estruturas de tabelas incluindo celulas mescladas e formatação complexa.
3. Formatos de Saída Flexíveis
Escolha entre extração pura de texto (mais rápida), markdown com formatação preservada, HTML para integração web, ou JSON estruturado para processamento programático. O modo grounding preserva relações espaciais, garantindo que seus dados extraídos mantenham a estrutura do documento original.
4. Compressão Óptica para Contexo Longo
Armazene o histórico da conversa como imagems comprimidas emve de tokens de texto. Uma conversa de íc que tradionalmente consumiria 10.000 tokens de texto pode ser comprimida para 1.000 tokens de visão, permitindo aplicações com janelas de contexto ultra-longo a custos sustentáveis.
O Impacto: Aplicações de chat podem manter contexto ao longo de centenas de rodadas de conversa sem aumentos exponenciais de custo, permitindo interções de IA verdadeiramente longas.
Começando na Novita AI
Entendendo os Modos de Resolução
A Novita AI fornece o DeepSeek-OCR com cinco modos de resolução projetados para equilibrar desempenho, velocidade e custo para diferentes casos de uso.
Modos de Resolução Nativa:
Modo Tiny (512×512, 64 tokens): Otimizado para documentos simples onde a velocidade máxima é prioridade. Perfeito para recibos, formulários simples ou tarefas rápidas de extração de texto.
Modo Pequeno (640×640, 100 tokens): O ponto ideal para a maioria das aplicações. Oferece o melhor equilíbrio entre precisão, velocidade e custo. Ideal para documentos comerciais padrão, faturas e relatórios.
Modo Base (1024×1024, 256 tokens): Lida com layouts complexos com proporções preservadas usando preenchimento. Recomendado para contratos, relatórios detalhados e documentos onde o layout é importante.
Modo Grande (1280×1280, 400 tokens): Qualidade máxima para documentos detalhados de alta resolução. Melhor para artigos de pesquisa, documentos técnicos com fórmulas e requisitos de qualidade premium.
Modo de Resolução Dinâmica:
Modo Gundam (n×640×640 + 1×1024×1024, tokens variáveis): Tiling adaptável para documentos de altíssima resolução. Divide automaticamente imagens grandes em 2-9 visualizações locais a 640×640 mais uma visualização global a 1024×1024. Essencial para jornais, revistas e layouts complexos de múltiplas colunas. Para imagens menores que 640×640, ele degrada automaticamente para o Modo Base.
Acessando a API DeepSeek-OCR
A Novita AI fornece uma API REST simples para o DeepSeek-OCR. Para começar, cadastre-se em uma conta Novita AI e obtenha sua chave de API. O endpoint da API aceita URLs de imagem ou imagens codificadas em base64, juntamente com parâmetros de configuração como modo de resolução, preferência de idioma e formato de saída.
from openai import OpenAI

client = OpenAI(
    base_url="https://api.novita.ai/openai",
    api_key="<Sua Chave de API>",
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr",
    messages=[
      {
        "role": "user",
        "content": [
          {
            "type": "image_url",
            "image_url": {
              "url": "https://example.com/image.png"
            }
          },
          {
            "type": "text",
            "text": "<|grounding|>OCR esta imagem."
          }
        ]
      }
    ],
    stream=False,
    max_tokens=4096
)

content = response.choices[0].message.content

print(content)
Padrões Básicos de Uso
Para extração simples de texto onde a formatação não importa, use o modo “Free OCR”. Para análise estruturada de documentos que preserva layout, tabelas e formatação, use o modo “grounding” com saída markdown. Para análise avançada de gráficos, fórmulas ou figuras geométricas, use o prompt “Analise a figura”.
Guia de Resolução
Escolhendo o Modo Adequado
Para Faturas, Recibos e Formulários Simples: O Modo Pequeno (100 tokens) é sua melhor escolha. É rápdo, custo-efetivo e fornece precisão suficiente para extração de dados estruturados. Isso cobre a maioria das necessidades rotineiras de processamento de documentos comerciais.
Para Documentos Comerciais, Relatórios e Contratos: O Modo Base (256 tokens) lida bem com layouts complexos e preserva proporções com preenchimento. É o equilíbrio certo quando a estrutura do documento e a formatação são importantes.
Para Artigos de Pesquisa e Documentos Técnicos: O Modo Grande (400 tokens) fornece a precisão necessária para texto denso, fórmulas matemáticas e diagramas técnicos. A maior contagem de tokens é justificada pelos requisitos de precisão.
Para Jornais, Revistas e Layouts de Múltiplas Colunas: O Modo Gundam (tokens variáveis) é essencial. Seu tiling adaptável lida com altíssima resolução e layouts complexos de múltiplas colunas que seriam distorcidos em modos de resolução fixa. Embora use mais tokens, ainda é muito mais eficiente do que as abordagens tradicionais.
Insights de Desempenho por Tipo de Documento
Com base no teste abrangente do OmniDocBench:
Slides e Documentos Simples: Até o Modo Tiny (64 tokens) tem desempenho notável com distância de edição de 0,116 em slides, enquanto o Modo Pequeno oferece valor ideal. Isso porque os slides de apresentação geralmente têm layouts claros e texto limitado por página.
Livros e Documentos Padrão: O Modo Pequeno (100 tokens) oferece excelente valor com distância de edição de 0,085 em livros. A maioria dos livros contém 600-1.000 tokens de texto por página, bem dentro do ponto ideal de compressão 10×.
Artigos Acadêmicos: Modo Grande ou Modo Gundam são recomendados, com Gundam alcançando 0,039 de distância de edição em artigos académicos—superando modelos que usam 5-8× mais tokens.
Jornais: O Modo Gundam é essencial, alcançando 0,122 de distância de edição comparado a 0,940 do Modo Tiny. Jornais contêm 4.000-5.000 tokens de texto por página com layouts complexos de múltiplas colunas que exigem a abordagem de tiling adaptável.
Documentos com Muitas Fórmulas: Para documentos com fórmulas matemáticas, o Modo Gundam-M alcança o melhor desempenho com distância de edição de 0,242 em fórmulas inglesas, competitivo com grandes modelos especializados.
Entendendo o Modo Gundam em Detalhe
O modo Gundam funciona criando múltiplas visualizações locais (2-9 tiles a 640×640) que capturam regiões detalhadas, mais uma visualização global (1024×1024) que mantém o contexto geral. A contagem total de tokens é calculada como n×100 + 256, onde n é o número de tiles.
Quando usar o Modo Gundam: Use para imagens maiores que 1280 pixels em qualquer dimensão, documentos com layouts de múltiplas colunas, conteúdo com 4.000+ tokens de texto, ou infográficos complexos que precisam tanto de detralhes quanto de contexto.
Exemplo do mundo real: Uma pequena página de jornal pode usar 3 tiles (556 tokens no total), enquanto uma grande página de jornal usa 6 tiles (856 tokens). Compare isso com abordagens tradicionais que exigem 6.000+ tokens—você ainda está alcançando compressão de 7-10× mesmo nos documentos mais complexos.
Conclusão
O DeepSeek-OCR na Novita AI alcança compressão de 10× com 97% de precisão, reduzindo os custos de processamento de documentos em até 85%, enquanto suporta 100 idiomas e processa mais de 200.000 páginas por GPU por dia.
Os resultados falam por si: Empresas que processam 100.000 documentos mensalmente economizam mais de US$ 50.000 anualmente. As velocidades de processamento melhoram de 5 a 10×. A infraestrutura escala linearmente em vez de exponencialmente.
Pronto para transformar seu processamento de documentos?
**Comece Grátis no Playground →
Teste o DeepSeek-OCR com seus próprios documentos em minutos. Sem necessidade de cartão de crédito. Escolha entre cinco modos de resolução, processe documentos em 100 idiomas e experimente a compressão 10× em primeira mão.
Novita AI é uma plataforma líder de nuvem de IA que fornece aos desenvolvedores APIs fáceis de usar e infraestrutura GPU acessível e confiável para construir e escalar aplicações de IA.