DeepSeek-OCR liefert 10-fache Textkompression mit 97 % Genauigkeit, indem es Bilder als komprimierten Speicher für Text behandelt. Statt 1.000 Text-Token einzeln zu verarbeiten, werden sie als einzelnes Bild mit nur 100 Vision-Token verarbeitet – das senkt die Kosten um bis zu 85 %.
DeepSeek-OCR ist jetzt auf Novita AI verfügbar, verarbeitet über 200.000 Seiten pro Tag und GPU, unterstützt 100 Sprachen und bietet fünf Auflösungsmodi (64 bis über 400 Token). Es geht über traditionelle OCR hinaus, parst Diagramme in strukturierte Daten, erkennt chemische Formeln, extrahiert geometrische Figuren und ermöglicht ein innovatives Speichermanagement für lange Gespräche.
Jetzt im Novita AI Playground ausprobieren →
Auf der Suche nach der aktuellen Generation? DeepSeek hat seitdem DeepSeek-OCR 2 veröffentlicht, mit einem höheren OmniDocBench-Wert und besserer Lesereihenfolgen-Genauigkeit. Für neue Integrationen siehe DeepSeek OCR2 API Provider und verwende die Modell-ID
deepseek/deepseek-ocr-2.
Was ist DeepSeek-OCR?
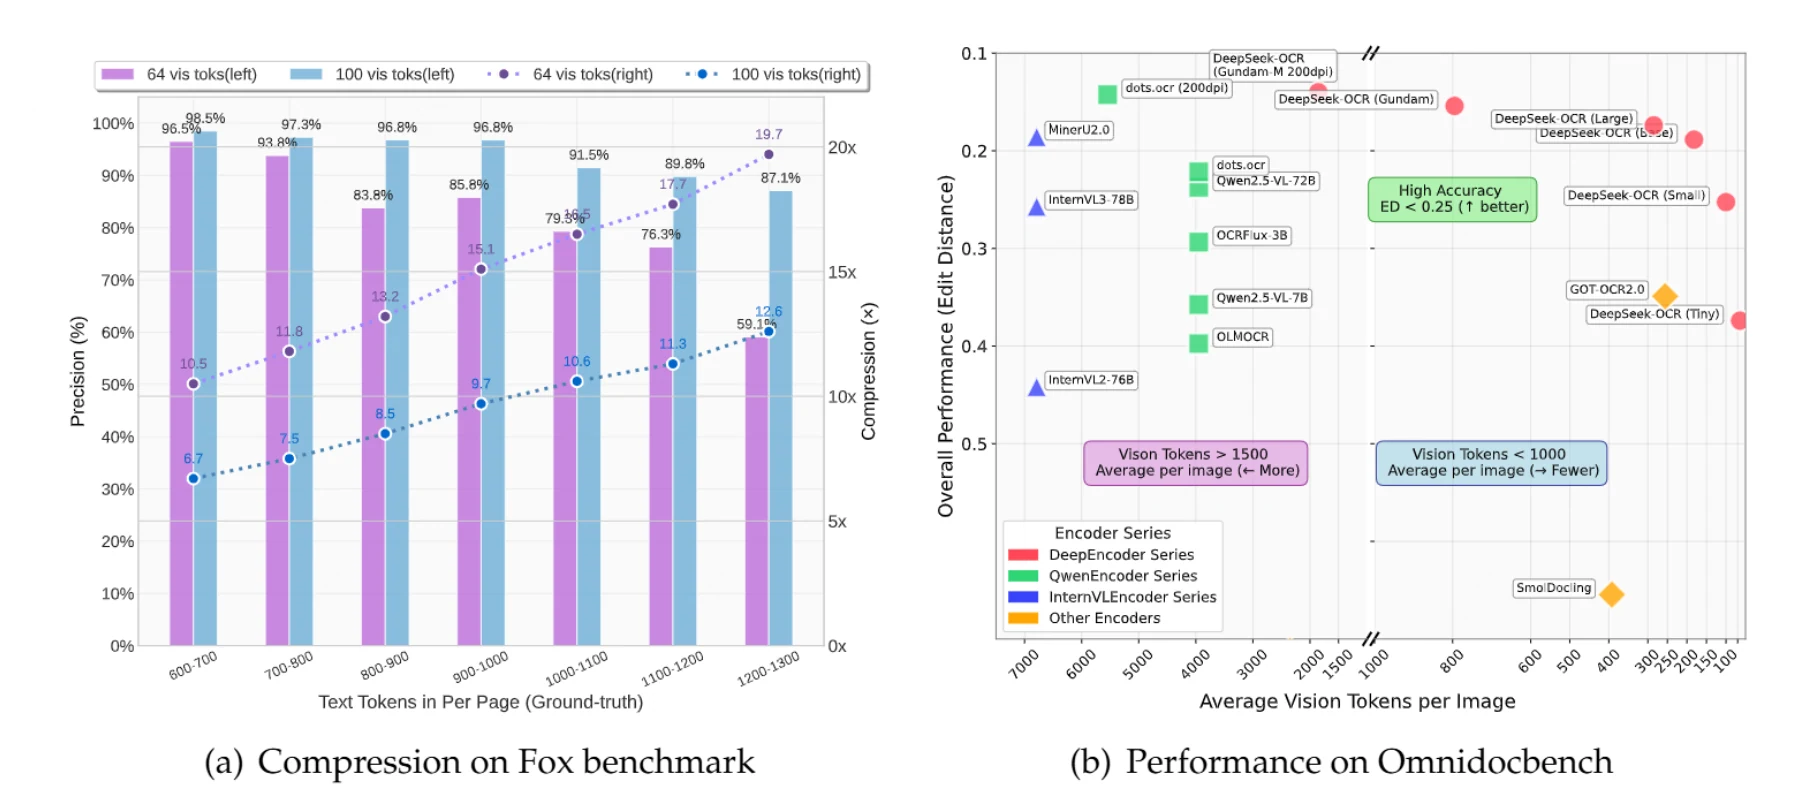
DeepSeek-OCR ist ein Vision-Language-Modell, das Bilder als komprimierten Speicher für Text behandelt. Anstatt ein Dokument mit 1.000 Text-Token einzeln zu verarbeiten (was rechenintensiv ist), verarbeitet das Modell es als einzelnes Bild mit nur 100 Vision-Token – eine 10-fache Reduzierung der Verarbeitungskosten.
Kernarchitektur
Das Modell besteht aus zwei Hauptkomponenten:
DeepEncoder (~380 Mio. Parameter): Ein spezialisierter Vision-Encoder, der Dokumentenbilder effizient mit einer einzigartigen seriellen Architektur verarbeitet, die Window-Attention (SAM) und globale Attention (CLIP) mit einer 16-fachen Kompressionsschicht dazwischen kombiniert.
DeepSeek3B-MoE-Decoder (570 Mio. aktive Parameter): Ein kompaktes Mixture-of-Experts-Sprachmodell, das komprimierte visuelle Informationen mit bemerkenswerter Genauigkeit wieder in Text umwandelt.
Diese Architektur ermöglicht eine beispiellose Effizienz bei der Dokumentenverarbeitung und ist ideal für Unternehmen, die große Mengen an Dokumenten verarbeiten, oder für Anwendungen, die ein langes Kontextverständnis erfordern.
Warum optische Kompression wichtig ist
Das traditionelle Problem
Die traditionelle Textverarbeitung in KI-Modellen skaliert quadratisch – die Verdoppelung der Dokumentenlänge kann die Kosten vervierfachen. Für Unternehmen, die täglich Tausende von Dokumenten verarbeiten, wird dies unerschwinglich teuer.
Die DeepSeek-OCR-Lösung
Dokumente mit bis zu 1.000 Text-Token können 10-fach mit 97 % Genauigkeit komprimiert werden. Selbst bei 20-facher Kompression bleibt die Genauigkeit bei etwa 60 % – oft ausreichend für viele Anwendungen.
Praxisbeispiel:
Ein Dokument mit 900 Text-Token erfordert traditionell 900 Token zur Verarbeitung. Mit DeepSeek-OCR im Small-Modus (100 Vision-Token) erreichen Sie 9,7-fache Kompression bei 96,8 % Genauigkeit. Bei Dokumenten mit 1.100 Text-Token erhalten Sie 10,6-fache Kompression bei 91,5 % Genauigkeit.
Geschäftliche Auswirkungen
Reduzierte API-Kosten: Bis zu 10-mal weniger verarbeitete Token für typische Dokumente bedeutet enorme Kosteneinsparungen – ein Unternehmen, das monatlich 1 Million Seiten verarbeitet, könnte jährlich über 50.000 $ sparen.
Schnellere Verarbeitung: Weniger Token führen direkt zu kürzeren Antwortzeiten, verbessern die Benutzererfahrung und ermöglichen Echtzeitanwendungen.
Bessere Skalierbarkeit: Verarbeiten Sie 10-mal mehr Dokumente mit der gleichen Infrastruktur-Investition, was das Wachstum planbarer und erschwinglicher macht.
Speichereffizienz: Speichern Sie Gesprächsverläufe als komprimierte Bilder, was Ultra-Lang-Kontext-Anwendungen ohne exponentielle Speicheranforderungen ermöglicht.
Leistung & Benchmarks
Umfassende OmniDocBench-Ergebnisse
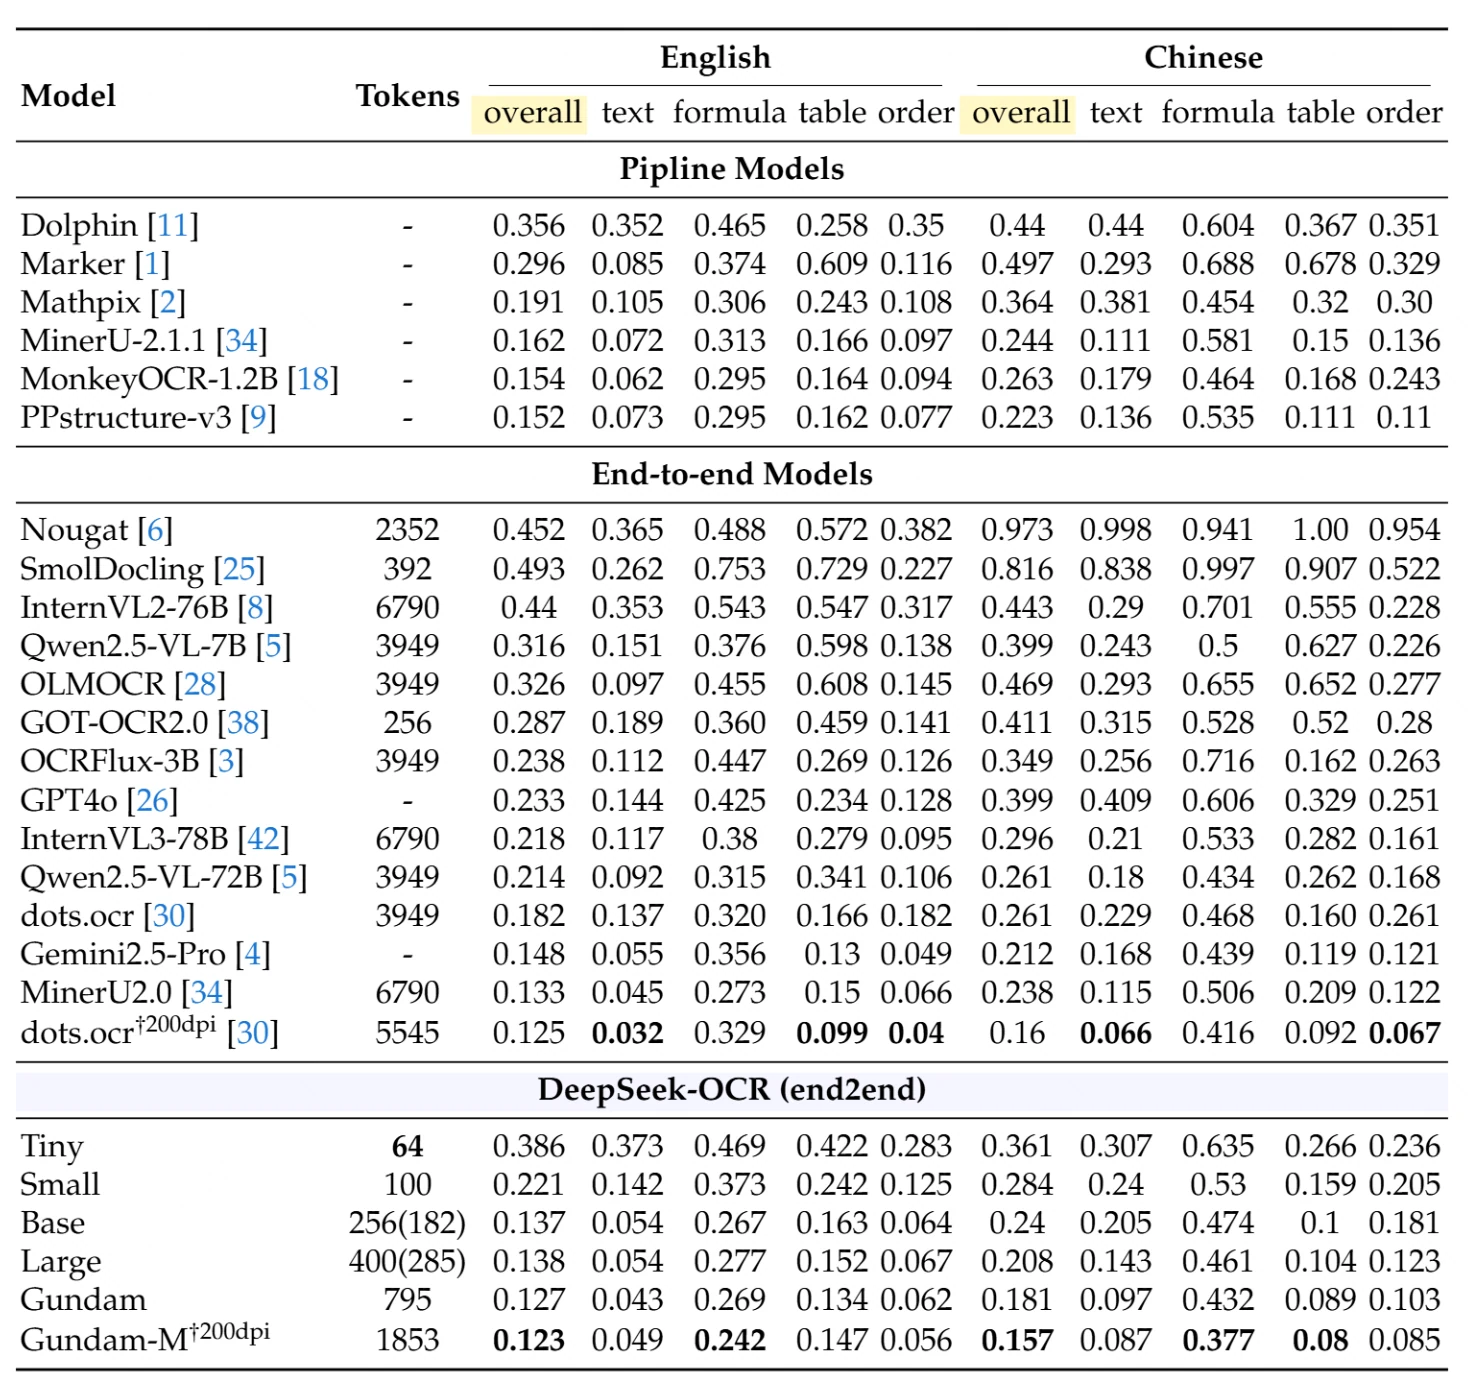
Auf OmniDocBench, einem umfassenden Benchmark für Dokumenten-Parsing, erzielt DeepSeek-OCR mit minimalem Ressourcenverbrauch außergewöhnliche Leistungen. Die folgende Tabelle zeigt detaillierte Vergleiche über verschiedene Dokumenttypen und Sprachen hinweg (Editierdistanz – niedriger ist besser):
Wichtige Highlights:
Pipeline-Modelle (traditionelle mehrstufige Ansätze): Das leistungsstärkste Pipeline-Modell, PPstructure-v3, erreicht insgesamt 0,152 bei Englisch und 0,223 bei Chinesisch, benötigt aber eine komplexe Multi-Modell-Infrastruktur.
End-to-End-Modelle (Ein-Modell-Ansätze): Unter den Mitbewerbern erreicht MinerU2.0 mit 6.790 Token 0,133 bei Englisch und 0,238 bei Chinesisch. Qwen2.5-VL-72B mit 3.949 Token erzielt 0,214 bei Englisch und 0,261 bei Chinesisch.
DeepSeek-OCR-Leistung:
- Small-Modus (100 Token): 0,221 Englisch gesamt, 0,284 Chinesisch gesamt
- Base-Modus (256 Token): 0,137 Englisch gesamt, 0,240 Chinesisch gesamt
- Gundam-Modus (795 Token): 0,127 Englisch gesamt, 0,181 Chinesisch gesamt
- Gundam-M bei 200 dpi (1.853 Token): 0,123 Englisch gesamt, 0,157 Chinesisch gesamt – erzielt State-of-the-Art-Ergebnisse
Bemerkenswerte Leistung: DeepSeek-OCRs Base-Modus mit nur 256 Token übertrifft Modelle, die 15- bis 26-mal mehr Token verwenden. Der Gundam-M-Modus erzielt die beste Gesamtleistung aller End-to-End-Modelle, während er immer noch deutlich weniger Token als traditionelle Ansätze verwendet.
Kategoriespezifische Leistung
Texterkennung: DeepSeek-OCR (Gundam-M) erreicht 0,049 bei englischem Text und 0,087 bei chinesischem Text und übertrifft sogar Gemini2.5-Pro.
Formelerkennung: Mit 0,242 bei englischen Formeln und 0,377 bei chinesischen Formeln zeigt DeepSeek-OCR eine starke Fähigkeit bei mathematischen Inhalten.
Tabellenextraktion: Ergebnisse von 0,147 bei englischen Tabellen und 0,08 bei chinesischen Tabellen zeigen eine robuste Extraktion strukturierter Daten.
Produktionsfähigkeiten
Verarbeitungsgeschwindigkeit: Eine einzelne A100-40G-GPU kann über 200.000 Seiten pro Tag verarbeiten. Skalieren Sie auf 20 Knoten (160 GPUs) und Sie erreichen 33 Millionen Seiten pro Tag – genug für die anspruchsvollsten Unternehmensworkloads.
Kosteneffizienz: Für ein Unternehmen, das 1 Million Dokumentseiten pro Monat verarbeitet, ist der Unterschied eklatant. Traditionelle Modelle, die 6.000 Token pro Seite benötigen, verbrauchen insgesamt 6 Milliarden Token. DeepSeek-OCR mit 800 Token pro Seite verwendet nur 800 Millionen Token – eine 87 % Reduzierung des Tokenverbrauchs und der damit verbundenen Kosten.
Hauptfunktionen & Fähigkeiten
1. Mehrsprachige Unterstützung
DeepSeek-OCR unterstützt fast 100 Sprachen, von großen Weltsprachen (Englisch, Chinesisch, Spanisch, Arabisch, Hindi) bis hin zu speziellen Schriften (Thailändisch, Hebräisch, Kyrillisch). Dies macht sprachspezifische OCR-Dienste überflüssig und vereinfacht internationale Abläufe.
2. Fortschrittliches Dokumentenverständnis
Das Modell erkennt weit mehr als nur Text. Es parst Diagramme in strukturierte Daten, extrahiert mathematische Formeln mit LaTeX-Formatierung, identifiziert geometrische Figuren mit SVG-Ausgabe und bewahrt Tabellenstrukturen einschließlich verbundener Zellen und komplexer Formatierung.
3. Flexible Ausgabeformate
Wählen Sie zwischen reiner Textextraktion (am schnellsten), Markdown mit erhaltener Formatierung, HTML für die Web-Integration oder strukturiertem JSON für die programmatische Verarbeitung. Der Grounding-Modus bewahrt räumliche Beziehungen und stellt sicher, dass Ihre extrahierten Daten die ursprüngliche Dokumentenstruktur beibehalten.
4. Optische Kompression für langen Kontext
Speichern Sie Gesprächsverläufe als komprimierte Bilder anstelle von Text-Token. Ein Gespräch mit 10 Runden, das traditionell 10.000 Token verbrauchen würde, kann auf 1.000 Vision-Token komprimiert werden, was Anwendungen mit ultra-langen Kontextfenstern zu nachhaltigen Kosten ermöglicht.
Die Auswirkung: Chat-Anwendungen können den Kontext über Hunderte von Gesprächsrunden hinweg aufrechterhalten, ohne exponentielle Kostensteigerungen, was wirklich lange KI-Interaktionen ermöglicht.
Erste Schritte auf Novita AI
Auflösungsmodi verstehen
Novita AI bietet DeepSeek-OCR mit fünf Auflösungsmodi, die Leistung, Geschwindigkeit und Kosten für verschiedene Anwendungsfälle ausbalancieren.
Native Auflösungsmodi:
Tiny-Modus (512×512, 64 Token): Optimiert für einfache Dokumente, bei denen maximale Geschwindigkeit Priorität hat. Perfekt für Quittungen, einfache Formulare oder schnelle Textextraktionsaufgaben.
Small-Modus (640×640, 100 Token): Der Sweet Spot für die meisten Anwendungen. Bietet die beste Balance aus Genauigkeit, Geschwindigkeit und Kosten. Ideal für Standard-Geschäftsdokumente, Rechnungen und Berichte.
Base-Modus (1024×1024, 256 Token): Bewältigt komplexe Layouts mit erhaltenden Seitenverhältnissen durch Padding. Empfohlen für Verträge, detaillierte Berichte und Dokumente, bei denen das Layout wichtig ist.
Large-Modus (1280×1280, 400 Token): Maximale Qualität für hochauflösende detaillierte Dokumente. Am besten geeignet für Forschungsarbeiten, technische Dokumente mit Formeln und Premium-Qualitätsanforderungen.
Dynamischer Auflösungsmodus:
Gundam-Modus (n×640×640 + 1×1024×1024, variable Token): Adaptives Kacheln für ultra-hochauflösende Dokumente. Teilt große Bilder automatisch in 2-9 lokale Ansichten bei 640×640 plus eine globale Ansicht bei 1024×1024. Unverzichtbar für Zeitungen, Zeitschriften und komplexe mehrspaltige Layouts. Für Bilder kleiner als 640×640 wird automatisch auf den Base-Modus zurückgegriffen.
Zugriff auf die DeepSeek-OCR-API
Novita AI bietet eine einfache REST-API für DeepSeek-OCR. Um loszulegen, melden Sie sich für ein Novita AI-Konto an und erhalten Sie Ihren API-Schlüssel. Der API-Endpunkt akzeptiert Bild-URLs oder base64-kodierte Bilder zusammen mit Konfigurationsparametern wie Auflösungsmodus, Sprachpräferenz und Ausgabeformat.
from openai import OpenAI

client = OpenAI(
    base_url="https://api.novita.ai/openai",
    api_key="<Ihr API-Schlüssel>",
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr",
    messages=[
      {
        "role": "user",
        "content": [
          {
            "type": "image_url",
            "image_url": {
              "url": "https://example.com/image.png"
            }
          },
          {
            "type": "text",
            "text": "<|grounding|>OCR dieses Bild."
          }
        ]
      }
    ],
    stream=False,
    max_tokens=4096
)

content = response.choices[0].message.content

print(content)
Grundlegende Nutzungsmuster
Für einfache Textextraktion, bei der die Formatierung keine Rolle spielt, verwenden Sie den „Free OCR"-Modus. Für strukturiertes Dokumenten-Parsing, das Layout, Tabellen und Formatierung bewahrt, verwenden Sie den „Grounding"-Modus mit Markdown-Ausgabe. Für fortgeschrittenes Parsen von Diagrammen, Formeln oder geometrischen Figuren verwenden Sie die Aufforderung „Parse the figure".
Auflösungsleitfaden
Den richtigen Modus wählen
Für Rechnungen, Quittungen und einfache Formulare: Der Small-Modus (100 Token) ist Ihre beste Wahl. Er ist schnell, kostengünstig und bietet ausreichende Genauigkeit für die Extraktion strukturierter Daten. Dies deckt die meisten routinemäßigen Geschäftsdokumentenverarbeitungsanforderungen ab.
Für Geschäftsdokumente, Berichte und Verträge: Der Base-Modus (256 Token) bewältigt komplexe Layouts gut und bewahrt Seitenverhältnisse mit Padding. Er ist die richtige Balance, wenn Dokumentenstruktur und Formatierung wichtig sind.
Für Forschungsarbeiten und technische Dokumente: Der Large-Modus (400 Token) bietet die erforderliche Genauigkeit für dichten Text, mathematische Formeln und technische Diagramme. Die höhere Tokenanzahl ist durch die Präzisionsanforderungen gerechtfertigt.
Für Zeitungen, Zeitschriften und mehrspaltige Layouts: Der Gundam-Modus (variable Token) ist unverzichtbar. Sein adaptives Kacheln bewältigt ultra-hohe Auflösungen und komplexe mehrspaltige Layouts, die in Modellen mit fester Auflösung verstümmelt würden. Obwohl er mehr Token verwendet, ist er immer noch weitaus effizienter als traditionelle Ansätze.
Leistungseinblicke nach Dokumenttyp
Basierend auf den umfassenden OmniDocBench-Tests:
Folien und einfache Dokumente: Selbst der Tiny-Modus (64 Token) schneidet mit einer Editierdistanz von 0,116 bei Folien bemerkenswert gut ab, während der Small-Modus das optimale Preis-Leistungs-Verhältnis bietet. Dies liegt daran, dass Präsentationsfolien typischerweise klare Layouts und begrenzten Text pro Seite haben.
Bücher und Standarddokumente: Der Small-Modus (100 Token) bietet mit einer Editierdistanz von 0,085 bei Büchern ein hervorragendes Preis-Leistungs-Verhältnis. Die meisten Bücher enthalten 600–1.000 Text-Token pro Seite, was gut im Sweet Spot der 10-fachen Kompression liegt.
Akademische Arbeiten: Der Large-Modus oder Gundam-Modus wird empfohlen, wobei Gundam eine Editierdistanz von 0,039 bei akademischen Arbeiten erreicht – und damit Modelle übertrifft, die 5- bis 8-mal mehr Token verwenden.
Zeitungen: Der Gundam-Modus ist unverzichtbar, erreicht eine Editierdistanz von 0,122 im Vergleich zu 0,940 beim Tiny-Modus. Zeitungen enthalten 4.000–5.000 Text-Token pro Seite mit komplexen mehrspaltigen Layouts, die den adaptiven Kachelansatz erfordern.
Formellastige Dokumente: Für Dokumente mit mathematischen Formeln erreicht der Gundam-M-Modus die beste Leistung mit einer Editierdistanz von 0,242 bei englischen Formeln, konkurrenzfähig mit spezialisierten großen Modellen.
Gundam-Modus im Detail
Der Gundam-Modus erstellt mehrere lokale Ansichten (2–9 Kacheln bei 640×640), die detaillierte Regionen erfassen, sowie eine globale Ansicht (1024×1024), die den Gesamtkontext bewahrt. Die Gesamtzahl der Token berechnet sich als n×100 + 256, wobei n die Anzahl der Kacheln ist.
Wann sollte der Gundam-Modus verwendet werden: Verwenden Sie ihn für Bilder, die in einer Abmessung größer als 1280 Pixel sind, Dokumente mit mehrspaltigen Layouts, Inhalte mit 4.000+ Text-Token oder komplexe Infografiken, die sowohl Detail als auch Kontext benötigen.
Praxisbeispiel: Eine kleine Zeitungsseite könnte 3 Kacheln (insgesamt 556 Token) verwenden, während eine große Zeitungsseite 6 Kacheln (856 Token) verwendet. Vergleichen Sie dies mit traditionellen Ansätzen, die 6.000+ Token erfordern – Sie erreichen selbst bei den komplexesten Dokumenten immer noch eine 7- bis 10-fache Kompression.
Fazit
DeepSeek-OCR auf Novita AI erreicht 10-fache Kompression mit 97 % Genauigkeit, senkt die Kosten für die Dokumentenverarbeitung um bis zu 85 % und unterstützt 100 Sprachen bei einer Verarbeitung von über 200.000 Seiten pro GPU und Tag.
Die Ergebnisse sprechen für sich: Unternehmen, die monatlich 100.000 Dokumente verarbeiten, sparen jährlich über 50.000 $. Die Verarbeitungsgeschwindigkeit verbessert sich um das 5- bis 10-fache. Die Infrastruktur skaliert linear statt exponentiell.
Bereit, Ihre Dokumentenverarbeitung zu transformieren?
Kostenlos im Playground starten →
Testen Sie DeepSeek-OCR in Minuten mit Ihren eigenen Dokumenten. Keine Kreditkarte erforderlich. Wählen Sie aus fünf Auflösungsmodi, verarbeiten Sie Dokumente in 100 Sprachen und erleben Sie die 10-fache Kompression aus erster Hand.
Novita AI ist eine führende KI-Cloud-Plattform, die Entwicklern benutzerfreundliche APIs und erschwingliche, zuverlässige GPU-Infrastruktur zum Erstellen und Skalieren von KI-Anwendungen bietet.