يوفّر DeepSeek-OCR ضغطًا نصيًا بمعدل 10× وبدقة 97% من خلال التعامل مع الصور كوحدة تخزين مضغوطة للنصوص. فبدلًا من معالجة 1000 رمز نصي على حدة، يعالجها كصورة واحدة باستخدام 100 رمز رؤية فقط، مما يقلل التكاليف بنسبة تصل إلى 85%.
متاح الآن على Novita AI، يعالج DeepSeek-OCR أكثر من 200,000 صفحة يوميًا لكل GPU، ويدعم 100 لغة، ويوفّر خمسة أوضاع دقة (من 64 إلى أكثر من 400 رمز). ويتجاوز OCR التقليدي ليحلّل الرسوم البيانية إلى بيانات منظمة، ويتعرّف على الصيغ الكيميائية، ويستخرج الأشكال الهندسية، ويمكّن من إدارة ذاكرة مبتكرة للمحادثات الطويلة.
جرّبه الآن في Novita AI Playground →
هل تبحث عن الجيل الحالي؟ أصدرت DeepSeek منذ ذلك الحين DeepSeek-OCR 2، بدرجة أعلى في OmniDocBench ودقة أفضل في ترتيب القراءة. للدمج الجديد، راجع موفّر DeepSeek OCR2 API واستخدم معرّف الطراز
deepseek/deepseek-ocr-2.
ما هو DeepSeek-OCR؟
DeepSeek-OCR هو نموذج لغة-رؤية يتعامل مع الصور كوحدة تخزين مضغوطة للنصوص. فبدلًا من معالجة مستند يحتوي على 1000 رمز نصي على حدة (وهو أمر مكلف حسابيًا)، يعالج النموذج المستند كصورة واحدة باستخدام 100 رمز رؤية فقط—أي انخفاض بمقدار 10× في تكاليف المعالجة.
البنية الأساسية
يتكوّن النموذج من مكوّنين رئيسيين:
DeepEncoder (نحو 380M معامل): مُشفّر رؤية متخصص يعالج صور المستندات بكفاءة عبر بنية تسلسلية فريدة تجمع بين الانتباه النافذ (SAM) والانتباه العام (CLIP) وطبقة ضغط بمعدل 16× بينهما.
وحدة فك ترميز DeepSeek3B-MoE (570M معامل نشط): نموذج لغوي مدمج يعتمد على خليط من الخبراء (Mixture of Experts) يحوّل المعلومات المرئية المضغوطة إلى نص بدقة ملحوظة.
تتيح هذه البنية كفاءة غير مسبوقة في معالجة المستندات، ما يجعلها مثالية للشركات التي تتعامل مع كميات كبيرة من المستندات أو التطبيقات التي تتطلب فهمًا للسياقات الطويلة.
لماذا يهم الضغط البصري؟
المشكلة التقليدية
تتوسّع معالجة النصوص التقليدية في نماذج الذكاء الاصطناعي بشكل تربيعي—مضاعفة طول مستندك قد تضاعف تكاليفك أربع مرات. وبالنسبة للشركات التي تعالج آلاف المستندات يوميًا، يصبح هذا مكلفًا للغاية.
حل DeepSeek-OCR
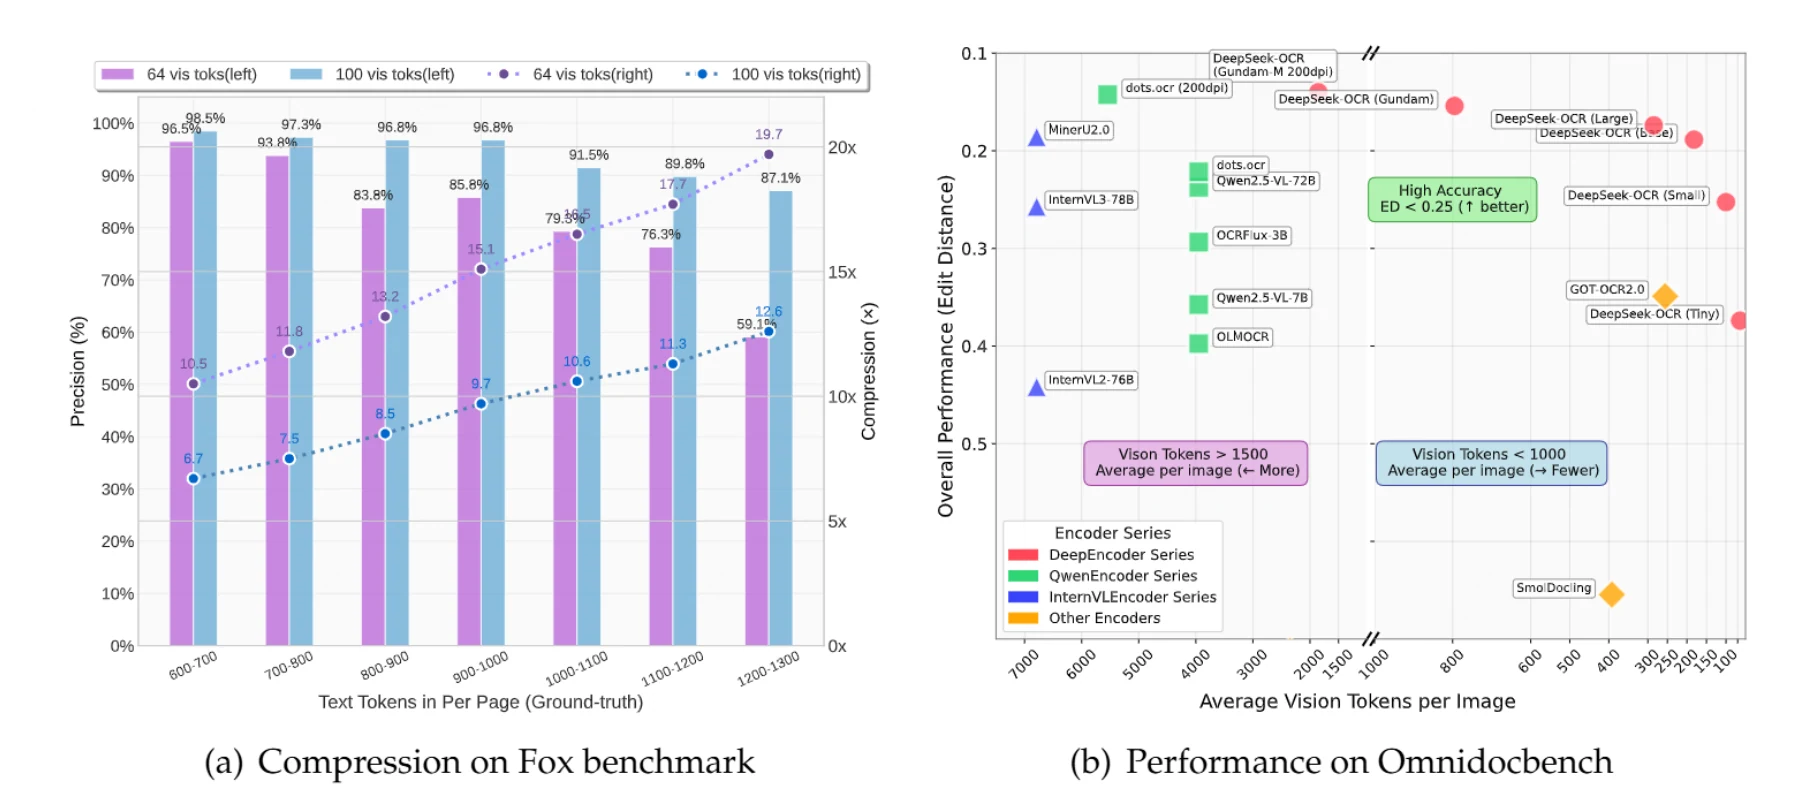
يمكن ضغط المستندات التي تحتوي حتى 1000 رمز نصي بمعدل 10× مع دقة 97%. حتى عند الضغط بمعدل 20×، تبقى الدقة نحو 60%—وهو ما يكفي غالبًا للعديد من التطبيقات.
مثال واقعي:
المستند الذي يحتوي على 900 رمز نصي يتطلب معالجة 900 رمز تقليديًا. باستخدام DeepSeek-OCR مع وضع Small (100 رمز رؤية) تحقق ضغطًا بمعدل 9.7× ودقة 96.8%. أما المستندات التي تحتوي على 1,100 رمز نصي، فتحقق ضغطًا بمعدل 10.6× ودقة 91.5%.
الأثر على الأعمال
انخفاض تكاليف API: معالجة رموز أقل بمقدار يصل إلى 10× في المستندات النموذجية تعني توفيرًا كبيرًا في التكاليف—فالشركة التي تعالج مليون صفحة شهريًا يمكنها توفير أكثر من 50,000 دولار سنويًا.
معالجة أسرع: عدد أقل من الرموز يترجم مباشرة إلى أوقات استجابة أسرع، مما يحسّن تجربة المستخدم ويتيح تطبيقات فورية.
قابلية توسّع أفضل: تعامل مع مستندات أكثر بمقدار 10× باستخدام الاستثمار نفسه في البنية التحتية، مما يجعل النمو أكثر قابلية للتنبؤ وأقل تكلفة.
كفاءة الذاكرة: خزّن سجل المحادثات كصور مضغوطة، مما يتيح تطبيقات سياق فائق الطول دون متطلبات ذاكرة أسّية.
الأداء والمعايير
نتائج OmniDocBench الشاملة
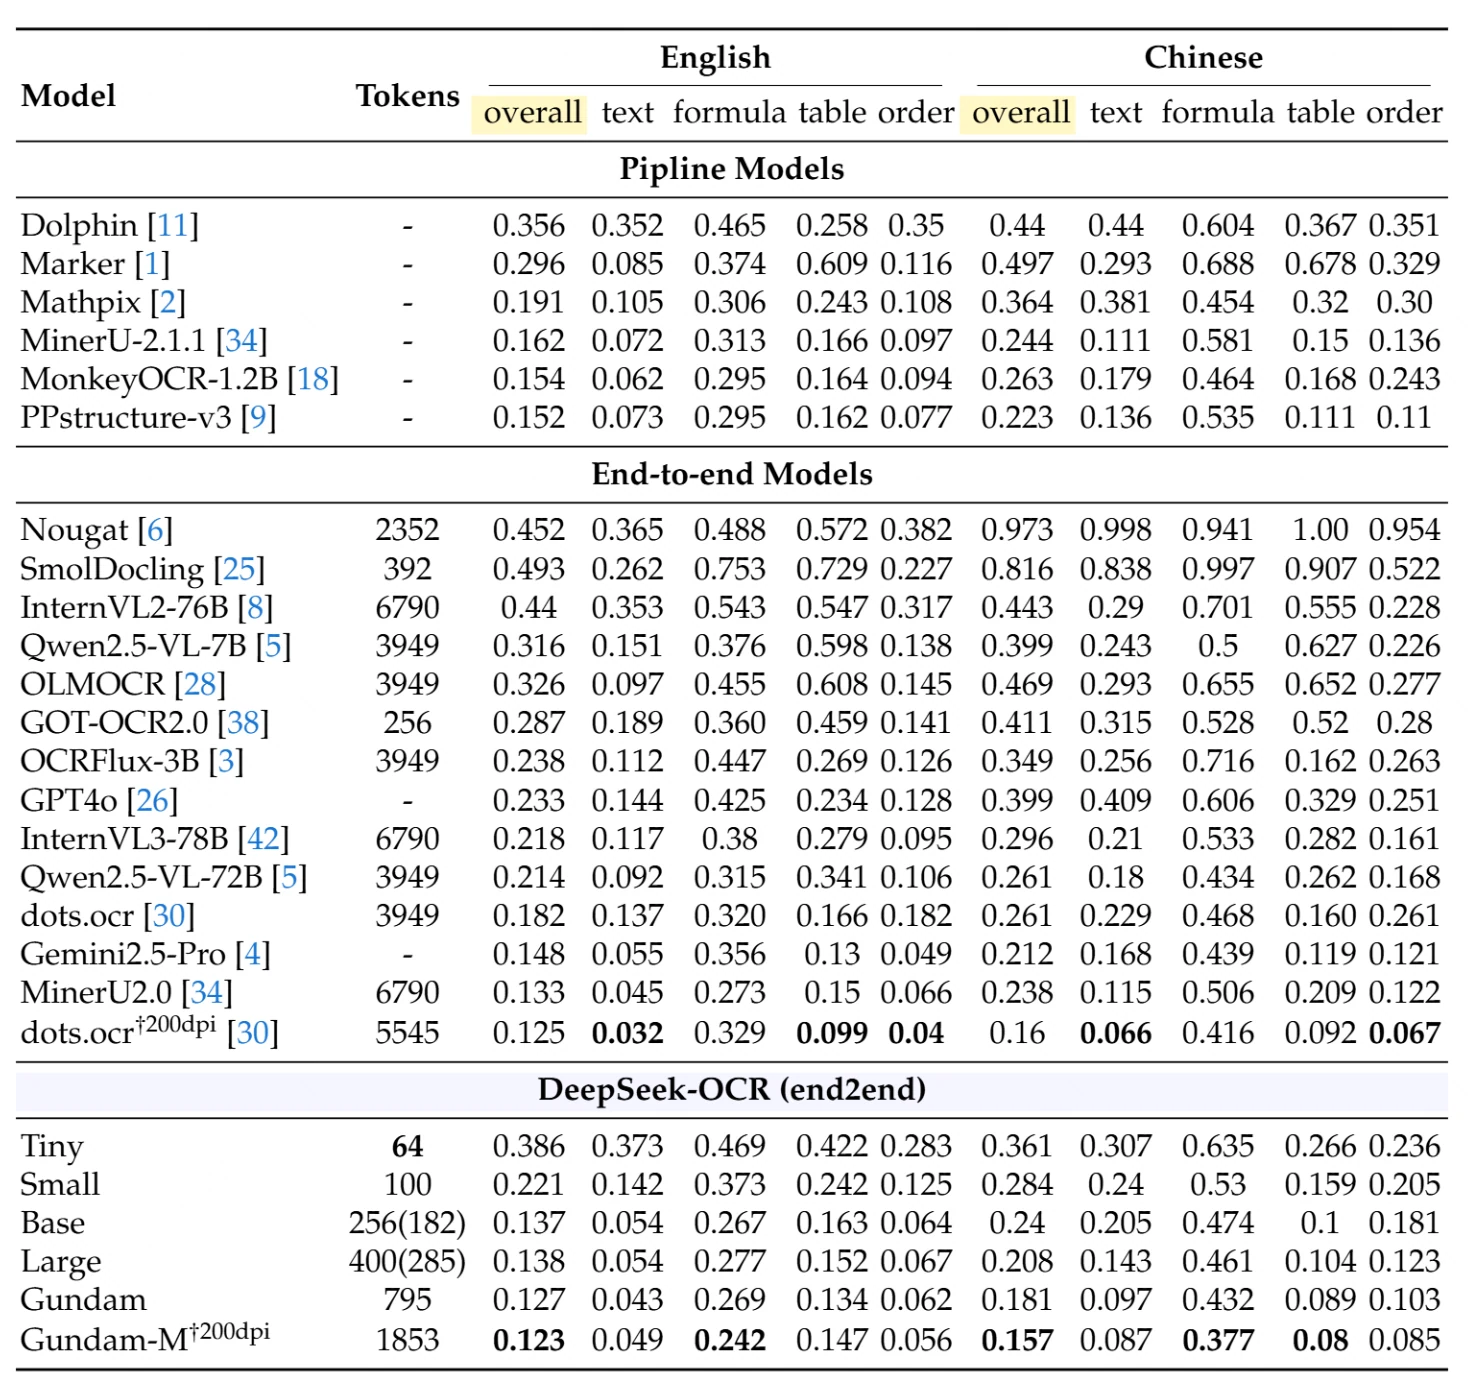
على OmniDocBench، وهو معيار شامل لتحليل المستندات، يحقق DeepSeek-OCR أداءً استثنائيًا مع استخدام ضئيل للموارد. يعرض الجدول أدناه مقارنات مفصّلة عبر أنواع ولغات مختلفة من المستندات (مسافة التحرير - كلما قلّت كان أفضل):
أبرز النقاط:
نماذج خطوط المعالجة (المناهج التقليدية متعددة المراحل): أفضل نموذج في هذه الفئة، PPstructure-v3، يحقق 0.152 إجمالًا على الإنجليزية و0.223 على الصينية، لكنه يتطلب بنية تحتية معقدة متعددة النماذج.
النماذج من البداية إلى النهاية (مناهج نموذج واحد): بين المنافسين، يحقق MinerU2.0 باستخدام 6,790 رمزًا نتيجة 0.133 على الإنجليزية و0.238 على الصينية. أما Qwen2.5-VL-72B الذي يستخدم 3,949 رمزًا فيسجّل 0.214 على الإنجليزية و0.261 على الصينية.
أداء DeepSeek-OCR:
- الوضع الصغير (100 رمز): 0.221 إجمالًا على الإنجليزية، 0.284 إجمالًا على الصينية
- الوضع الأساسي (256 رمزًا): 0.137 إجمالًا على الإنجليزية، 0.240 إجمالًا على الصينية
- وضع Gundam (795 رمزًا): 0.127 إجمالًا على الإنجليزية، 0.181 إجمالًا على الصينية
- وضع Gundam-M بدقة 200 نقطة في البوصة (1,853 رمزًا): 0.123 إجمالًا على الإنجليزية، 0.157 إجمالًا على الصينية — يحقق أفضل النتائج في فئته
إنجاز ملحوظ: يتفوّق وضع Base في DeepSeek-OCR بـ256 رمزًا فقط على نماذج تستخدم رموزًا أكثر بمعدل 15-26×. ويحقق وضع Gundam-M أفضل أداء شامل بين جميع النماذج من البداية إلى النهاية، بينما لا يزال يستخدم رموزًا أقل بكثير من المناهج التقليدية.
الأداء حسب الفئة
التعرّف على النصوص: يحقق DeepSeek-OCR (Gundam-M) 0.049 على النص الإنجليزي و0.087 على النص الصيني، متفوّقًا حتى على Gemini2.5-Pro.
التعرّف على الصيغ: مع 0.242 على الصيغ الإنجليزية و0.377 على الصيغ الصينية، يُظهر DeepSeek-OCR قدرة قوية على المحتوى الرياضي.
استخراج الجداول: درجات 0.147 على الجداول الإنجليزية و0.08 على الجداول الصينية تُظهر استخراجًا قويًا للبيانات المنظمة.
قدرات الإنتاج
سرعة المعالجة: يمكن لوحدة GPU واحدة من نوع A100-40G معالجة أكثر من 200,000 صفحة يوميًا. وعند التوسّع إلى 20 عقدة (160 GPU)، تصل إلى 33 مليون صفحة يوميًا—وهو ما يكفي لأثقل أعباء العمل المؤسسية.
كفاءة التكلفة: بالنسبة لشركة تعالج مليون صفحة مستندات شهريًا، يكون الفرق كبيرًا. النماذج التقليدية التي تتطلب 6000 رمز لكل صفحة تستهلك 6 مليارات رمز إجمالًا. أما DeepSeek-OCR بمعدل 800 رمز لكل صفحة فيستخدم 800 مليون رمز فقط—أي انخفاض بنسبة 87% في استخدام الرموز والتكاليف المرتبطة.
الميزات والقدرات الرئيسية
1. دعم متعدد اللغات
يدعم DeepSeek-OCR نحو 100 لغة، من لغات العالم الرئيسية (الإنجليزية، الصينية، الإسبانية، العربية، الهندية) إلى النصوص المتخصصة (التايلاندية، العبرية، السيريلية). وهذا يلغي الحاجة إلى خدمات OCR خاصة بكل لغة ويبسّط العمليات الدولية.
2. فهم متقدم للمستندات
يتعرّف النموذج على أكثر بكثير من النصوص فقط. فهو يحلّل الرسوم البيانية إلى بيانات منظمة، ويستخرج الصيغ الرياضية بتنسيق LaTeX، ويحدد الأشكال الهندسية مع إخراج SVG، ويحافظ على بنية الجداول بما في ذلك الخلايا المدمجة والتنسيقات المعقدة.
3. صيغ إخراج مرنة
اختر بين استخراج النص الخالص (الأسرع)، أو Markdown مع الحفاظ على التنسيق، أو HTML للتكامل مع الويب، أو JSON منظم للمعالجة البرمجية. يحافظ وضع grounding على العلاقات المكانية، ما يضمن أن بياناتك المستخرجة تحتفظ ببنية المستند الأصلي.
4. الضغط البصري للسياق الطويل
خزّن سجل المحادثة كصور مضغوطة بدلًا من رموز نصية. محادثة من 10 جولات كانت ستستهلك تقليديًا 10,000 رمز يمكن ضغطها إلى 1,000 رمز رؤية، ما يتيح تطبيقات بنوافذ سياق فائقة الطول بتكاليف مستدامة.
الأثر: يمكن لتطبيقات الدردشة الحفاظ على السياق عبر مئات جولات المحادثة دون زيادات أسّية في التكلفة، ما يتيح تفاعلات ذكاء اصطناعي طويلة حقًا.
البدء مع Novita AI
فهم أوضاع الدقة
توفّر Novita AI DeepSeek-OCR مع خمسة أوضاع للدقة مصممة لتحقيق التوازن بين الأداء والسرعة والتكلفة لحالات استخدام مختلفة.
أوضاع الدقة الأصلية:
الوضع الصغير جدًا (Tiny Mode) (512×512، 64 رمزًا): محسّن للمستندات البسيطة حيث تكون السرعة القصوى أولوية. مثالي للإيصالات أو النماذج البسيطة أو مهام استخراج النص السريعة.
الوضع الصغير (Small Mode) (640×640، 100 رمز): النقطة المثالية لمعظم التطبيقات. يوفّر أفضل توازن بين الدقة والسرعة والتكلفة. مثالي للمستندات التجارية القياسية والفواتير والتقارير.
الوضع الأساسي (Base Mode) (1024×1024، 256 رمزًا): يعالج التخطيطات المعقدة مع الحفاظ على أبعاد الصورة باستخدام الحشو. موصى به للعقود والتقارير المفصّلة والمستندات التي يهم فيها التخطيط.
الوضع الكبير (Large Mode) (1280×1280، 400 رمز): جودة قصوى للمستندات التفصيلية عالية الدقة. مثالي للأوراق البحثية والمستندات التقنية ذات الصيغ ومتطلبات الجودة الفائقة.
وضع الدقة الديناميكي:
وضع Gundam (n×640×640 + 1×1024×1024، رموز متغيرة): تقسيم تكيفي للمستندات فائقة الدقة. يقسّم الصور الكبيرة تلقائيًا إلى 2-9 عروض محلية بدقة 640×640 بالإضافة إلى عرض عام واحد بدقة 1024×1024. أساسي للصحف والمجلات والتخطيطات المعقدة متعددة الأعمدة. بالنسبة للصور الأصغر من 640×640، يتحوّل تلقائيًا إلى الوضع الأساسي.
الوصول إلى DeepSeek-OCR API
توفّر Novita AI واجهة REST API بسيطة لـ DeepSeek-OCR. للبدء، سجّل للحصول على حساب في Novita AI واحصل على مفتاح API الخاص بك. تقبل نقطة النهاية الخاصة بواجهة البرمجة عناوين URL للصور أو صورًا بترميز base64 مع معاملات إعداد مثل وضع الدقة وتفضيل اللغة وصيغة الإخراج.
from openai import OpenAI

client = OpenAI(
    base_url="https://api.novita.ai/openai",
    api_key="<Your API Key>",
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr",
    messages=[
      {
        "role": "user",
        "content": [
          {
            "type": "image_url",
            "image_url": {
              "url": "https://example.com/image.png"
            }
          },
          {
            "type": "text",
            "text": "<|grounding|>OCR this image."
          }
        ]
      }
    ],
    stream=False,
    max_tokens=4096
)

content = response.choices[0].message.content

print(content)
أنماط الاستخدام الأساسية
لاستخراج نص بسيط لا يهم معه التنسيق، استخدم وضع “Free OCR”. ولتحليل مستندات منظم يحافظ على التخطيط والجداول والتنسيق، استخدم وضع “grounding” مع إخراج Markdown. وللتحليل المتقدم للرسوم البيانية أو الصيغ أو الأشكال الهندسية، استخدم المطالبة النصية “Parse the figure”.
دليل الدقة
اختيار الوضع المناسب
للفواتير والإيصالات والنماذج البسيطة: الوضع Small (100 رمز) هو خيارك الأفضل. إنه سريع وفعّال من حيث التكلفة ويوفّر دقة كافية لاستخراج البيانات المنظمة. ويغطي معظم احتياجات معالجة مستندات الأعمال الروتينية.
لمستندات الأعمال والتقارير والعقود: يتعامل الوضع Base (256 رمزًا) جيدًا مع التخطيطات المعقدة ويحافظ على أبعاد الصورة باستخدام الحشو. إنه التوازن الصحيح عندما تكون بنية المستند وتنسيقه مهمين.
للأوراق البحثية والمستندات التقنية: يوفّر الوضع Large (400 رمز) الدقة اللازمة للنصوص الكثيفة والصيغ الرياضية والمخططات التقنية. عدد الرموز الأعلى مبرر بمتطلبات الدقة.
للصحف والمجلات والتخطيطات متعددة الأعمدة: وضع Gundam (رموز متغيرة) أساسي. فالتقسيم التكيفي الخاص به يعالج الدقة فائقة الارتفاع والتخطيطات المعقدة متعددة الأعمدة التي قد تتعطّل في أوضاع الدقة الثابتة. ورغم أنه يستخدم رموزًا أكثر، فإنه ما يزال أكثر كفاءة بكثير من المناهج التقليدية.
رؤى الأداء حسب نوع المستند
استنادًا إلى اختبارات OmniDocBench الشاملة:
الشرائح والمستندات البسيطة: حتى الوضع Tiny (64 رمزًا) يعمل بشكل ملحوظ مع مسافة تحرير تبلغ 0.116 على الشرائح، بينما يقدم الوضع Small أفضل قيمة. ويعود ذلك إلى أن شرائح العرض عادةً ما تكون بتخطيطات واضحة ونص محدود في كل صفحة.
الكتب والمستندات القياسية: يقدّم الوضع Small (100 رمز) قيمة ممتازة بمسافة تحرير تبلغ 0.085 للكتب. تحتوي معظم الكتب على 600-1,000 رمز نصي لكل صفحة، وهو ما يقع ضمن النطاق المثالي للضغط بمعدل 10×.
الأوراق الأكاديمية: يُنصح باستخدام الوضع Large أو وضع Gundam، حيث يحقق Gundam مسافة تحرير 0.039 على الأوراق الأكاديمية—متفوقًا على نماذج تستخدم رموزًا أكثر بمعدل 5-8×.
الصحف: وضع Gundam أساسي، إذ يحقق مسافة تحرير 0.122 مقارنةً بـ0.940 للوضع Tiny. تحتوي الصحف على 4,000-5,000 رمز نصي في الصفحة الواحدة مع تخطيطات معقدة متعددة الأعمدة تتطلب أسلوب التقسيم التكيفي.
المستندات المليئة بالصيغ: بالنسبة للمستندات ذات الصيغ الرياضية، يحقق وضع Gundam-M أفضل أداء بمسافة تحرير 0.242 على الصيغ الإنجليزية، وهو منافس للنماذج الكبيرة المتخصصة.
فهم وضع Gundam بالتفصيل
يعمل وضع Gundam عن طريق إنشاء عروض محلية متعددة (2-9 مربعات بدقة 640×640) تلتقط المناطق التفصيلية، بالإضافة إلى عرض عام واحد (1024×1024) يحافظ على السياق العام. يُحسب إجمالي عدد الرموز بالمعادلة n×100 + 256، حيث n هو عدد المربعات.
متى تستخدم وضع Gundam: استخدمه للصور الأكبر من 1280 بكسل في أي بُعد، أو المستندات ذات التخطيطات متعددة الأعمدة، أو المحتوى الذي يحتوي على أكثر من 4,000 رمز نصي، أو الرسوم البيانية المعقدة التي تحتاج إلى التفاصيل والسياق معًا.
مثال واقعي: قد تستخدم صفحة صحيفة صغيرة 3 مربعات (556 رمزًا إجمالًا)، بينما تستخدم صفحة صحيفة كبيرة 6 مربعات (856 رمزًا). قارن هذا بالمناهج التقليدية التي تتطلب أكثر من 6,000 رمز—ما تزال تحقق ضغطًا بمعدل 7-10× حتى على أكثر المستندات تعقيدًا.
الخلاصة
يحقق DeepSeek-OCR على Novita AI ضغطًا بمعدل 10× مع دقة 97%، ويخفض تكاليف معالجة المستندات بنسبة تصل إلى 85% مع دعم 100 لغة ومعالجة أكثر من 200,000 صفحة لكل GPU يوميًا.
النتائج تتحدث عن نفسها: الشركات التي تعالج 100,000 مستند شهريًا توفّر أكثر من 50,000 دولار سنويًا. سرعات المعالجة تتحسّن بمعدل 5-10×. البنية التحتية تتوسّع خطيًا بدلًا من الأسّي.
هل أنت مستعد لتحويل معالجة مستنداتك؟
اختبر DeepSeek-OCR مع مستنداتك الخاصة في دقائق. لا حاجة لبطاقة ائتمان. اختر من بين خمسة أوضاع دقة، وعالج مستندات بـ100 لغة، واختبر ضغط 10× بنفسك.
Novita AI منصة سحابية رائدة للذكاء الاصطناعي، توفّر للمطورين واجهات برمجة تطبيقات سهلة الاستخدام وبنية تحتية موثوقة وبأسعار معقولة لوحدات GPU لبناء تطبيقات الذكاء الاصطناعي وتوسيع نطاقها.