DeepSeek-OCR ofrece una compresión de texto 10× con un 97% de precisión al tratar las imágenes como almacenamiento comprimido para texto. En lugar de procesar 1000 tokens de texto individualmente, los procesa como una sola imagen usando solo 100 tokens de visión, reduciendo los costos hasta en un 85%.
Ahora disponible en Novita AI, DeepSeek-OCR procesa más de 200.000 páginas por día por GPU, es compatible con 100 idiomas y ofrece cinco modos de resolución (de 64 a más de 400 tokens). Va más allá del OCR tradicional para analizar gráficos en datos estructurados, reconocer fórmulas químicas, extraer figuras geométricas y permitir una gestión innovadora de la memoria para conversaciones largas.
Pruébalo ahora en el Playground de Novita AI →
¿Buscas la generación actual? Desde entonces, DeepSeek ha lanzado DeepSeek-OCR 2, con una puntuación más alta en OmniDocBench y una mejor precisión en el orden de lectura. Para nuevas integraciones, consulta Proveedor de API DeepSeek OCR2 y usa el ID de modelo
deepseek/deepseek-ocr-2.
¿Qué es DeepSeek-OCR?
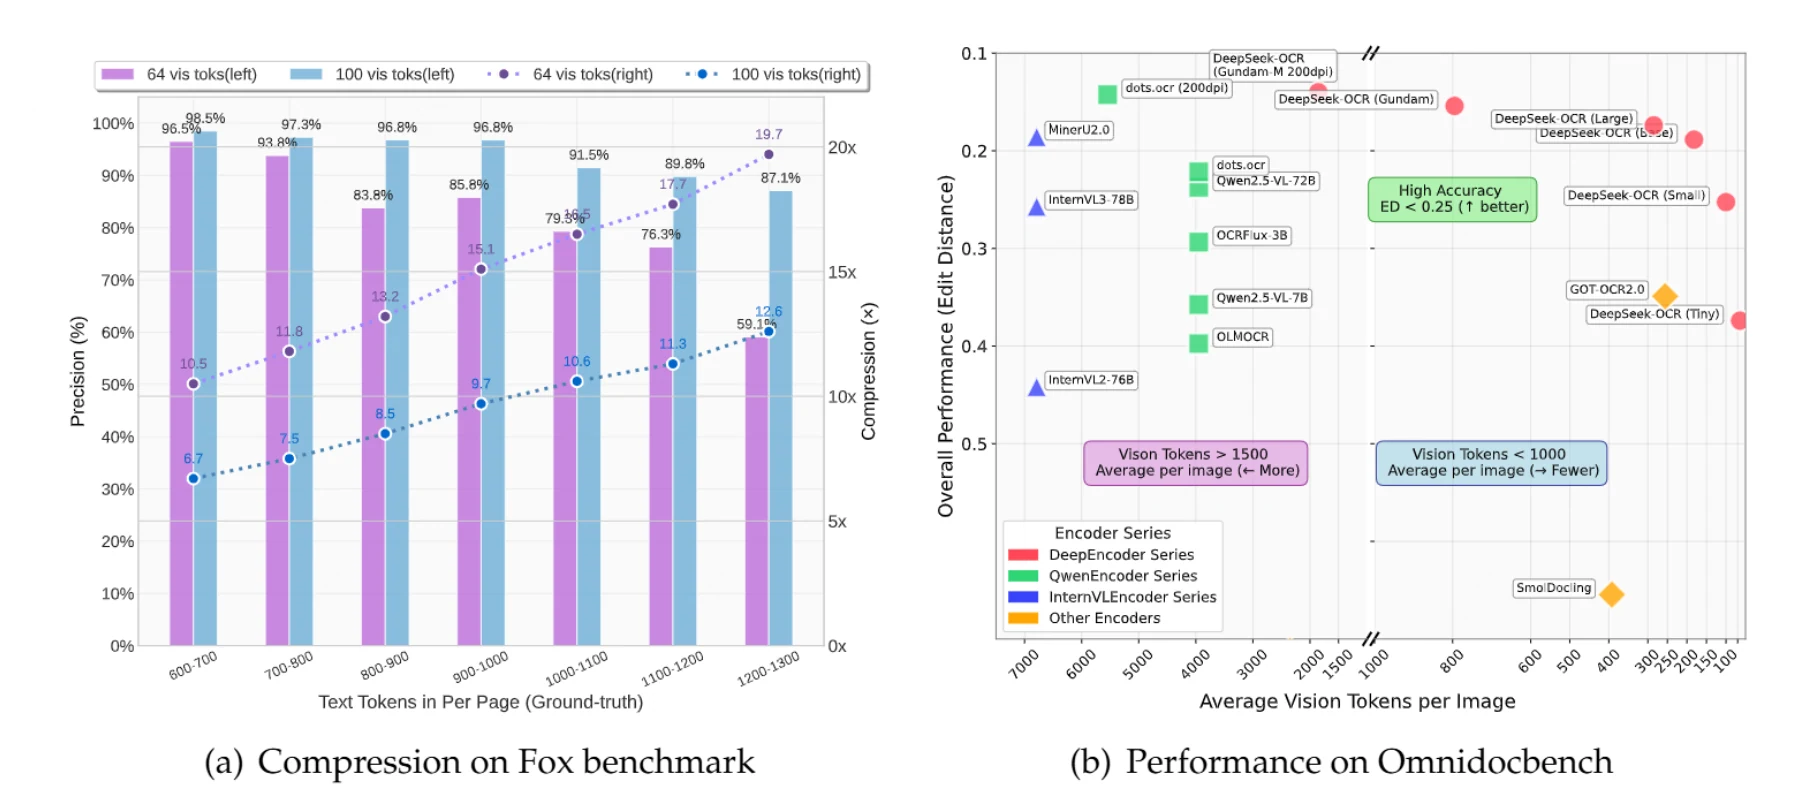
DeepSeek-OCR es un modelo de lenguaje-visión que trata las imágenes como almacenamiento comprimido para texto. En lugar de procesar un documento con 1000 tokens de texto individualmente (lo que es costoso computacionalmente), el modelo lo procesa como una sola imagen usando solo 100 tokens de visión: una reducción de 10× en los costos de procesamiento.
Arquitectura central
El modelo consta de dos componentes clave:
DeepEncoder (~380M de parámetros): Un codificador de visión especializado que procesa eficientemente imágenes de documentos utilizando una arquitectura serial única que combina atención de ventana (SAM) y atención global (CLIP) con una capa de compresión de 16× entre ellas.
Decodificador DeepSeek3B-MoE (570M de parámetros activos): Un modelo de lenguaje compacto de mezcla de expertos que convierte la información visual comprimida de vuelta a texto con una precisión notable.
Esta arquitectura permite una eficiencia sin precedentes en el procesamiento de documentos, lo que la hace ideal para empresas que manejan grandes volúmenes de documentos o aplicaciones que requieren comprensión de contexto largo.
Por qué es importante la compresión óptica
El problema tradicional
El procesamiento de texto tradicional en modelos de IA escala de forma cuadrática: duplicar la longitud del documento puede cuadruplicar los costos. Para empresas que procesan miles de documentos al día, esto se vuelve prohibitivamente caro.
La solución DeepSeek-OCR
Los documentos con hasta 1000 tokens de texto se pueden comprimir 10× con un 97% de precisión. Incluso con una compresión de 20×, la precisión se mantiene alrededor del 60%, a menudo suficiente para muchas aplicaciones.
Ejemplo del mundo real:
Un documento que contiene 900 tokens de texto tradicionalmente requiere 900 tokens para procesarse. Con DeepSeek-OCR en modo Small (100 tokens de visión), se logra una compresión de 9,7× con un 96,8% de precisión. Para documentos con 1100 tokens de texto, se obtiene una compresión de 10,6× con un 91,5% de precisión.
Impacto empresarial
Reducción de costos de API: Hasta 10× menos tokens procesados para documentos típicos significa ahorros dramáticos en costos: una empresa que procesa 1 millón de páginas al mes podría ahorrar más de $50,000 al año.
Procesamiento más rápido: Menos tokens se traducen directamente en tiempos de respuesta más rápidos, mejorando la experiencia del usuario y permitiendo aplicaciones en tiempo real.
Mejor escalabilidad: Maneja 10× más documentos con la misma inversión en infraestructura, haciendo que el crecimiento sea más predecible y asequible.
Eficiencia de memoria: Almacena el historial de conversaciones como imágenes comprimidas, lo que permite aplicaciones de contexto ultra largo sin requisitos exponenciales de memoria.
Rendimiento y benchmarks
Resultados completos de OmniDocBench
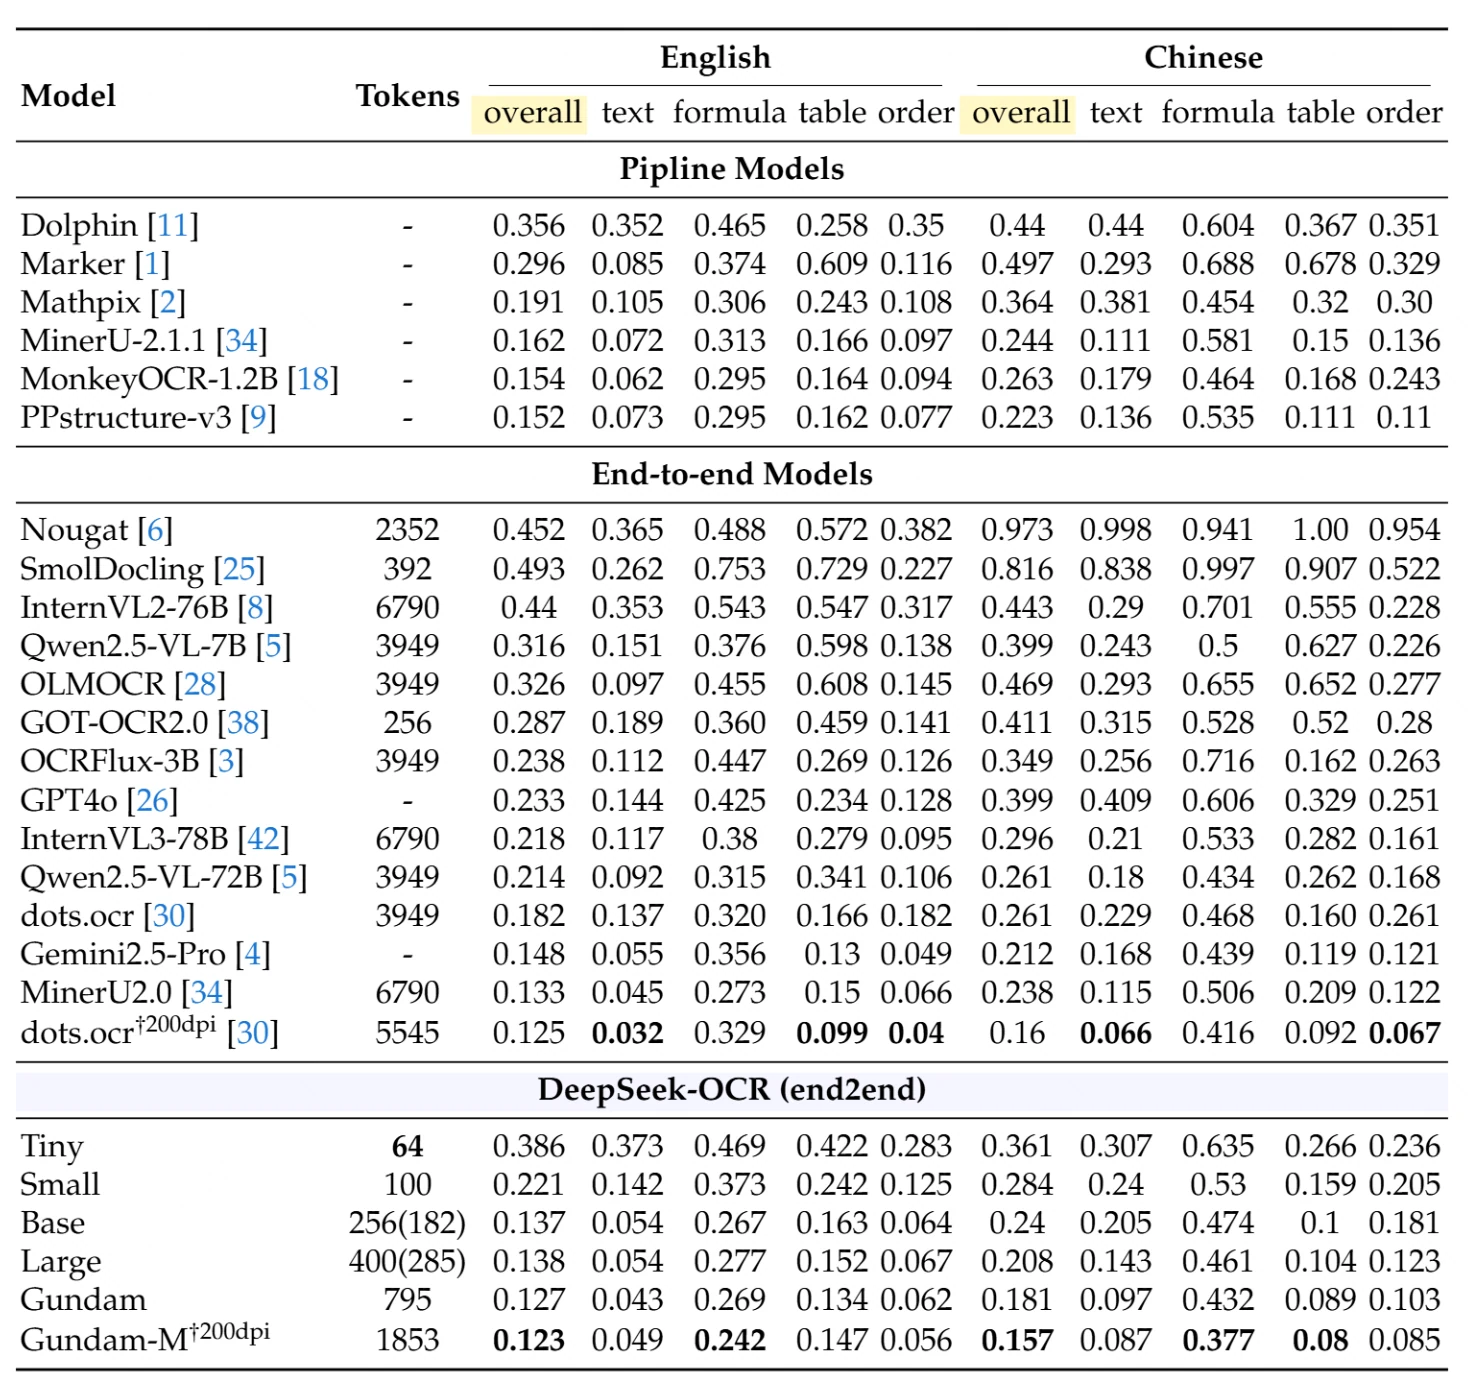
En OmniDocBench, un benchmark integral de análisis de documentos, DeepSeek-OCR logra un rendimiento excepcional con un uso mínimo de recursos. La siguiente tabla muestra comparaciones detalladas entre diferentes tipos de documentos e idiomas (distancia de edición: cuanto menor, mejor):
Aspectos destacados:
Modelos de pipeline (enfoques tradicionales de múltiples etapas): El modelo de pipeline con mejor rendimiento, PPstructure-v3, logra un 0,152 general en inglés y un 0,223 en chino, pero requiere una infraestructura compleja de múltiples modelos.
Modelos de extremo a extremo (enfoques de un solo modelo): Entre los competidores, MinerU2.0 usando 6790 tokens logra un 0,133 en inglés y un 0,238 en chino. Qwen2.5-VL-72B con 3949 tokens obtiene un 0,214 en inglés y un 0,261 en chino.
Rendimiento de DeepSeek-OCR:
- Modo Small (100 tokens): 0,221 general en inglés, 0,284 general en chino
- Modo Base (256 tokens): 0,137 general en inglés, 0,240 general en chino
- Modo Gundam (795 tokens): 0,127 general en inglés, 0,181 general en chino
- Gundam-M a 200 ppp (1853 tokens): 0,123 general en inglés, 0,157 general en chino: logrando resultados de última generación
Logro notable: El modo Base de DeepSeek-OCR con solo 256 tokens supera a modelos que usan entre 15 y 26 veces más tokens. El modo Gundam-M logra el mejor rendimiento general entre todos los modelos de extremo a extremo, aunque sigue usando significativamente menos tokens que los enfoques tradicionales.
Rendimiento por categoría
Reconocimiento de texto: DeepSeek-OCR (Gundam-M) logra 0,049 en texto en inglés y 0,087 en texto en chino, superando incluso a Gemini2.5-Pro.
Reconocimiento de fórmulas: Con 0,242 en fórmulas en inglés y 0,377 en fórmulas en chino, DeepSeek-OCR demuestra una sólida capacidad en contenido matemático.
Extracción de tablas: Puntajes de 0,147 en tablas en inglés y 0,08 en tablas en chino muestran una extracción robusta de datos estructurados.
Capacidades de producción
Velocidad de procesamiento: Una sola GPU A100-40G puede procesar más de 200 000 páginas por día. Escala a 20 nodos (160 GPUs) y obtendrás 33 millones de páginas por día, suficiente para las cargas de trabajo empresariales más exigentes.
Eficiencia de costos: Para una empresa que procesa 1 millón de páginas de documentos al mes, la diferencia es evidente. Los modelos tradicionales que requieren 6000 tokens por página consumen 6 mil millones de tokens en total. DeepSeek-OCR a 800 tokens por página usa solo 800 millones de tokens, una reducción del 87% en el uso de tokens y los costos asociados.
Características y capacidades clave
1. Soporte multilingüe
DeepSeek-OCR es compatible con casi 100 idiomas, desde los principales idiomas del mundo (inglés, chino, español, árabe, hindi) hasta escrituras especializadas (tailandés, hebreo, cirílico). Esto elimina la necesidad de servicios OCR específicos por idioma y simplifica las operaciones internacionales.
2. Comprensión avanzada de documentos
El modelo reconoce mucho más que solo texto. Analiza gráficos en datos estructurados, extrae fórmulas matemáticas con formato LaTeX, identifica figuras geométricas con salida SVG y mantiene estructuras de tablas, incluidas celdas combinadas y formato complejo.
3. Formatos de salida flexibles
Elige entre extracción de texto puro (más rápida), markdown con formato preservado, HTML para integración web o JSON estructurado para procesamiento programático. El modo de anclaje (grounding) preserva las relaciones espaciales, asegurando que los datos extraídos mantengan la estructura del documento original.
4. Compresión óptica para contexto largo
Almacena el historial de conversaciones como imágenes comprimidas en lugar de tokens de texto. Una conversación de 10 turnos que tradicionalmente consumiría 10 000 tokens se puede comprimir a 1000 tokens de visión, lo que permite aplicaciones con ventanas de contexto ultra largo a costos sostenibles.
El impacto: Las aplicaciones de chat pueden mantener el contexto a lo largo de cientos de turnos de conversación sin aumentos exponenciales de costos, lo que permite interacciones de IA verdaderamente extensas.
Primeros pasos en Novita AI
Comprensión de los modos de resolución
Novita AI proporciona DeepSeek-OCR con cinco modos de resolución diseñados para equilibrar rendimiento, velocidad y costo según diferentes casos de uso.
Modos de resolución nativa:
Modo Tiny (512×512, 64 tokens): Optimizado para documentos simples donde la velocidad máxima es prioritaria. Perfecto para recibos, formularios simples o tareas rápidas de extracción de texto.
Modo Small (640×640, 100 tokens): El punto óptimo para la mayoría de las aplicaciones. Ofrece el mejor equilibrio entre precisión, velocidad y costo. Ideal para documentos comerciales estándar, facturas e informes.
Modo Base (1024×1024, 256 tokens): Maneja diseños complejos con relaciones de aspecto preservadas usando relleno. Recomendado para contratos, informes detallados y documentos donde la estructura importa.
Modo Large (1280×1280, 400 tokens): Máxima calidad para documentos detallados de alta resolución. Ideal para trabajos de investigación, documentos técnicos con fórmulas y requisitos de calidad premium.
Modo de resolución dinámica:
Modo Gundam (n×640×640 + 1×1024×1024, tokens variables): Mosaico adaptativo para documentos de ultra alta resolución. Divide automáticamente imágenes grandes en 2-9 vistas locales de 640×640 más una vista global de 1024×1024. Esencial para periódicos, revistas y diseños complejos de múltiples columnas. Para imágenes más pequeñas de 640×640, se degrada automáticamente al modo Base.
Acceso a la API de DeepSeek-OCR
Novita AI proporciona una API REST simple para DeepSeek-OCR. Para comenzar, regístrate en una cuenta de Novita AI y obtén tu clave de API. El endpoint de la API acepta URLs de imágenes o imágenes codificadas en base64 junto con parámetros de configuración como modo de resolución, preferencia de idioma y formato de salida.
from openai import OpenAI

client = OpenAI(
    base_url="https://api.novita.ai/openai",
    api_key="<Tu clave de API>",
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr",
    messages=[
      {
        "role": "user",
        "content": [
          {
            "type": "image_url",
            "image_url": {
              "url": "https://example.com/image.png"
            }
          },
          {
            "type": "text",
            "text": "<|grounding|>OCR esta imagen."
          }
        ]
      }
    ],
    stream=False,
    max_tokens=4096
)

content = response.choices[0].message.content

print(content)
Patrones de uso básico
Para extracción de texto simple donde el formato no importa, usa el modo “OCR gratuito”. Para análisis estructurado de documentos que preserva diseño, tablas y formato, usa el modo “grounding” con salida markdown. Para análisis avanzado de gráficos, fórmulas o figuras geométricas, usa el mensaje “Analiza la figura”.
Guía de resolución
Cómo elegir el modo adecuado
Para facturas, recibos y formularios simples: El modo Small (100 tokens) es tu mejor opción. Es rápido, rentable y proporciona precisión suficiente para la extracción de datos estructurados. Esto cubre la mayoría de las necesidades rutinarias de procesamiento de documentos empresariales.
Para documentos comerciales, informes y contratos: El modo Base (256 tokens) maneja bien diseños complejos y preserva las relaciones de aspecto con relleno. Es el equilibrio adecuado cuando la estructura y el formato del documento son importantes.
Para trabajos de investigación y documentos técnicos: El modo Large (400 tokens) proporciona la precisión necesaria para texto denso, fórmulas matemáticas y diagramas técnicos. El mayor número de tokens se justifica por los requisitos de precisión.
Para periódicos, revistas y diseños de múltiples columnas: El modo Gundam (tokens variables) es esencial. Su mosaico adaptativo maneja resoluciones ultra altas y diseños complejos de múltiples columnas que se distorsionarían en modos de resolución fija. Aunque usa más tokens, sigue siendo mucho más eficiente que los enfoques tradicionales.
Información de rendimiento por tipo de documento
Según las pruebas exhaustivas de OmniDocBench:
Diapositivas y documentos simples: Incluso el modo Tiny (64 tokens) funciona notablemente bien con una distancia de edición de 0,116 en diapositivas, mientras que el modo Small ofrece un valor óptimo. Esto se debe a que las diapositivas de presentación suelen tener diseños claros y texto limitado por página.
Libros y documentos estándar: El modo Small (100 tokens) ofrece un valor excelente con una distancia de edición de 0,085 para libros. La mayoría de los libros contienen entre 600 y 1000 tokens de texto por página, dentro del punto óptimo de compresión de 10×.
Artículos académicos: Se recomiendan el modo Large o el modo Gundam, logrando este último una distancia de edición de 0,039 en artículos académicos, superando a modelos que usan entre 5 y 8 veces más tokens.
Periódicos: El modo Gundam es esencial, logrando una distancia de edición de 0,122 en comparación con 0,940 del modo Tiny. Los periódicos contienen entre 4000 y 5000 tokens de texto por página con diseños complejos de múltiples columnas que requieren el enfoque de mosaico adaptativo.
Documentos con muchas fórmulas: Para documentos con fórmulas matemáticas, el modo Gundam-M logra el mejor rendimiento con una distancia de edición de 0,242 en fórmulas en inglés, competitivo con modelos grandes especializados.
Explicación detallada del modo Gundam
El modo Gundam funciona creando múltiples vistas locales (2-9 mosaicos de 640×640) que capturan regiones detalladas, más una vista global (1024×1024) que mantiene el contexto general. El número total de tokens se calcula como n×100 + 256, donde n es el número de mosaicos.
Cuándo usar el modo Gundam: Úsalo para imágenes de más de 1280 píxeles en cualquier dimensión, documentos con diseños de múltiples columnas, contenido con más de 4000 tokens de texto o infografías complejas que necesiten tanto detalle como contexto.
Ejemplo del mundo real: Una página de periódico pequeña podría usar 3 mosaicos (556 tokens en total), mientras que una página grande usa 6 mosaicos (856 tokens). Compáralo con los enfoques tradicionales que requieren más de 6000 tokens; sigues logrando una compresión de 7 a 10× incluso en los documentos más complejos.
Conclusión
DeepSeek-OCR en Novita AI logra una compresión de 10× con un 97% de precisión, reduciendo los costos de procesamiento de documentos hasta en un 85% mientras es compatible con 100 idiomas y procesa más de 200 000 páginas por GPU al día.
Los resultados hablan por sí solos: Las empresas que procesan 100 000 documentos al mes ahorran más de $50 000 al año. Las velocidades de procesamiento mejoran de 5 a 10×. La infraestructura escala de forma lineal en lugar de exponencial.
¿Listo para transformar tu procesamiento de documentos?
Comienza gratis en el Playground →
Prueba DeepSeek-OCR con tus propios documentos en minutos. No se requiere tarjeta de crédito. Elige entre cinco modos de resolución, procesa documentos en 100 idiomas y experimenta la compresión de 10× de primera mano.
Novita AI es una plataforma líder en la nube de IA que proporciona a los desarrolladores APIs fáciles de usar e infraestructura GPU asequible y confiable para construir y escalar aplicaciones de IA.