DeepSeek-OCR offre une compression de texte 10× avec une précision de 97 % en traitant les images comme un stockage compressé du texte. Au lieu de traiter 1 000 jetons de texte individuellement, il les traite comme une seule image en utilisant seulement 100 jetons de vision, réduisant ainsi les coûts jusqu’à 85 %.
Désormais disponible sur Novita AI, DeepSeek-OCR traite plus de 200 000 pages par jour par GPU, prend en charge 100 langues et propose cinq modes de résolution (64 à 400+ jetons). Il va au-delà de l’OCR traditionnelle pour analyser les graphiques en données structurées, reconnaître les formules chimiques, extraire les figures géométriques et permettre une gestion innovante de la mémoire pour les longues conversations.
Essayez-le maintenant dans le Playground Novita AI →
Vous cherchez la génération actuelle ? DeepSeek a depuis publié DeepSeek-OCR 2, avec un score OmniDocBench plus élevé et une meilleure précision de l’ordre de lecture. Pour les nouvelles intégrations, consultez Fournisseur d’API DeepSeek OCR2 et utilisez l’ID de modèle
deepseek/deepseek-ocr-2.
Qu’est-ce que DeepSeek-OCR ?
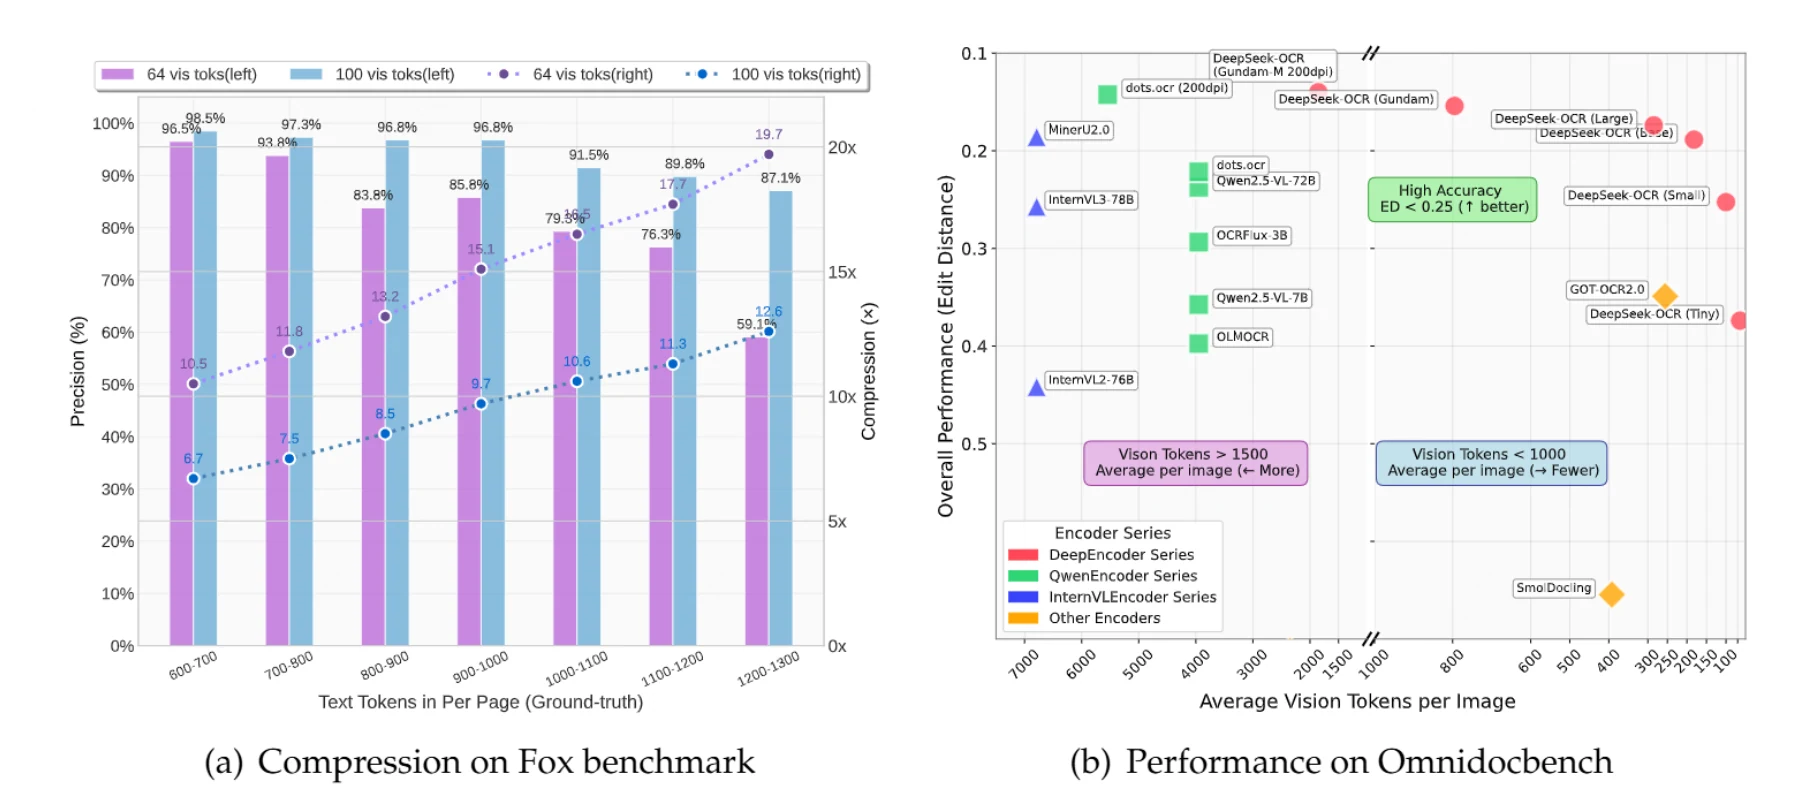
DeepSeek-OCR est un modèle de langage visuel qui traite les images comme un stockage compressé du texte. Au lieu de traiter un document avec 1 000 jetons de texte individuellement (ce qui est coûteux en calcul), le modèle le traite comme une seule image en utilisant seulement 100 jetons de vision, soit une réduction de 10× des coûts de traitement.
Architecture principale
Le modèle est composé de deux éléments clés :
DeepEncoder (~380 millions de paramètres) : Un encodeur visuel spécialisé qui traite efficacement les images de documents en utilisant une architecture en série unique combinant une attention de fenêtre (SAM) et une attention globale (CLIP) avec une couche de compression 16× entre elles.
Décodeur DeepSeek3B-MoE (570 millions de paramètres actifs) : Un modèle de langage compact à mixture d’experts qui convertit les informations visuelles compressées en texte avec une précision remarquable.
Cette architecture permet une efficacité sans précédent dans le traitement de documents, ce qui la rend idéale pour les entreprises traitant de grands volumes de documents ou les applications nécessitant une compréhension de contexte long.
Pourquoi la compression optique est importante
Le problème traditionnel
Le traitement de texte traditionnel dans les modèles d’IA évolue de façon quadratique : doubler la longueur d’un document peut quadrupler les coûts. Pour les entreprises qui traitent des milliers de documents quotidiennement, cela devient prohibitif.
La solution DeepSeek-OCR
Les documents contenant jusqu’à 1 000 jetons de texte peuvent être compressés 10× avec une précision de 97 %. Même à une compression de 20×, la précision reste autour de 60 %, ce qui est souvent suffisant pour de nombreuses applications.
Exemple concret :
Un document contenant 900 jetons de texte nécessite traditionnellement 900 jetons pour être traité. Avec DeepSeek-OCR en mode Small (100 jetons de vision), vous obtenez une compression de 9,7× avec une précision de 96,8 %. Pour les documents de 1 100 jetons de texte, vous obtenez une compression de 10,6× avec une précision de 91,5 %.
Impact sur l’entreprise
Coûts d’API réduits : Jusqu’à 10× moins de jetons traités pour les documents typiques, ce qui se traduit par des économies considérables : une entreprise traitant 1 million de pages par mois pourrait économiser plus de 50 000 $ par an.
Traitement plus rapide : Moins de jetons signifie directement des temps de réponse plus rapides, améliorant l’expérience utilisateur et permettant des applications en temps réel.
Meilleure évolutivité : Traitez 10× plus de documents avec la même infrastructure, rendant la croissance plus prévisible et abordable.
Efficacité mémoire : Stockez l’historique des conversations sous forme d’images compressées, permettant des applications à contexte ultra-long sans besoins mémoire exponentiels.
Performances et benchmarks
Résultats OmniDocBench complets
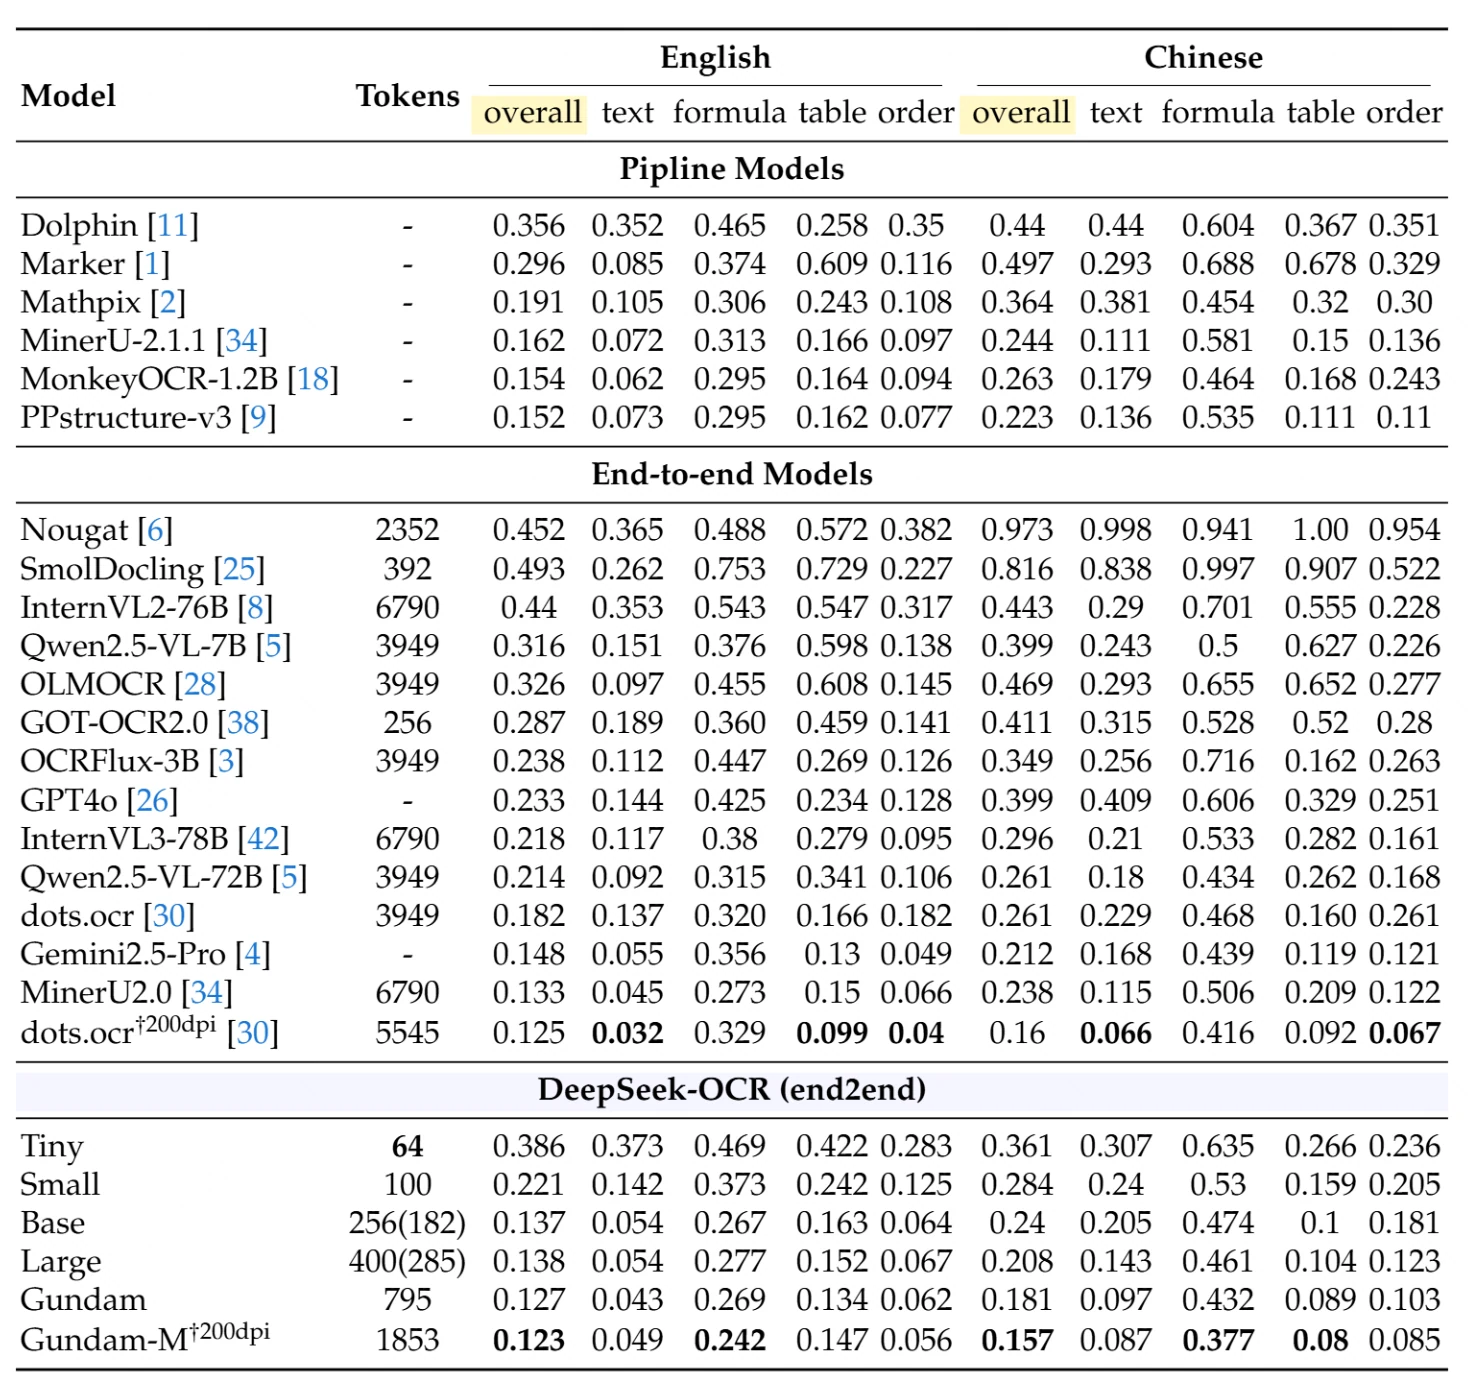
Sur OmniDocBench, un benchmark complet d’analyse de documents, DeepSeek-OCR obtient des performances exceptionnelles avec une utilisation minimale des ressources. Le tableau ci-dessous montre des comparaisons détaillées entre différents types de documents et langues (distance d’édition - plus bas est meilleur) :
Points clés :
Modèles de pipeline (approches traditionnelles multi-étapes) : Le meilleur modèle de pipeline, PPstructure-v3, obtient 0,152 au global pour l’anglais et 0,223 pour le chinois, mais nécessite une infrastructure complexe multi-modèle.
Modèles de bout en bout (approches mono-modèle) : Parmis les concurrents, MinerU2 .0 utilisant 6 790 jetons obtient 0,133 pour l’anglais et 0,238 pour le chinois . Qwen2 .5 -VL-72B avéc 3 949 jetons score 0 .214 pour l’anglais et 0 .261 pour le chinois .
Performances DeepSeek -OCR:
- Mode Small (100 jetons) : 0 .221 anglais global , 0 .284 chinois global
- Mode Base (256 jetons) : 0 .137 anglais global , 0 .240 chinois global
- Mode Gundam (795 jétons) : 0 .127 anglais global , 0 .181 chinois global
- Mode Gundam -M à 200 dpi (1 853 jétons) : 0 .123 anglais global , 0 .157 chinois global - atteignant des résultats de pointe
Réalisation remarquable : Le mode Base de DeepSeek -OCR avéc seulement 256 jetons surpasse les modèles utilisant 15-26× plus de jetons . Le mode Gundam -M obtient les meilleurs résultats globaux parmi tous les modèles de bout en bout tout en utilisant nettement moins d jetons que les approches traditionnelles.
Performances par catégorie
Reconnaissance de texte : DeepSeek -OCR (Gundam -M) atteint 0 .049 pour l’anglais et 0 .087 pour le chinois , surpassant même Gemini2 .5 -Pro.
Reconnaissance de formules : avec 0 .242 pour l’est formules anglais et 0 .377 pour lés formules chinois , DeepSeek -OCR démontre une forte capacité dans lés contenus mathématiques .
Extraction de tableaux : Scores de 0 .147 pour lés tableaux anglais et 0 .08 pour lés tableaux chinois montrent une extraction robuste de données structurées .
Capacités de production
Vitesse de traitement : Un seul GPU A100 -40G peut traiter plus de 200 000 pages par jour . Passez à 20 nœuds (160 GPU) et vous traitez 33 millions de pages par jour—assez pour les charges de travail d’entreprise les plus exigeantes .
Efficacité coût : Pour une entrepris traitant 1 million de pages de document par mois , la différence est nette . Lés modèles traditionnels nécessitant 6 000 jetons par page consomment 6 milliards de jetons au total . DeepSeek -OCR à 800 jetons par page utilise seulement 800 millions de jetons—une réduction de 87 % de l’utilisation de jetons et des coûts associés .
Principales fonctionnalités et capacités
1. Prise en charge multilingue
DeepSeek -OCR prend en charge près de 100 langues , des grandes langues mondiales (anglais , chinois , espagnol , arabe , hindi ) aux écritures spécialisées (thai , hébreux , cyrillique ). Cela élimine le besoin de services OCR spécifiques à une langue et simplifie les opérations internationales.
2. Compréhension avancée des documents
Le modèle reconnaît bien plus que du texte . Il analyse les graphiques en données structurées , extrait des formules mathématiques avec formatage LaTeX , identifie des figures géométriques avec sortie SVG , et maintient des structures de tableaux incluant des cellules fusionnées et un formatage complexe .
3. Formats de sortie flexibles
Choisissez entre l’extraction de texte pur (la plus rapide ), le markdown avec formatage préservé , le HTML pour l’intégration web , ou le JSON structuré pour le traitement programmatique . Le mode d’ancrage préserve les relations spatiales , garantissant que vos données extraites conservent la structure du document original .
4. Compression optique pour le contexte long
Stockez l’historique des conversations sous forme d’images compressées au lieu de jetons de texte . Une conversation de 10 tours qui consommerait traditionnellement 10 000 jetons peut être compressée en 1 000 jetons de vision , permettant des applications avec des fenêtres de contexte ultra-longues à des coûts durables .
L’impact : Lés applications de chat peuvent maintenir le contexte sur des centaines de tours de conversation sans augmentation exponentielle des coûts , permettant des interactions IA véritablement longues .
Premiers pas sur Novita AI
Comprendre les modes de résolution
Novita AI fournit DeepSeek -OCR avec cinq modes de résolution conçus pour équilibrer performances , vitess et coût pour différents cas d’utilisation .
Modes de résolution native :
Mode Tiny (512×512 , 64 jetons) : Optimisé pour les documents simples où la vitesse maximale est prioritaire . Parfait pour les reçus , les formulaires simples ou les tâches d’extraction de texte rapides .
Mode Small (640×640 , 100 jetons) : Le point idéal pour la plupart des applications . Offre le meilleur équilibre entre précision , vitess et coût . Idéal pour les documents commerciaux standards , les factures et les rapports .
Mode Base (1024×1024 , 256 jetons) : Gère les mises en page complexes avec des ratios d’aspect préservés à l’aide de remplissage . Recommandé pour les contrats , les rapports détaillés et les documents où la mise en page compte .
Mode Large (1280×1280 , 400 jetons) : Qualité maximale pour les documents détaillés haute résolution . Idéal pour les documents de recherche , les documents techniques avec formules et les exigences de qualité premium .
Mode résolution dynamique :
Mode Gundam (n×640×640 + 1×1024×1024 , jetons variables) : Découpage adaptatif pour les documents ultra-haute résolution . Divise automatiquement les grandes images en 2-9 vues locales à 640×640 plus une vue globale à 1024×1024 . Essentiel pour les journaux , les magazines et les mises en page complexes à plusieurs colonnes . Pour les images de moins de 640×640 , il rétrograde automatiquement en mode Base .
Accéder à l’API DeepSeek -OCR
Novita AI fournit une API REST simple pour DeepSeek -OCR . Pour commencer , créez un compte Novita AI et obtenez votre clé API . L’endpoint API accepte les URL d’images ou les images encodées en base64 ainsi que les paramètres de configuration comme le mode de résolution , la préférence linguistique et le format de sortie .
from openai import OpenAI

client = OpenAI(
    base_url="https://api.novita.ai/openai",
    api_key="<Your API Key>",
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr",
    messages=[
      {
        "role": "user",
        "content": [
          {
            "type": "image_url",
            "image_url": {
              "url": "https://example.com/image.png"
            }
          },
          {
            "type": "text",
            "text": "<|grounding|>OCR this image."
          }
        ]
      }
    ],
    stream=False,
    max_tokens=4096
)

content = response.choices[0].message.content

print(content)
Schémas d’utilisation de base
Pour une extraction de texte simple où le formatage n’a pas d’importance, utilisez le mode “Free OCR”. Pour une analyse structurée de documents qui préserve la mise en page, les tableaux et le formatage, utilisez le mode “grounding” avec une sortie markdown. Pour une analyse avancée de graphiques, de formules ou de figures géométriques, utilisez l’invite “Parse the figure”.
Guide de résolution
Choisir le bon mode
Pour les factures, reçus et formulaires simples : Le mode Small (100 jetons) est votre meilleur choix. Il est rapide, économique et offre une précision suffisante pour l’extraction de données structurées. Cela couvre la plupart des besoins de traitement de documents courants.
Pour les documents commerciaux, rapports et contrats : Le mode Base (256 jetons) gère bien les mises en page complexes et préserve les ratios d’aspect avec remplissage. C’est le bon équilibre quand la structure du document et le formatage sont importants.
Pour les articles de recherche et documents techniques : Le mode Large (400 jétons) offre la précision nécessaire pour le texte dense, les formules mathématiques et les diagrammes techniques. Le nombre de jétons plus élevé est justifié par les exigences de précision.
Pour les journaux, magazines et mises en page multi-colonnes : Le mode Gundam (jetons variables) est essentiel. Son découpage adaptatif gère les ultra-haute résolution et les mises en page complexes multi-colonnes qui seraient déformées dans les modes à résolution fixe. Bien qu’il utilise plus de jetons, il reste bien plus efficace que les approches traditionnelles.
Aperçu des performances par type de document
Basé sur les tests complets OmniDocBench :
Diapositives et documents simples : Même le mode Tiny (64 jetons) performe remarquablement avéc 0.116 de distance d’édition sur lés diapositives, tandis que le mode Small offre un rapport qualité-prix optimal. Cela est dû au fait que les diapositives de présentation ont générament des mises en page claires et peu de texte par page.
Livres et documents standard : Le mode Small (100 jétons) offre un excellent rapport qualité-prix avéc 0.085 de distance d’édition pour lés livres. La plupart des livres contiennent 600-1 000 jétons de texte par page, bien dans la zone idéale de compression 10×.
Articles académiques : Le mode Large ou le mode Gundam sont recommandés, le mode Gundam atteignant 0.039 de distance d’édition sur lés articles académiques—surpassant lés modèles utilisant 5-8× plus de jétons.
Journaux : Le mode Gundam est essentiel, atteignant 0.122 de distance d’édition contre 0.940 pour le mode Tiny. Les journaux contiennent 4 000-5 000 jétons de texte par page avéc des mises en page complexes multi-colonnes qui nécessitent l’approche de découpage adaptatif.
Documents riche en formules : Pour les documents avéc des formules mathématiques, le mode Gundam-M obtient la meilleure performance avéc 0.242 de distance d’édition sur lés formules anglais, compétitif avéc les grands modèles spécialisés.
Comprendre le mode Gundam en détail
Le mode Gundam fonctionne en créant plusieurs vues locales (2-9 tuiles à 640×640) qui capturent les régions détaillées, plus une vue globale (1024×1024) qui maintient le contexte général. Le nombre total de jetons est calculé comme n×100 + 256, où n est le nombre de tuiles.
Quand utiliser le mode Gundam : Utilisez-le pour les images de plus de 1280 pixels dans n’importe quelle dimension, les documents avec une mise en page multi-colonnes, le contenu de 4000+ jetons de texte, ou les infographies complexes nécessitant à la fois des détails et du contexte.
Exemple concret : Une petite page de journal peut utiliser 3 tuiles (556 jetons au total), tandis qu’une grande page de journal utilise 6 tuiles (856 jetons). Comparez cela aux approches traditionnelles nécessitant 6000+ jetons—vous obtenez toujours une compression de 7-10× même sur les documents les plus complexes.
Conclusion
DeepSeek-OCR sur Novita AI atteint une compression 10× avec une précision de 97 %, réduisant les coûts de traitement de documents jusqu’à 85 % tout en prenant en charge 100 langues et en traitant plus de 200 000 pages par GPU par jour.
Les résultats parlent d’eux-mêmes : Les entreprises qui traitent 100 000 documents par mois économisent plus de 50 000 $ par an. Les vitesses de traitement s’améliorent de 5 à 10×. L’infrastructure évolue linéairement au lieu d’exponentiellement.
Prêt à transformer votre traitement de documents ?
Commencez gratuitement dans le Playground →
Testez DeepSeek-OCR avec vos propres documents en quelques minutes. Aucune carte de crédit requise. Choisissez parmi cinq modes de résolution, traitez des documents en 100 langues et découvrez une compression 10× par vous-même.
Novita AI est une plateforme cloud IA de premier plan qui fournit aux développeurs des API faciles à utiliser et une infrastructure GPU abordable et fiable pour créer et déployer des applications d’IA.