DeepSeek-OCR은 이미지를 텍스트 압축 저장소로 활용하여 10배 텍스트 압축, 97% 정확도 를 제공합니다. 1,000개의 텍스트 토큰을 개별적으로 처리하는 대신 단일 이미지로 처리하여 단 100개의 비전 토큰만 사용하므로 비용이 최대 85% 절감됩니다.
이제 Novita AI에서 사용할 수 있는 DeepSeek-OCR은 GPU당 **일일 200,000페이지 이상 ** 을 처리하고, 100개 언어 를 지원하며, 5가지 해상도 모드(64~400+ 토큰)를 제공합니다. 기존 OCR을 넘어 차트를 구조화된 데이터로 파싱하고, 화학식을 인식하며, 기하 도형을 추출하고, 긴 대화를 위한 혁신적인 메모리 관리를 가능하게 합니다.
지금 Novita AI Playground에서 사용해보기 →
최신 버전을 찾으시나요? DeepSeek은 이후 더 높은 OmniDocBench 점수와 향상된 읽기 순서 정확도를 갖춘 DeepSeek-OCR 2를 출시했습니다. 새로운 통합을 원하시면 DeepSeek OCR2 API 제공자 문서를 참조하고 모델 ID
deepseek/deepseek-ocr-2를 사용하세요.
DeepSeek-OCR이란?
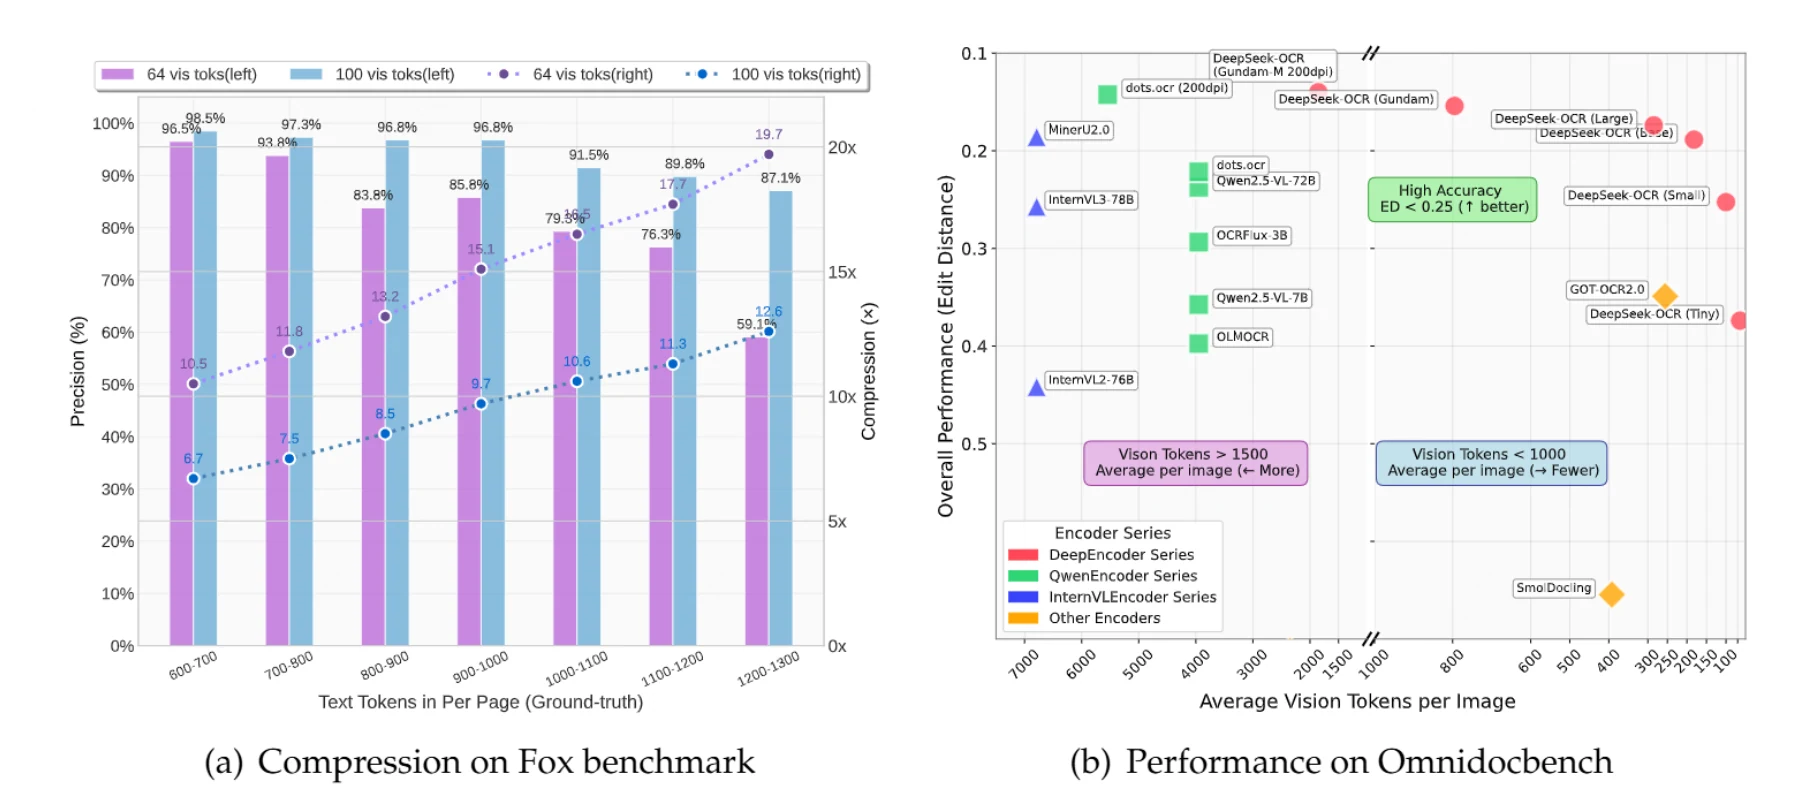
DeepSeek-OCR은 이미지를 텍스트 압축 저장소로 취급하는 비전-언어 모델입니다. 1,000개의 텍스트 토큰이 포함된 문서를 개별적으로 처리하는 대신(이는 계산 비용이 많이 듬), 모델은 단 100개의 비전 토큰만 사용하여 단일 이미지로 처리합니다—10배 의 처리 비용 절감 효과.
핵심 아키텍처
모델은 두 가지 주요 구성 요소로 이루어져 있습니다:
DeepEncoder (~3억 8천만 파라미터): 창문 주의(SAM)와 전역 주의(CLIP)를 결합하고 그 사이에 16배 압축 계층을 둔 독특한 직렬 아키텍처를 사용하여 문서 이미지를 효율적으로 처리하는 특수 비전 인코더입니다.
DeepSeek3B-MoE 디코더 (5억 7천만 활성 파라미터): 압축된 시각 정보를 놀라운 정확도로 텍스트로 변환하는 컴팩트한 전문가 혼합 언어 모델입니다.
이 아키텍처는 문서 처리에서 전례 없는 효율성을 가능하게 하여, 대량의 문서를 처리하는 기업이나 긴 컨텍스트 이해가 필요한 애플리케이션에 이상적입니다.
광학 압축이 중요한 이유
기존 문제점
AI 모델의 기존 텍스트 처리는 2차 함수적으로 확장됩니다—문서 길이가 두 배가 되면 비용도 두 배가 될 수 있습니다. 매일 수천 개의 문서를 처리하는 기업에게 이는 엄청난 비용 부담이 됩니다.
DeepSeek-OCR 솔루션
최대 1,000개의 텍스트 토큰이 포함된 문서는 97% 정확도 로 10배 압축 가능합니다. 20배 압축에서도 정확도는 약 60%로 유지되어 많은 애플리케이션에서 충분히 사용 가능합니다.
실제 예시:
900개의 텍스트 토큰이 포함된 문서는 전통적으로 900개의 토큰을 필요로 합니다. DeepSeek-OCR을 소형 모드(100 비전 토큰)로 사용하면 **96.8% 정확도로 9.7배 압축 ** 을 달성합니다. 1,100개의 텍스트 토큰이 있는 문서의 경우 91.5% 정확도로 10.6배 압축 을 얻습니다.
비즈니스 영향
API 비용 절감: 일반 문서의 경우 최대 10배 적은 토큰 처리로 상당한 비용 절감—월 100만 페이지를 처리하는 기업은 연간 5만 달러 이상 절약 가능.
처리 속도 향상: 토큰 수 감소는 응답 시간 단축으로 이어져 사용자 경험을 개선하고 실시간 애플리케이션을 가능하게 합니다.
확장성 향상: 동일한 인프라 투자로 10배 더 많은 문서를 처리할 수 있어 성장이 더 예측 가능하고 경제적입니다.
메모리 효율성: 대화 기록을 압축 이미지로 저장하여 지수 메모리 요구 사항 없이 초장기 컨텍스트 애플리케이션을 가능하게 합니다.
성능 및 벤치마크
종합 OmniDocBench 결과
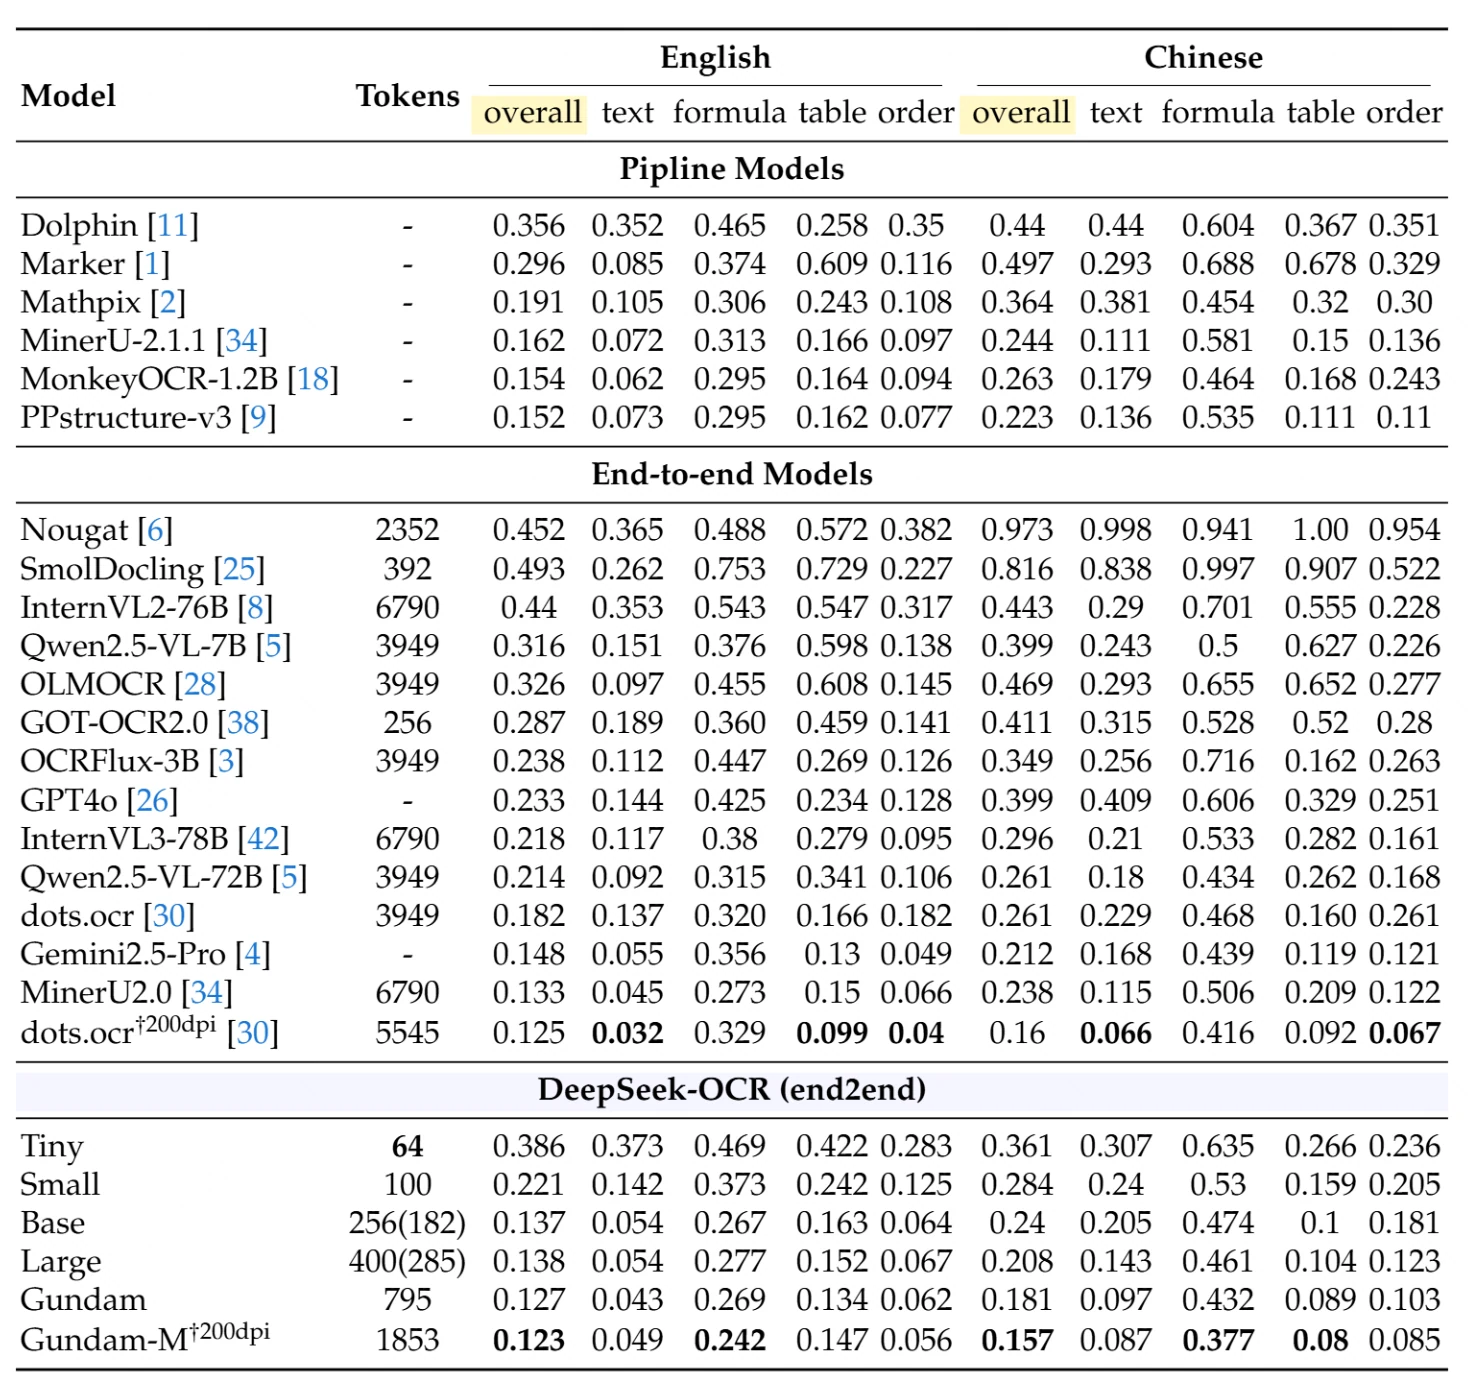
포괄적인 문서 파싱 벤치마크인 OmniDocBench에서 DeepSeek-OCR은 최소한의 리소스 사용으로 뛰어난 성능을 달성합니다. 아래 표는 다양한 문서 유형과 언어별 상세 비교를 보여줍니다(편집 거리—낮을수록 좋음):
주요 하이라이트:
파이프라인 모델 (기존 다단계 접근 방식): 가장 우수한 성능의 파이프라인 모델인 PPstructure-v3는 영어 종합 0.152, 중국어 0.223을 달성하지만 복잡한 다중 모델 인프라가 필요합니다.
엔드 투 엔드 모델 (단일 모델 접근 방식): 경쟁사 중 MinerU2.0은 6,790개의 토큰을 사용하여 영어 0.133, 중국어 0.238을 달성합니다. Qwen2.5-VL-72B는 3,949개의 토큰으로 영어 0.214, 중국어 0.261을 기록합니다.
DeepSeek-OCR 성능:
- 소형 모드 (100 토큰): 영어 종합 0.221, 중국어 종합 0.284
- 기본 모드 (256 토큰): 영어 종합 0.137, 중국어 종합 0.240
- 건담 모드 (795 토큰): 영어 종합 0.127, 중국어 종합 0.181
- Gundam-M (200dpi, 1,853 토큰): ** 영어 종합 0.123, 중국어 종합 0.157**—최첨단 결과 달성
놀라운 성과: 단 256개의 토큰을 사용하는 DeepSeek-OCR의 기본 모드는 15~26배 더 많은 토큰을 사용하는 모델을 능가합니다. Gundam-M 모드는 기존 접근 방식보다 훨씬 적은 토큰을 사용하면서도 모든 엔드 투 엔드 모델 중 최고의 종합 성능을 달성합니다.
카테고리별 성능
텍스트 인식 : DeepSeek-OCR(Gundam-M)은 ** 영어 텍스트 0.049, ** 중국어 텍스트 0.087을 달성하여 Gemini2.5-Pro조차 능가합니다.
수식 인식 : ** 영어 수식 0.242, ** 중국어 수식 0.377로 DeepSeek-OCR은 수학적 콘텐츠에서 강력한 성능을 보여줍니다.
표 추출 : ** 영어 표 0.147, ** 중국어 표 0.08의 점수로 강력한 구조화된 데이터 추출 능력을 입증합니다.
프로덕션 역량
처리 속도: 단일 A100-40G GPU로 하루에 200,000페이지 이상 처리 가능. 20개 노드(160 GPU)로 확장하면 하루 3,300만 페이지—가장 까다로운 엔터프라이즈 워크로드에도 충분합니다.
**비용 효율성 **: 월 100만 문서 페이지를 처리하는 기업의 경우 차이가 극명합니다. 페이지당 6,000개의 토큰이 필요한 기존 모델은 총 60억 개의 토큰을 소비합니다. DeepSeek-OCR을 페이지당 800개의 토큰으로 사용하면 8억 개의 토큰만 사용—87% 의 토큰 사용량 및 관련 비용 절감.
주요 기능
1. 다국어 지원
DeepSeek-OCR은 주요 세계 언어(영어, 중국어, 스페인어, 아랍어, 힌디어)부터 특수 문자(태국어, 히브리어, 키릴 문자)까지 거의 100개 언어 를 지원합니다. 이는 언어별 OCR 서비스의 필요성을 없애고 국제 업무를 간소화합니다.
2. 고급 문서 이해
모델은 텍스트 이상의 것을 인식합니다. 차트를 구조화된 데이터로 파싱하고, LaTeX 형식의 수학 공식을 추출하며, SVG 출력으로 기하 도형을 식별하고, 병합된 셀과 복잡한 서식을 포함한 표 구조를 유지합니다.
3. 유연한 출력 형식
순수 텍스트 추출(가장 빠름), 서식이 보존된 마크다운, 웹 통합을 위한 HTML, 프로그래밍 처리를 위한 구조화된 JSON 중에서 선택 가능합니다. 그라운딩 모드는 공간 관계를 보존하여 추출된 데이터가 원본 문서의 구조를 유지하도록 합니다.
4. 긴 컨텍스트를 위한 광학 압축
대화 기록을 텍스트 토큰 대신 압축 이미지로 저장합니다. 전통적으로 10,000개의 토큰을 소비할 10회 대화를 1,000개의 비전 토큰으로 압축하여 지속 가능한 비용으로 초장기 컨텍스트 윈도우를 가능하게 합니다.
영향: 채팅 애플리케이션은 비용 지수 증가 없이 수백 번의 대화 턴에 걸쳐 컨텍스트를 유지할 수 있어 진정한 장문 AI 상호작용을 가능하게 합니다.
Novita AI에서 시작하기
해상도 모드 이해하기
Novita AI는 다양한 사용 사례에 맞게 성능, 속도, 비용의 균형을 맞춘 다섯 가지 해상도 모드 를 갖춘 DeepSeek-OCR을 제공합니다.
기본 해상도 모드:
초소형 모드 (512×512, 64 토큰): 최대 속도가 우선인 단순 문서에 최적화. 영수증, 간단한 양식, 빠른 텍스트 추출 작업에 적합.
소형 모드 (640×640, 100 토큰): 대부분의 애플리케이션에 최적의 지점. 정확도, 속도, 비용의 최상의 균형 제공. 일반 비즈니스 문서, 송장, 보고서에 이상적.
기본 모드 (1024×1024, 256 토큰): 패딩을 사용하여 종횡비를 유지하면서 복잡한 레이아웃 처리. 계약서, 상세 보고서, 레이아웃이 중요한 문서에 권장.
대형 모드 (1280×1280, 400 토큰): 고해상도 상세 문서를 위한 최대 품질. 연구 논문, 수식이 포함된 기술 문서, 프리미엄 품질 요구 사항에 가장 적합.
동적 해상도 모드:
건담 모드 (n×640×640 + 1×1024×1024, 가변 토큰): 초고해상도 문서를 위한 적응형 타일링. 큰 이미지를 640×640의 2~9개 로컬 뷰와 1024×1024의 하나의 글로벌 뷰로 자동 분할. 신문, 잡지, 복잡한 다단 레이아웃에 필수. 640×640보다 작은 이미지의 경우 자동으로 기본 모드로 전환됩니다.
DeepSeek-OCR API 액세스
Novita AI는 DeepSeek-OCR을 위한 간단한 REST API를 제공합니다. 시작하려면 Novita AI 계정에 가입하고 API 키를 받으세요. API 엔드포인트는 이미지 URL 또는 base64로 인코딩된 이미지와 해상도 모드, 언어 설정, 출력 형식과 같은 구성 매개변수를 허용합니다.
from openai import OpenAI

client = OpenAI(
    base_url="https://api.novita.ai/openai",
    api_key="<Your API Key>",
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr",
    messages=[
      {
        "role": "user",
        "content": [
          {
            "type": "image_url",
            "image_url": {
              "url": "https://example.com/image.png"
            }
          },
          {
            "type": "text",
            "text": "<|grounding|>OCR this image."
          }
        ]
      }
    ],
    stream=False,
    max_tokens=4096
)

content = response.choices[0].message.content

print(content)
기본 사용 패턴
서식이 중요하지 않은 간단한 텍스트 추출의 경우 “Free OCR” 모드를 사용하세요. 레이아웃, 표, 서식을 보존하는 구조화된 문서 파싱의 경우 마크다운 출력과 함께 “grounding” 모드를 사용하세요. 차트, 수식 또는 기하 도형의 고급 파싱의 경우 “Parse the figure” 프롬프트를 사용하세요.
해상도 가이드
올바른 모드 선택
송장, 영수증, 간단한 양식의 경우: 소형 모드(100 토큰)가 최선의 선택입니다. 빠르고 비용 효율적이며 구조화된 데이터 추출에 충분한 정확도를 제공합니다. 이는 대부분의 일상적인 비즈니스 문서 처리 요구를 충족합니다.
비즈니스 문서, 보고서, 계약서의 경우: 기본 모드(256 토큰)는 복잡한 레이아웃을 잘 처리하고 패딩으로 종횡비를 유지합니다. 문서 구조와 서식이 중요할 때 적절한 균형을 제공합니다.
연구 논문 및 기술 문서의 경우: 대형 모드(400 토큰)는 조밀한 텍스트, 수학 공식, 기술 다이어그램에 필요한 정확도를 제공합니다. 더 높은 토큰 수는 정밀도 요구 사항에 의해 정당화됩니다.
신문, 잡지, 다단 레이아웃의 경우: 건담 모드(가변 토큰)가 필수적입니다. 적응형 타일링은 고정 해상도 모드에서는 깨질 수 있는 초고해상도 및 복잡한 다단 레이아웃을 처리합니다. 더 많은 토큰을 사용하지만 여전히 기존 접근 방식보다 훨씬 효율적입니다.
문서 유형별 성능 인사이트
종합적인 OmniDocBench 테스트 결과:
슬라이드 및 단순 문서: 초소형 모드(64 토큰)도 슬라이드에서 0.116의 편집 거리로 놀랍도록 잘 작동하며, 소형 모드는 최적의 가치를 제공합니다. 프레젠테이션 슬라이드는 일반적으로 페이지당 명확한 레이아웃과 제한된 텍스트를 가지기 때문입니다.
도서 및 표준 문서: 소형 모드(100 토큰)는 도서에서 0.085의 편집 거리로 훌륭한 가치를 제공합니다. 대부분의 도서는 페이지당 600~1,000개의 텍스트 토큰을 포함하여 10배 압축 스위트 스팟에 잘 들어맞습니다.
학술 논문: 대형 모드 또는 건담 모드를 권장하며, 건담 모드는 학술 논문에서 0.039의 편집 거리를 달성하여 5~8배 더 많은 토큰을 사용하는 모델을 능가합니다.
신문: 건담 모드는 필수적이며, 초소형 모드의 0.940에 비해 0.122의 편집 거리를 달성합니다. 신문은 페이지당 4,000~5,000개의 텍스트 토큰을 포함하고 있으며, 적응형 타일링 접근 방식이 필요한 복잡한 다단 레이아웃을 가지고 있습니다.
수식 중심 문서: 수학 공식이 포함된 문서의 경우 Gundam-M 모드는 영어 수식에서 0.242의 편집 거리로 최고의 성능을 달성하며, 특수 대형 모델과 경쟁력이 있습니다.
건담 모드 상세 이해
건담 모드는 세부 영역을 캡처하는 여러 로컬 뷰(640×640 타일 2~9개)와 전체 컨텍스트를 유지하는 하나의 글로벌 뷰(1024×1024)를 생성하여 작동합니다. 총 토큰 수는 n×100 + 256으로 계산되며, 여기서 n은 타일 수입니다.
건담 모드를 사용해야 하는 경우: 모든 차원에서 1280픽셀보다 큰 이미지, 다단 레이아웃 문서, 4,000개 이상의 텍스트 토큰이 포함된 콘텐츠, 세부 정보와 컨텍스트가 모두 필요한 복잡한 인포그래픽에 사용하세요.
실제 예시: 작은 신문 페이지는 3개의 타일(총 556 토큰)을 사용할 수 있고, 큰 신문 페이지는 6개의 타일(856 토큰)을 사용합니다. 이를 6,000개 이상의 토큰이 필요한 기존 접근 방식과 비교하면, 가장 복잡한 문서에서도 7~10배 압축을 달성합니다.
결론
Novita AI의 DeepSeek-OCR은 97% 정확도로 10배 압축 을 달성하고, 문서 처리 비용을 최대 85% 절감하며, 100개 언어를 지원하고 GPU당 하루 200,000페이지 이상을 처리합니다.
결과는 스스로 말해줍니다: 월 100,000 문서를 처리하는 기업은 연간 50,000달러 이상을 절약합니다. 처리 속도는 5~10배 향상됩니다. 인프라는 지수 함수가 아닌 선형으로 확장됩니다.
문서 처리를 혁신할 준비가 되셨나요?
몇 분 만에 자신의 문서로 DeepSeek-OCR을 테스트하세요. 신용카드 필요 없음. 다섯 가지 해상도 모드 중에서 선택하고, 100개 언어로 문서를 처리하며, 10배 압축을 직접 경험하세요.
Novita AI는 개발자에게 사용하기 쉬운 API와 저렴하고 안정적인 GPU 인프라를 제공하여 AI 애플리케이션을 구축하고 확장할 수 있도록 지원하는 선도적인 AI 클라우드 플랫폼입니다.