DeepSeek-OCR обеспечивает 10-кратное сжатие текста с точностью 97%, рассматривая изображения как сжатое хранилище для текста. Вместо того чтобы обрабатывать 1000 текстовых токенов по отдельности, модель обрабатывает их как одно изображение, используя всего 100 токенов зрения — это позволяет снизить затраты до 85%.
Теперь доступный на Novita AI, DeepSeek-OCR обрабатывает свыше 200 000 страниц в день на одном GPU, поддерживает 100 языков и предлагает пять режимов разрешения (от 64 до более 400 токенов). Он выходит за рамки традиционного распознавания текста: парсит диаграммы в структурированные данные, распознаёт химические формулы, извлекает геометрические фигуры и обеспечивает инновационное управление памятью для длинных диалогов.
Попробуйте сейчас в Playground Novita AI →
Ищете актуальное поколение? DeepSeek с тех пор выпустил DeepSeek-OCR 2 с более высоким показателем OmniDocBench и лучшей точностью порядка чтения. Для новых интеграций перейдите на API-провайдера DeepSeek OCR2 и используйте идентификатор модели
deepseek/deepseek-ocr-2.
Что такое DeepSeek-OCR?
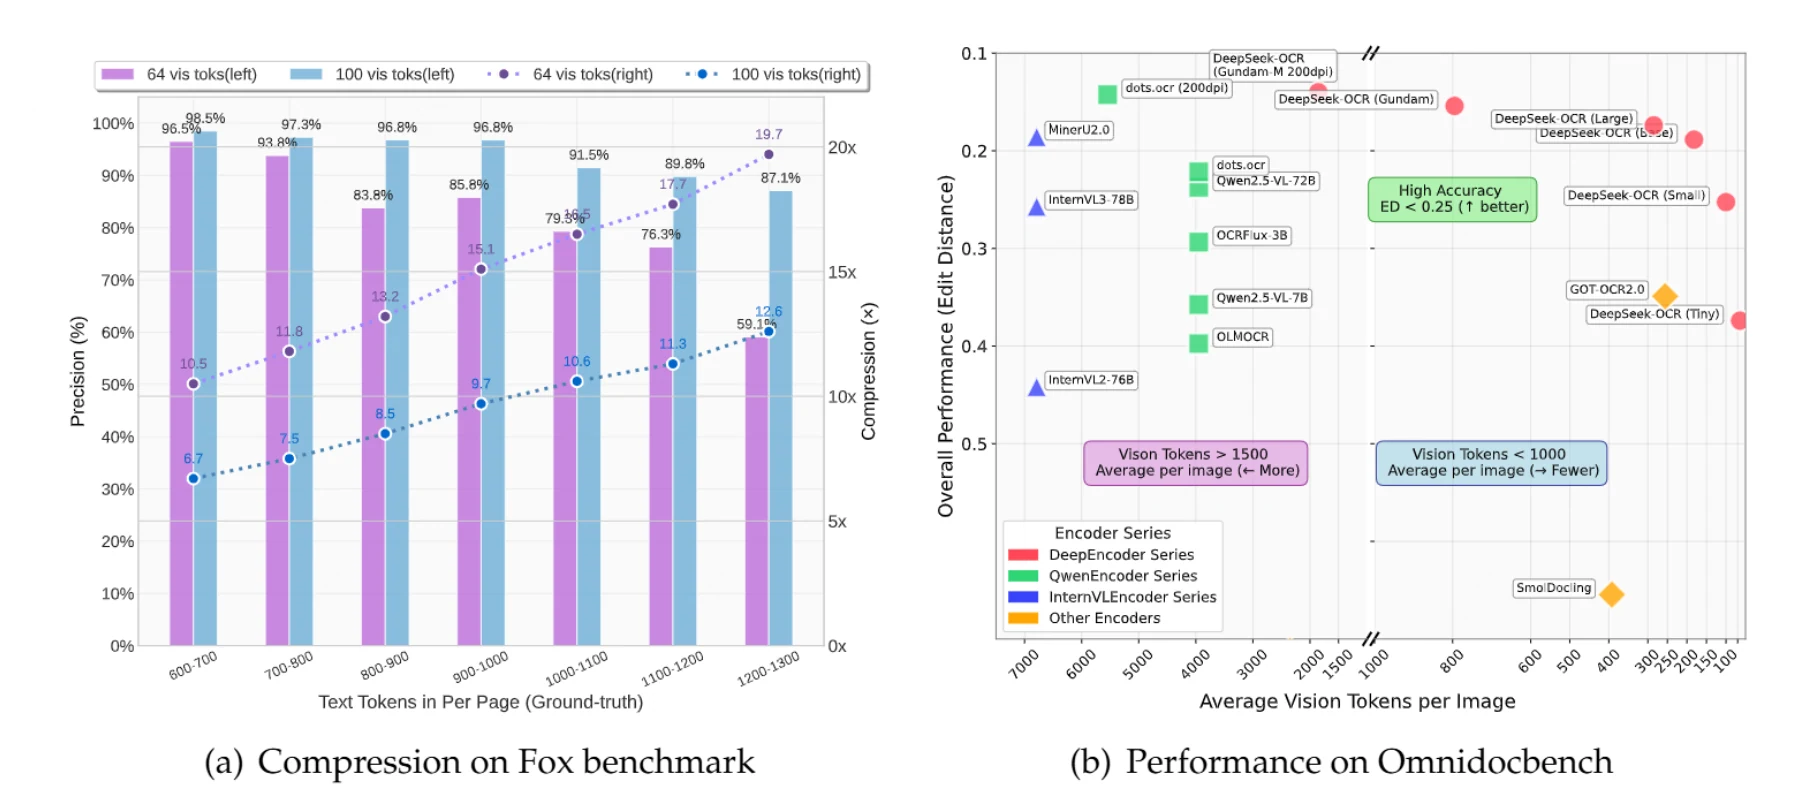
DeepSeek-OCR — это визионно-языковая модель, которая рассматривает изображения как сжатое хранилище для текста. Вместо обработки документа с 1000 текстовых токенов по отдельности (что требует больших вычислительных затрат) модель обрабатывает его как одно изображение, используя всего 100 токенов зрения — это 10-кратное сокращение вычислительных расходов.
Базовая архитектура
Модель состоит из двух ключевых компонентов:
DeepEncoder (~380 млн параметров): Специализированный кодировщик изображений, который эффективно обрабатывает изображения документов, используя уникальную последовательную архитектуру, объединяющую оконное внимание (SAM) и глобальное внимание (CLIP) со слоем 16-кратного сжатия между ними.
DeepSeek3B-MoE Decoder (570 млн активных параметров): Компактная языковая модель на основе смеси экспертов (MoE), которая преобразует сжатые визуальные данные обратно в текст с высокой точностью.
Такая архитектура обеспечивает беспрецедентную эффективность обработки документов, что делает её идеальной для компаний, работающих с большими объёмами документов, или для приложений, требующих понимания длинного контекста.
Почему оптическое сжатие имеет значение
Традиционная проблема
Традиционная обработка текста в моделях ИИ масштабируется квадратично — удвоение длины документа может привести к четырёхкратному увеличению затрат. Для компаний, обрабатывающих тысячи документов ежедневно, это становится непомерно дорогим.
Решение DeepSeek-OCR
Документы объёмом до 1000 текстовых токенов можно сжать в 10 раз с точностью 97%. Даже при 20-кратном сжатии точность остаётся на уровне около 60% — что часто достаточно для многих применений.
Реальный пример:
Документ, содержащий 900 текстовых токенов, традиционно требует 900 токенов для обработки. С DeepSeek-OCR в режиме Small (100 токенов зрения) вы достигаете 9,7-кратного сжатия с точностью 96,8%. Для документов с 1100 текстовыми токенами сжатие составляет 10,6× при точности 91,5%.
Влияние на бизнес
Снижение затрат на API: Обработка до 10 раз меньшего количества токенов для типовых документов означает значительную экономию средств — компания, обрабатывающая 1 миллион страниц ежемесячно, может сэкономить более $50 000 в год.
Ускорение обработки: Меньшее количество токенов напрямую сокращает время отклика, улучшая пользовательский опыт и позволяя создавать приложения реального времени.
Лучшая масштабируемость: Обрабатывайте в 10 раз больше документов с теми же инвестициями в инфраструктуру, делая рост более предсказуемым и доступным.
Эффективность памяти: Храните историю диалогов в виде сжатых изображений, что позволяет создавать приложения со сверхдлинным контекстом без экспоненциального роста требований к памяти.
Производительность и бенчмарки
Комплексные результаты OmniDocBench
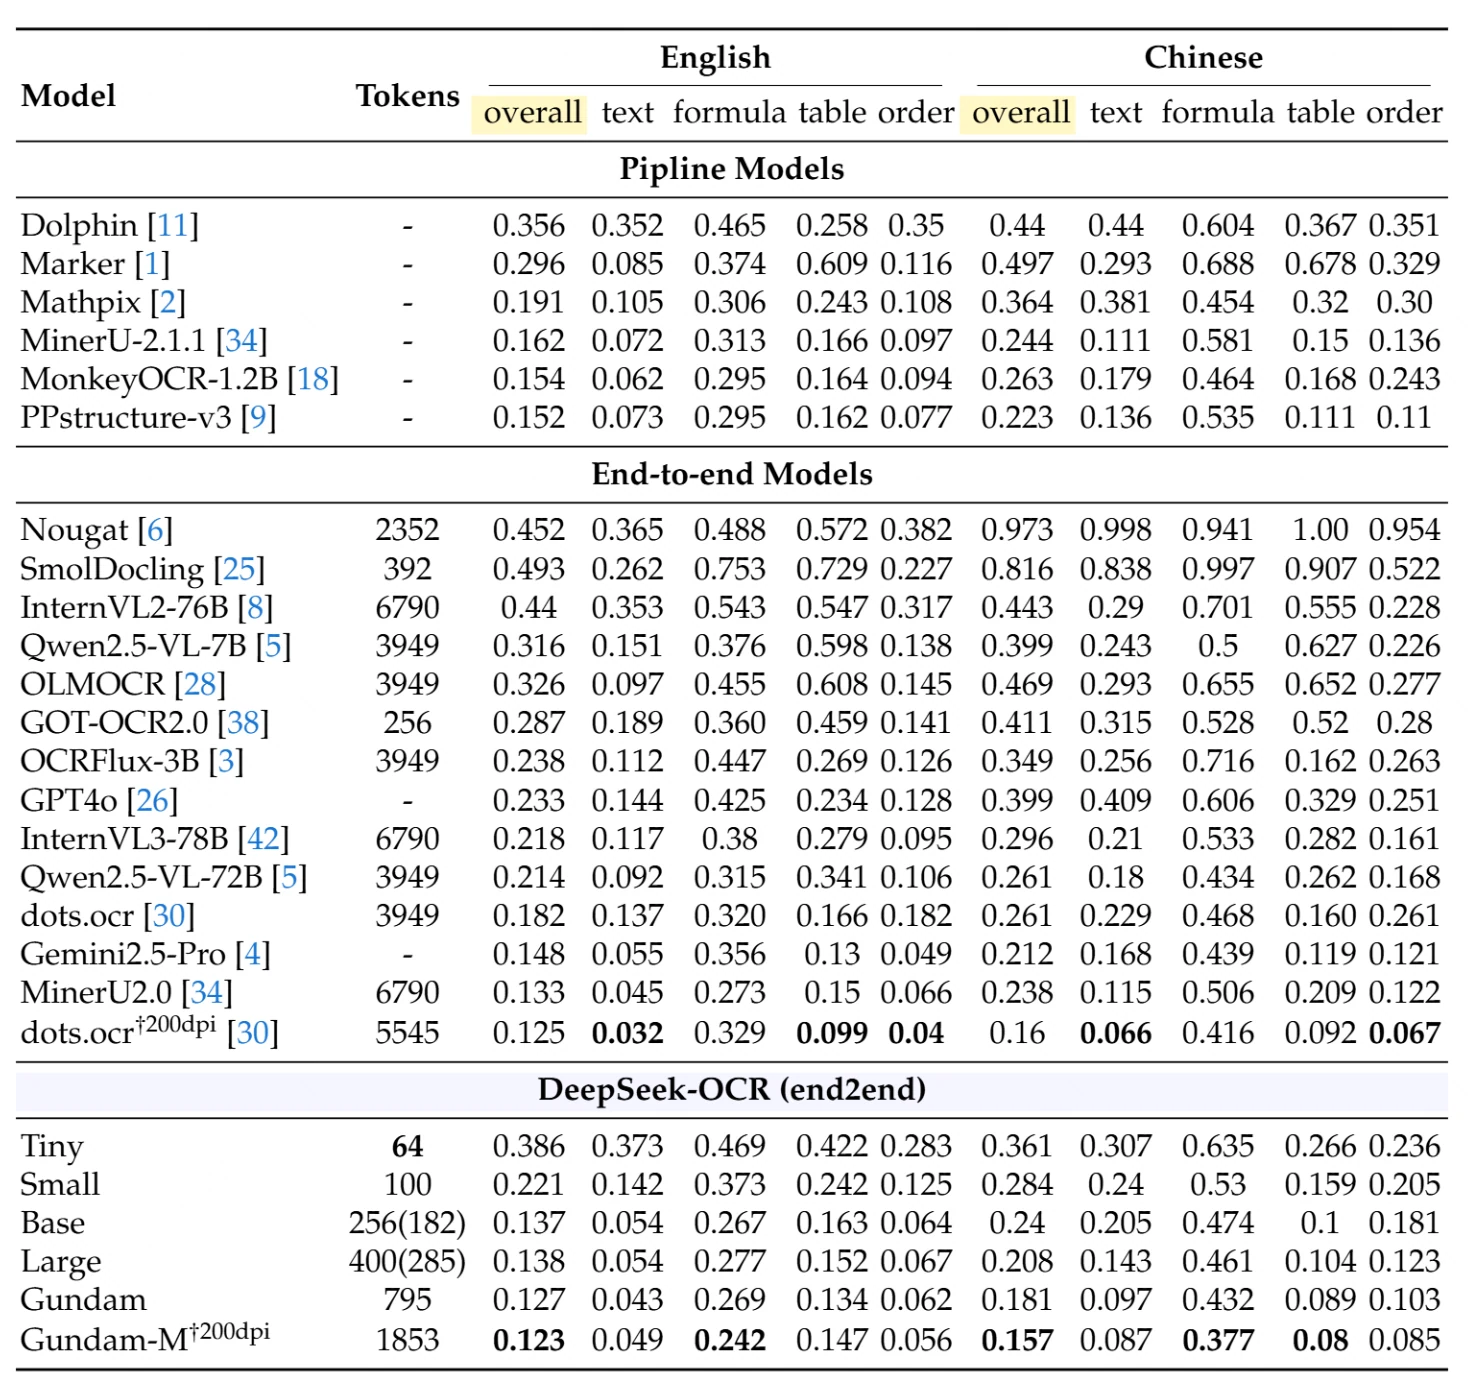
На бенчмарке OmniDocBench, комплексном эталоне разбора документов, DeepSeek-OCR достигает исключительной производительности при минимальном использовании ресурсов. Таблица ниже показывает подробные сравнения по разным типам документов и языкам (расстояние редактирования — чем меньше, тем лучше):
Ключевые моменты:
Конвейерные модели (традиционные многоэтапные подходы): Лучшая конвейерная модель, PPstructure-v3, показывает 0,152 в целом по английскому и 0,223 по китайскому языкам, но требует сложной многомодельной инфраструктуры.
Сквозные модели (одномодельные подходы): Среди конкурентов MinerU2.0, использующий 6 790 токенов, достигает 0,133 по английскому и 0,238 по китайскому. Qwen2.5-VL-72B с 3 949 токенами набирает 0,214 по английскому и 0,261 по китайскому.
Производительность DeepSeek-OCR:
- Режим Small (100 токенов): 0,221 по английскому в целом, 0,284 по китайскому в целом
- Режим Base (256 токенов): 0,137 по английскому в целом, 0,240 по китайскому в целом
- Режим Gundam (795 токенов): 0,127 по английскому в целом, 0,181 по китайскому в целом
- Режим Gundam-M при 200 dpi (1 853 токена): 0,123 по английскому в целом, 0,157 по китайскому в целом — достигает самых современных результатов
Замечательное достижение: Режим Base от DeepSeek-OCR, используя всего 256 токенов, превосходит модели, использующие в 15-26 раз больше токенов. Режим Gundam-M показывает наилучшую общую производительность среди всех сквозных моделей, при этом используя значительно меньше токенов, чем традиционные подходы.
Производительность по категориям
Распознавание текста: DeepSeek-OCR (Gundam-M) показывает 0,049 по английскому тексту и 0,087 по китайскому тексту, превосходя даже Gemini2.5-Pro.
Распознавание формул: С показателем 0,242 по английским формулам и 0,377 по китайским формулам DeepSeek-OCR демонстрирует высокую способность работы с математическим содержанием.
Извлечение таблиц: Результаты 0,147 по английским таблицам и 0,08 по китайским таблицам свидетельствуют о надёжном извлечении структурированных данных.
Производственные возможности
Скорость обработки: Один GPU A100-40G может обрабатывать свыше 200 000 страниц в день. Масштабирование до 20 узлов (160 GPU) позволяет обрабатывать 33 миллина страниц в день — достаточно для самых требовательных корпоративных нагрузок.
Эффективность затрат: Для компании, обрабатывающей 1 миллион страниц документов в месяц, разница очевидна. Традиционные модели, требующие 6 000 токенов на страницу, потребляют 6 миллиардов токенов в общей сложности. DeepSeek-OCR при 800 токенах на страницу использует всего 800 миллионов токенов — снижение использования токенов на 87% и связанных с этим затрат.
Ключевые функции и возможности
1. Поддержка многих языков
DeepSeek-OCR поддерживает почти 100 языков — от основных мировых (английский, китайский, испанский, арабский, хинди) до специализированных письменностей (тайский, иврит, кириллица). Это устраняет необходимость в языко-специфичных OCR-сервисах и упрощает международные операции.
2. Продвинутое понимание документов
Модель распознаёт гораздо больше, чм просто текст. Она парсит диаграммы в структурированные данные, извлекает математические формулы с форматированием LaTeX, определяет геометрические фигуры с выводом в SVG и сохраняет структуру таблиц, включая объединённые ячейки и сложное форматирование.
3. Гибкие форматы вывода
Выбирайте между простым извлечением текста (самый быстрый), Markdown с сохранением форматирования, HTML для встраивания в веб-приложения или структурированным JSON для программной обработки. Режим grounding сохраняет пространственные взаимоотношения, гарантируя, что извлечённые данные сохраняют структуру исходного документа.
4. Оптическое сжатие для длинного контекста
Храните историю диалогов в виде сжатых изображений вместо текстовых токенов. Разговор из 10 реплик, который традиционно потребовал бы 10 000 текстовых токенов, может быть сжат до 1 000 токенов зрения, что позволяет создавать приложения со сверхдлинными окнами контекста при устойчивых затратах.
Эффект: Чат-приложения могут поддерживать контекст на протяжении сотен реплик без экспоненциального роста затрат, обеспечивая по-настоящему длинные AI-взаимодействия.
Начало работы на Novita AI
Понимание режимов разрешения
Novita AI предоставляет DeepSeek-OCR с пятью режимами разрешения, разработанными для баланса производительности, скорости и стоимости в различных сценариях использования.
Нативные режимы разрешения:
Режим Tiny (512×512, 64 токена): Оптимизирован для простых документов, где скорость является приоритетом. Идеален для чеков, простых форм или задач быстрого извлечения текста.
Режим Small (640×640, 100 токено): Оптимальный вариант для большинства приложений. Предлагает лучший баланс точности, скорости и стоимости. Идеален для стандартных деловых документов, счетов-фактур и отчётов.
Режим Base (1024×1024, 256 токенов): Обрабатывает сложные макеты с сохранением соотношений сторон с помощью заполнения (padding). Рекомендуется для контрактов, подробных отчётов и документов, где важна структура.
Режим Large (1280×1280, 400 токенов): Максимальное качество для детализированных документов высокого разрешения. Лучше всего подходит для научных статей, технических документов с формулами и требований к премиальному качеству.
Режим динамического разрешения:
Режим Gundam (n×640×640 + 1×1024×1024, переменное количество токенов): Адаптивная тайловая разбивка для документов сверхвысокого разрешения. Автоматически разбивает большие изображения на 2-9 локальных видов размером 640×640 плюс один глобальный вид размером 1024×1024. Необходим для газет, журналов и сложных многоколоночных макетов. Для изображений меньшего размера, чем 640×640, автоматически переходит в режим Base.
Доступ к API DeepSeek-OCR
Novita AI предоставляет простой REST API для DeepSeek-OCR. Чтобы начать работу, зарегистрируйтесь в Novita AI и получите свой API-ключ. Конечная точка API принимает URL изображений или изображения в кодировке base64 вместе с параметрами конфигурации, такими как режим разрешения, языковые предпочтения и формат вывода.
from openai import OpenAI

client = OpenAI(
    base_url="https://api.novita.ai/openai",
    api_key="<Ваш API-ключ>",
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr",
    messages=[
      {
        "role": "user",
        "content": [
          {
            "type": "image_url",
            "image_url": {
              "url": "https://example.com/image.png"
            }
          },
          {
            "type": "text",
            "text": "<|grounding|>OCR this image."
          }
        ]
      }
    ],
    stream=False,
    max_tokens=4096
)

content = response.choices[0].message.content

print(content)
Базовые сценарии использования
Для простого извлечения текста, когда форматирование не имеет значения, используйте режим «Free OCR». Для структурированного разбора документов с сохранением макета, таблиц и форматирования используйте режим “grounding” с выводом в Markdown. Для продвинутого разбора диаграмм, формул или геометрических фигур используйте подсказку «Parse the figure».
Руководство по выбору разрешения
Выбор правильного режима
Для счётов-фактур, чеков и простых форм: Режим Small (100 токенов) — ваш лучший выбор. Он быстрый, экономичный и обеспечивает достаточную точность для извлечения структурированных данных. Это покрывает большинство потребностей рутинной обработки деловых документов.
Для деловых документов, отчётов и контрактов: Режим Base (256 токенов) хорошо справляется со сложными макетами и сохраняет соотношения сторон с помощью заполнения. Это правильный баланс, когда важны структура документа и форматирование.
Для научных статей и технических документов: Режим Large (400 токенов) обеспечивает точность, необходимую для плотного текста, математических формул и технических диаграмм. Более высокое количество токенов оправдано требованиями к точности.
Для газет, журналов и многоколоночных макетов: Режим Gundam (переменное количество токенов) незаменим. Его адаптивная тайловая разбивка справляется со сверхвысоким разрешением и сложными многоколоночными макетами, которые были бы искажены в режимах с фиксированным разрешением. Хотя он использует больше токенов, он всё равно гораздо эффективнее традиционных подходов.
Показатели производительности по типу документа
На основе результатов комплексного тестирования OmniDocBench:
Слайды и простые документы: Даже режим Tiny (64 токена) показывает удивительно хорошие результаты с расстоянием редактирования 0,116 для слайдов, в то время как режим Small предлагает оптимальное соотношение цена-качество. Это связано с тем, что презентационные слайды обычно имеют чёткие макеты и ограниченный объём текста на странице.
Книги и стандартные документы: Режим Small (100 токенов) предлагает отличное соотношение цена-качество при расстоянии редактирования 0,085 для книг. Большинство книг содержат 600-1 000 текстовых токенов на страницу, что хорошо вписывается в 10-кратное сжатие.
Научные статьи: Рекомендуются режимы Large или Gundam, причём Gundam достигает расстояния редактирования 0,039 для научных статей — превосходя модели, использующие в 5-8 раз больше токенов.
Газеты: Режим Gundam обязателен, достигая расстояния редактирования 0,122 по сравнению с 0,940 для режима Tiny. Газеты содержат 4 000-5 000 текстовых токенов на страницу со сложными многоколоночными макетами, которые требуют адаптивного тайлового подхода.
Документы с большим содержанием формул: Для документов с математическими формулами режим Gundam-M показывает наилучшую производительность с расстоянием редактирования 0,242 для английских формул, что сопоставимо со специализированными большими моделями.
Подробный разбор режима Gundam
Режим Gundam работает, создавая несколько локальных видов (2-9 тайлов по 640×640), которые захватывают детализированные области, плюс один глобальный вид (1024×1024), который сохраняет общий контекст. Общее количество токенов вычисляется как n×100 + 256, где n — количество тайлов.
Когда использовать режим Gundam: Используйте его для изображений, размер которых превышает 1280 пикселей в любом измерении, для документов с многоколоночными макетами, для содержимого с 4 000+ текстовых токенов или для сложных инфографик, требующих как детализации, так и контекста.
Реальный пример: Небольшая газетная страница может использовать 3 тайла (всего 556 токенов), в то время как большая газетная страница использует 6 тайлов (856 токенов). Сравните это с традиционными подходами, требующими 6 000+ токенов — вы всё ещё достигаете 7-10-кратного сжатия даже для самых сложных документов.
Заключение
DeepSeek-OCR на Novita AI достигает 10-кратного сжатия с точностью 97%, сокращая затраты на обработку документов до 85%, поддерживая при этом 100 языков и обрабатывая более 200 000 страниц на GPU в день.
Результаты говорят сами за себя: Компании, обрабатывающие 100 000 документов ежемесячно, экономят более $50 000 в год. Скорость обработки увеличивается в 5-10 раз. Инфраструктура масштабируется линейно, а не экспоненциально.
Гтовы изиенить обрабтку документов?
Начните бесплатно в Playground →
Протестируйте DeepSeek-OCR на своих собственных документах за считанные минуты. Кредитная карта не требуется. Выбирайте из пяти режимов разрешения, обрабатывайте документы на 100 языках и оцените 10-кратное сжатие лично.
Novita AI — это ведущая облачная AI-платформа, предоставляющая разработчикам простые в использовании API и доступную надёжную GPU-инфраструктуру для создания и масштабирования AI-приложений.