DeepSeek-OCRは、画像をテキストの圧縮ストレージとして扱うことで、97%の精度で10倍のテキスト圧縮 を実現します。1,000個のテキストトークンを個別に処理する代わりに、わずか100個のビジョントークンで1枚の画像として処理し、コストを最大85%削減します。
Novita AIで利用可能になったDeepSeek-OCRは、**GPU1台あたり1日20万ページ以上 ** を処理し、100言語 に対応、5種類の解像度モード(64トークンから400トークン以上)を提供します。従来のOCRを超えて、チャートを構造化データに解析し、化学式を認識し、幾何学図形を抽出し、長い会話のための革新的なメモリ管理を可能にします。
最新世代をお探しですか? DeepSeekはその後、DeepSeek-OCR 2をリリースしており、OmniDocBenchスコアが向上し、読み順の精度が向上しています。新しい統合については、DeepSeek OCR2 API Providerを参照し、モデルID
deepseek/deepseek-ocr-2を使用してください。
DeepSeek-OCRとは?
DeepSeek-OCRは、画像をテキストの圧縮ストレージとして扱うビジョン言語モデルです。1,000個のテキストトークンを含むドキュメントを個別に処理する(計算コストが高い)代わりに、わずか100個のビジョントークンで1枚の画像として処理します。これにより、処理コストが 10分の1 になります。
コアアーキテクチャ
このモデルは、2つの主要コンポーネントで構成されています。
DeepEncoder(約3億8000万パラメータ):特殊なビジョンエンコーダで、ウィンドウアテンション(SAM)とグローバルアテンション(CLIP)を組み合わせた独自のシリアルアーキテクチャと、その間の16倍圧縮層を使用して、ドキュメント画像を効率的に処理します。
DeepSeek3B-MoEデコーダ(5億7000万のアクティブパラメータ):コンパクトな混合専門家言語モデルで、圧縮された視覚情報をテキストに変換し、驚くべき精度を実現します。
このアーキテクチャにより、文書処理において前例のない効率性が実現され、大量の文書を扱う企業や、長いコンテキストの理解を必要とするアプリケーションに最適です。
光学的圧縮が重要な理由
従来の問題点
AIモデルにおける従来のテキスト処理は二次関数的にスケールします。つまり、ドキュメントの長さを2倍にすると、コストが4倍になる可能性があります。毎日数千の文書を処理する企業にとって、これは法外なコストになります。
DeepSeek-OCRのソリューション
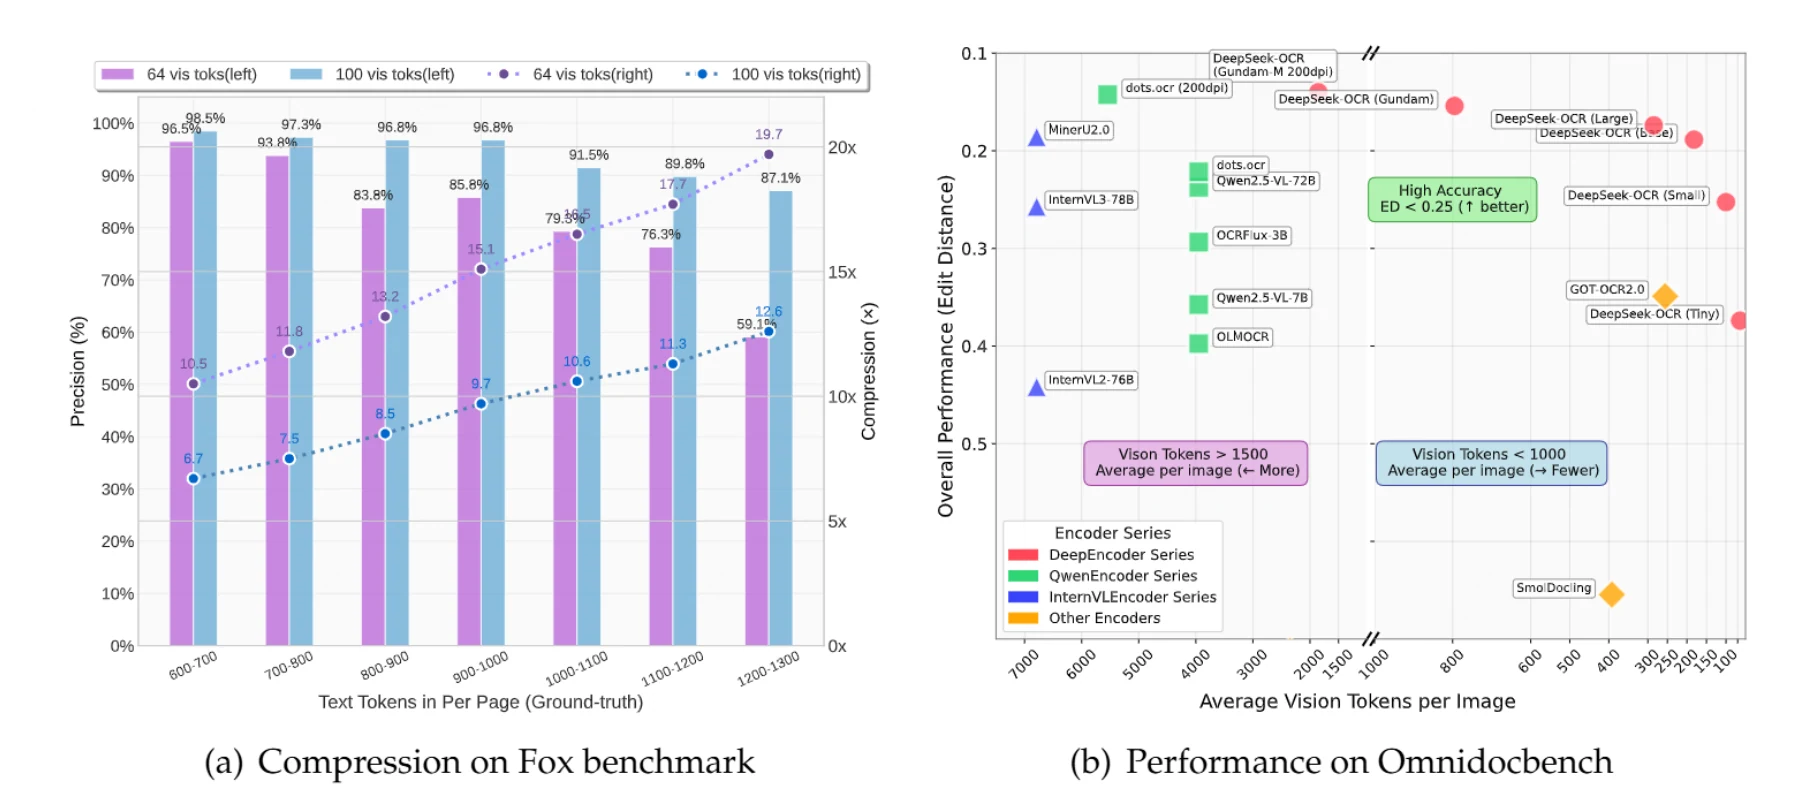
最大1,000テキストトークンの文書は、97%の精度 で10倍に圧縮できます。20倍の圧縮でも、精度は約60%に留まり、多くのアプリケーションでは十分な場合が多いです。
実際の例:
900テキストトークンを含む文書は、従来は900トークンで処理する必要がありました。DeepSeek-OCRのSmallモード(100ビジョントークン)を使用すると、**96.8%の精度で9.7倍の圧縮 ** を実現します。1,100テキストトークンの文書では、91.5%の精度で10.6倍の圧縮 が得られます。
ビジネスへの影響
APIコストの削減:一般的な文書では、処理されるトークンが最大10分の1になるため、コストが大幅に削減されます。毎月100万ページを処理する企業は、年間5万ドル以上を節約できます。
処理速度の向上:トークンが少ないことは、応答時間の短縮に直接つながり、ユーザーエクスペリエンスが向上し、リアルタイムアプリケーションが可能になります。
スケーラビリティの向上:同じインフラストラクチャへの投資で10倍多くの文書を処理できるため、成長がより予測可能で手頃な価格になります。
メモリ効率:会話履歴を圧縮画像として保存することで、指数関数的なメモリ要件なしに、超長いコンテキストアプリケーションを実現できます。
パフォーマンスとベンチマーク
OmniDocBenchの包括的な結果
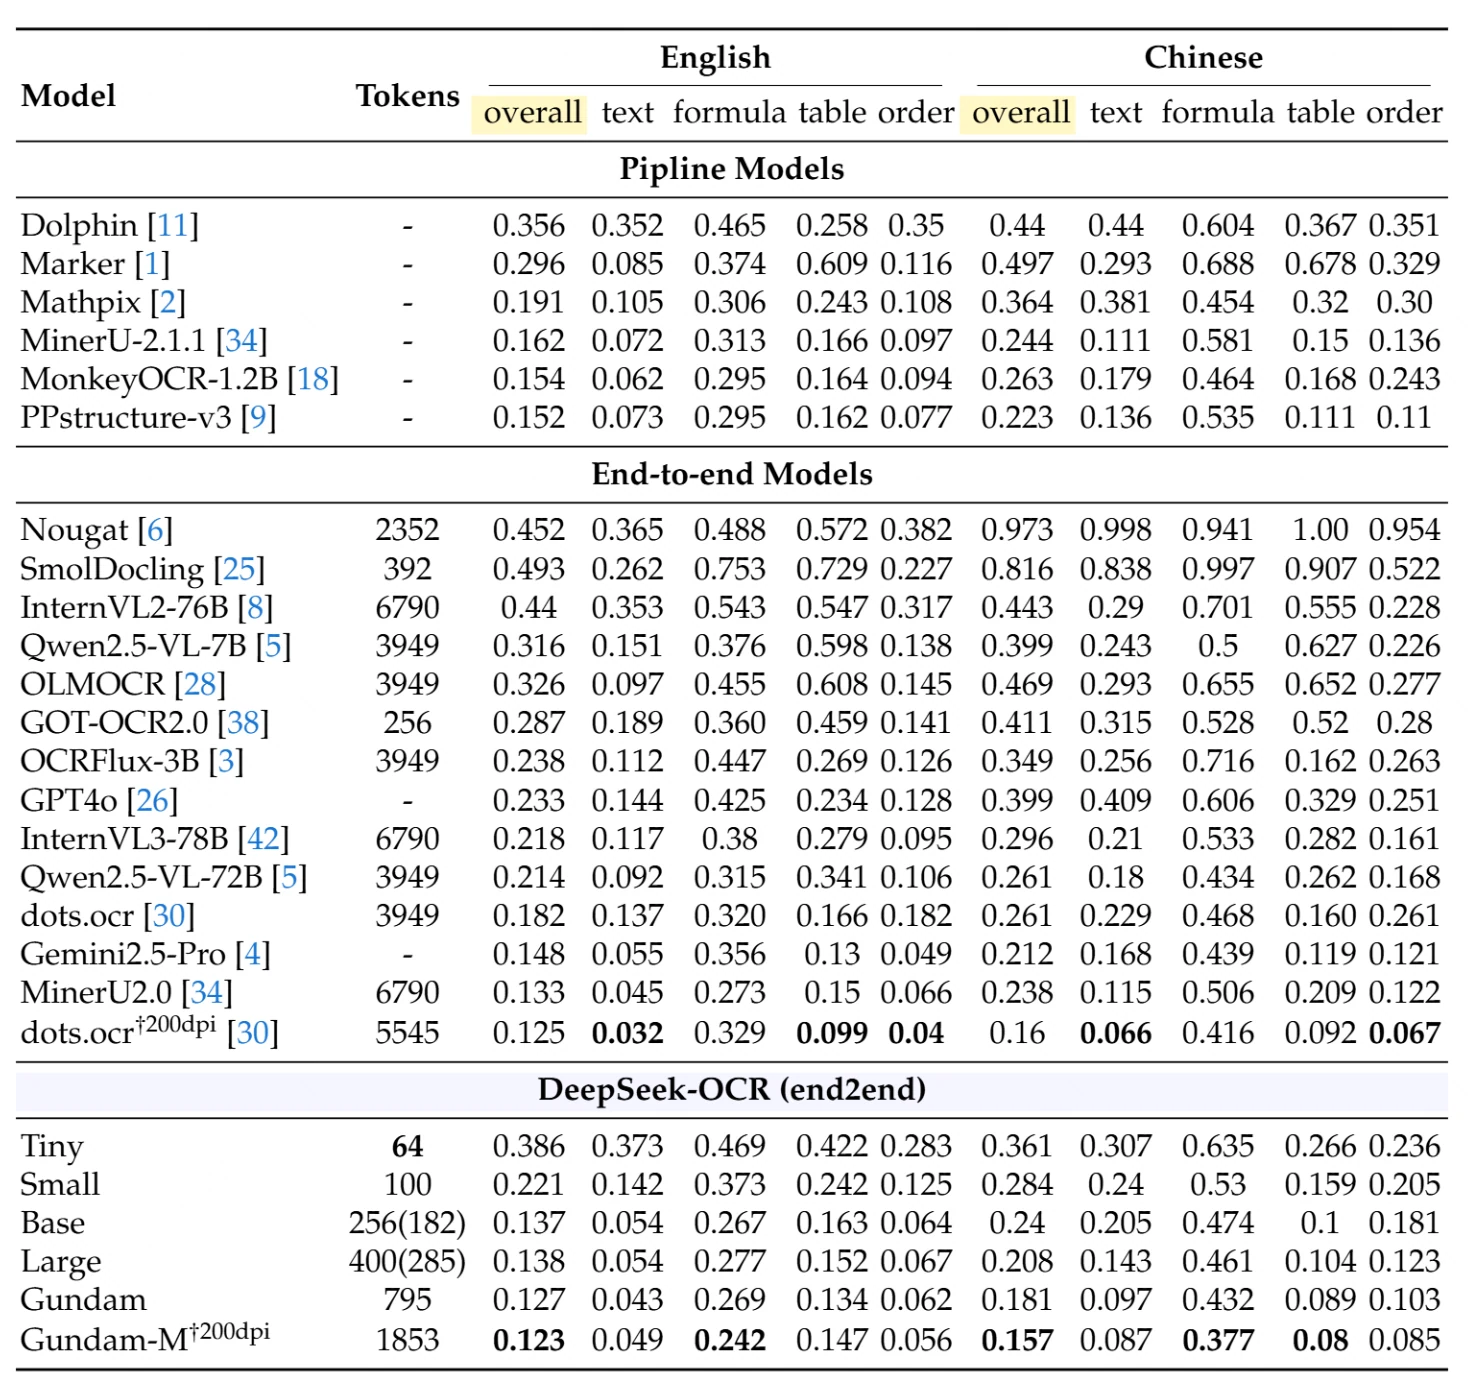
包括的な文書解析ベンチマークであるOmniDocBenchにおいて、DeepSeek-OCRは最小限のリソース使用で卓越したパフォーマンスを達成しています。以下の表は、さまざまな文書タイプと言語における詳細な比較を示しています(編集距離 - 低いほど良い):
主なハイライト:
パイプラインモデル(従来の多段階アプローチ):最も性能の高いパイプラインモデルであるPPstructure-v3は、英語全体で0.152、中国語で0.223を達成していますが、複雑なマルチモデルインフラストラクチャが必要です。
エンドツーエンドモデル(単一モデルアプローチ):競合他社の中で、6,790トークンを使用するMinerU2.0は英語で0.133、中国語で0.238を達成しています。Qwen2.5-VL-72B(3,949トークン)は英語で0.214、中国語で0.261です。
DeepSeek-OCRのパフォーマンス:
- Smallモード(100トークン):英語全体0.221、中国語全体0.284
- Baseモード(256トークン):英語全体0.137、中国語全体0.240
- Gundamモード(795トークン):英語全体0.127、中国語全体0.181
- Gundam-M(200dpi、1,853トークン):** 英語全体0.123、中国語全体0.157** - 最先端の結果を達成
注目すべき成果:わずか256トークンのDeepSeek-OCR Baseモードは、15〜26倍多くのトークンを使用するモデルを上回っています。Gundam-Mモードは、従来のアプローチよりも大幅に少ないトークンを使用しながら、すべてのエンドツーエンドモデルの中で最高の総合パフォーマンスを達成しています。
カテゴリ別パフォーマンス
テキスト認識 :DeepSeek-OCR(Gundam-M)は、 英語テキストで0.049、** 中国語テキストで0.087**を達成し、Gemini2.5-Proをも凌駕します。
数式認識 : 英語数式で0.242、** 中国語数式で0.377**と、DeepSeek-OCRは数学コンテンツにおける強力な能力を示しています。
表抽出 : 英語表で0.147、** 中国語表で0.08**のスコアは、堅牢な構造化データ抽出を示しています。
プロダクション能力
処理速度:1台のA100-40G GPUで1日あたり20万ページ以上を処理できます。20ノード(160 GPU)にスケールすると、1日あたり3,300万ページとなり、最も要求の厳しいエンタープライズワークロードにも十分対応できます。
コスト効率 :毎月100万ページの文書を処理する企業の場合、その差は明らかです。ページあたり6,000トークンを必要とする従来のモデルは、合計60億トークンを消費します。DeepSeek-OCRをページあたり800トークンで使用すると、わずか8億トークンしか使用しません。これは、トークン使用量と関連コストの87%削減 です。
主な機能と能力
1. 多言語対応
DeepSeek-OCRは、主要な世界言語(英語、中国語、スペイン語、アラビア語、ヒンディー語)から特殊なスクリプト(タイ語、ヘブライ語、キリル文字)まで、約100言語 をサポートしています。これにより、言語固有のOCRサービスが不要になり、国際業務が簡素化されます。
2. 高度な文書理解
このモデルは、テキストだけではなく、さらに多くのものを認識します。チャートを構造化データに解析し、LaTeX形式で数式を抽出し、SVG出力で幾何学図形を識別し、結合セルや複雑な書式を含む表構造を維持します。
3. 柔軟な出力形式
最速のプレーンテキスト抽出、書式を保持したマークダウン、Web統合用のHTML、プログラム処理用の構造化JSONから選択できます。グラウンディングモードは空間的関係を保存し、抽出されたデータが元の文書の構造を維持することを保証します。
4. 長いコンテキストのための光学的圧縮
会話履歴をテキストトークンではなく圧縮画像として保存します。従来は10,000トークンを消費する10ターンの会話が、1,000ビジョントークンに圧縮され、持続可能なコストで超長いコンテキストウィンドウを持つアプリケーションを可能にします。
その影響:チャットアプリケーションは、指数関数的なコスト増加なしに、数百の会話ターンにわたってコンテキストを維持でき、真に長大なAIインタラクションを実現します。
Novita AIで始める
解像度モードを理解する
Novita AIは、さまざまなユースケースに合わせてパフォーマンス、速度、コストのバランスをとる 5つの解像度モード を備えたDeepSeek-OCRを提供しています。
ネイティブ解像度モード:
Tinyモード(512×512、64トークン):最大速度が優先されるシンプルな文書に最適化されています。レシート、簡易フォーム、簡単なテキスト抽出タスクに最適です。
Smallモード(640×640、100トークン):ほとんどのアプリケーションに最適なバランスです。精度、速度、コストの最良のバランスを提供します。標準的なビジネス文書、請求書、レポートに最適です。
Baseモード(1024×1024、256トークン):パディングを使用してアスペクト比を保持しながら、複雑なレイアウトを処理します。契約書、詳細なレポート、レイアウトが重要な文書に推奨されます。
Largeモード(1280×1280、400トークン):高解像度の詳細文書向けの最大品質です。研究論文、数式を含む技術文書、プレミアム品質の要件に最適です。
動的解像度モード:
Gundamモード(n×640×640 + 1×1024×1024、可変トークン):超高解像度文書向けの適応型タイリング。大きな画像を640×640の2~9個のローカルビューと、1024×1024の1つのグローバルビューに自動的に分割します。新聞、雑誌、複雑なマルチカラムレイアウトに不可欠です。画像が640×640より小さい場合は、自動的にBaseモードにダウングレードします。
DeepSeek-OCR APIへのアクセス
Novita AIは、DeepSeek-OCR向けのシンプルなREST APIを提供しています。開始するには、Novita AIアカウントにサインアップし、APIキーを取得してください。APIエンドポイントは、画像URLまたはbase64エンコードされた画像と、解像度モード、言語設定、出力形式などの設定パラメータを受け入れます。
from openai import OpenAI

client = OpenAI(
    base_url="https://api.novita.ai/openai",
    api_key="<Your API Key>",
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr",
    messages=[
      {
        "role": "user",
        "content": [
          {
            "type": "image_url",
            "image_url": {
              "url": "https://example.com/image.png"
            }
          },
          {
            "type": "text",
            "text": "<|grounding|>OCR this image."
          }
        ]
      }
    ],
    stream=False,
    max_tokens=4096
)

content = response.choices[0].message.content

print(content)
基本的な使用パターン
書式が重要でない単純なテキスト抽出には、「Free OCR」モードを使用します。レイアウト、表、書式を保持する構造化文書解析には、「grounding」モードとマークダウン出力を使用します。チャート、数式、幾何学図形の高度な解析には、「Parse the figure」プロンプトを使用します。
解像度ガイド
適切なモードの選択
請求書、レシート、簡易フォームの場合:Smallモード(100トークン)が最適です。高速でコスト効率が高く、構造化データ抽出に十分な精度を提供します。これで、ほとんどの日常的なビジネス文書処理ニーズをカバーできます。
ビジネス文書、レポート、契約書の場合:Baseモード(256トークン)は複雑なレイアウトを適切に処理し、パディングでアスペクト比を保持します。文書の構造と書式が重要な場合の適切なバランスです。
研究論文や技術文書の場合:Largeモード(400トークン)は、密集したテキスト、数式、技術図に必要な精度を提供します。精度要件によって、より高いトークン数が正当化されます。
新聞、雑誌、マルチカラムレイアウトの場合:Gundamモード(可変トークン)が不可欠です。その適応型タイリングは、固定解像度モードでは文字化けする超高解像度や複雑なマルチカラムレイアウトを処理します。より多くのトークンを使用しますが、従来のアプローチよりもはるかに効率的です。
文書タイプ別のパフォーマンスインサイト
包括的なOmniDocBenchテストに基づく:
スライドとシンプルな文書:Tinyモード(64トークン)でもスライドで0.116の編集距離と驚くほどのパフォーマンスを発揮し、Smallモードは最適な価値を提供します。これは、プレゼンテーションスライドが通常、明確なレイアウトと1ページあたりのテキスト量が限られているためです。
書籍と標準的な文書:Smallモード(100トークン)は、書籍で0.085の編集距離と優れた価値を提供します。ほとんどの書籍には1ページあたり600~1,000テキストトークンが含まれており、10倍圧縮のスイートスポット内に十分収まります。
学術論文:LargeモードまたはGundamモードが推奨され、Gundamは学術論文で0.039の編集距離を達成し、5~8倍多くのトークンを使用するモデルを上回ります。
新聞:Gundamモードが不可欠で、Tinyモードの0.940に対して0.122の編集距離を達成します。新聞には1ページあたり4,000~5,000テキストトークンが含まれ、複雑なマルチカラムレイアウトがあるため、適応型タイリングアプローチが必要です。
数式の多い文書:数式を含む文書では、Gundam-Mモードが英語数式で0.242の編集距離と最高のパフォーマンスを達成し、特殊な大規模モデルと競合します。
Gundamモードの詳細
Gundamモードは、詳細な領域をキャプチャする複数のローカルビュー(640×640の2~9タイル)と、全体的なコンテキストを維持する1つのグローバルビュー(1024×1024)を作成することで機能します。合計トークン数は、n×100 + 256(nはタイル数)として計算されます。
Gundamモードを使用するタイミング:画像がいずれかの寸法で1280ピクセルより大きい場合、マルチカラムレイアウトの文書、4,000以上のテキストトークンを含むコンテンツ、または詳細とコンテキストの両方が必要な複雑なインフォグラフィックに使用します。
実際の例:小さな新聞ページでは3タイル(合計556トークン)を使用する場合があり、大きな新聞ページでは6タイル(856トークン)を使用します。これを6,000トークン以上を必要とする従来のアプローチと比較すると、最も複雑な文書でも7~10倍の圧縮を達成しています。
まとめ
Novita AI上のDeepSeek-OCRは、97%の精度で10倍の圧縮 を実現し、文書処理コストを最大85%削減しながら、100言語をサポートし、GPU1台あたり1日20万ページ以上を処理します。
結果は物語っています:毎月10万文書を処理する企業は、年間5万ドル以上を節約しています。処理速度は5~10倍向上します。インフラストラクチャは指数関数的ではなく線形にスケールします。
文書処理を変革する準備はできましたか?
Playgroundで無料で始める → (注:原文のURLが壊れている可能性があります。以下が正しいです)
数分でご自身の文書でDeepSeek-OCRをテストできます。クレジットカードは不要です。5つの解像度モードから選択し、100言語で文書を処理し、10倍の圧縮を実際に体験してください。
Novita AI は、開発者に使いやすいAPIと手頃な価格で信頼性の高いGPUインフラストラクチャを提供し、AIアプリケーションの構築とスケーリングを支援する、大手AIクラウドプラットフォームです。