主なハイライト
Core Difference: Gemma 3 27B は、画像とテキストの両方を処理できる多用途で効率的な ** マルチモーダル ** モデルです。Llama 3.3 70B は、より大きく、複雑な推論と指示追跡タスクに最適化された ** テキスト専用** の強力なモデルです。
パフォーマンス: Llama 3.3 70B は、コーディング、指示追跡、一般知識などのテキスト中心のベンチマークで概ねリードしています。Gemma 3 27B は数学で強力なパフォーマンスを発揮し、視覚理解という独自の利点を備えています。
ハードウェアアクセシビリティ: Gemma 3 27B は効率性を重視して設計されており、単一のハイエンド GPU で実行できる最も高性能なモデルの 1 つとされ、ローカル展開がより容易です。Llama 3.3 70B の大規模サイズはより強力なハードウェアを必要とし、マルチ GPU 構成が求められることがよくあります。
**最適な用途 **: マルチモーダル性、幅広い言語サポート、制約のあるハードウェアでの効率的な展開が必要なアプリケーションには Gemma 3 27B を選択してください。エンタープライズグレードで最高水準のパフォーマンスが求められるテキスト中心のアプリケーションには Llama 3.3 70B を選択してください。
Google の Gemma 3 27B と Meta の Llama 3.3 70B は、トップクラスのオープンソース AI モデルです。このクイックガイドでは、それぞれの強みを比較し、プロジェクトに最適なモデルを素早く選択できるようにします。
基本紹介: Gemma 3 27B vs. Llama 3.3 70B
まずは、これら 2 つのモデルの違いを基本的な観点から見ていきましょう。
| 機能 | Gemma 3 27B | Llama 3.3 70B |
|---|---|---|
| 開発元 | Meta | |
| リリース日 | 2025年3月12日 | 2024年12月6日 |
| パラメータ数 | 270億 | 700億 |
| **モダリティ ** | ** マルチモーダル ** (画像・テキスト入力) | ** テキストのみ** |
| アーキテクチャ | インターリーブ型ローカル・グローバルアテンション | GQA を採用した最適化 Transformer |
| 学習データ | 14兆トークン | 15兆トークン以上 |
| コンテキストウィンドウ | 128,000 トークン | 128,000 トークン |
| 多言語対応 | 140以上の言語に対応 | 公式対応は8言語 |
| 拡張機能 | 構造化出力、Langchain を用いた関数呼び出し | 関数呼び出し |
Gemma 3 の際立った特徴は、マルチモーダル性によりテキストと一緒に視覚情報も解釈できる点です。一方、Llama 3.3 70B はテキスト専用ですが、パラメータ数が 2 倍以上あり、よりニュアンスのある強力なテキスト生成と推論能力を発揮することが多いです。
パフォーマンス: 2 つの専門性の物語
| ベンチマーク | Gemma 3 27B | Llama 3․3 70B |
|---|---|---|
| MMLU-Pro (推論・知識) | 67 | 71 |
| MATH-500 (定量的推論) | 88 | 77 |
| LiveCodeBench (コーディング) | 14 | 29 |
| HumanEval (コーディング) | 89 | 86 |
| GPQA Diamond (科学的推論) | 42.4 | 49 |
| MGSM | 74.3 | 91.1 |
| Vision QA (MMMU) | 64.9 | テキストのみ |
簡潔なポイント:
- 純粋な言語・コーディング: Llama 3 が大きくリード。
- 視覚タスク・OCR: 対応しているのは Gemma 3 のみ。
- 推論・知識: 両者とも競争力あり。Llama 3 は数学とコードでわずかにリード、Gemma 3 は多言語の幅広さで健闘。
Gemma 3 の VL モデルとしての能力を確認したい場合は、こちらの記事をご覧ください: Gemma 3 27B vs Qwen2.5-VL: AI写真Q&Aに最適なモデルは?
リソース効率: コストとハードウェア
ここが 2 つのモデルで最も大きな違いがあり、アクセシビリティと展開戦略に影響を与えます。
1. API 料金 (従量課金制)
| プロバイダー | Gemma 3 27B | Llama 3․3 70B |
|---|---|---|
| Novita AI | 入力 $0.119 / M トークン、出力 $0.20 / M トークン | 入力 $0.13 / M トークン、出力 $0.39 / M トークン |
| Deepinfra | 入力 $0.09 / M トークン、出力 $0.17 / M トークン | 入力 $0.23 / M トークン、出力 $0.40 / M トークン |
| Parasail | 入力 $1.20 / M トークン、出力 $1.20 / M トークン | 入力 $0.10 / M トークン、出力 $0.40 / M トークン |
API の効率を評価する際は、トークン単価だけでなく、モデルの出力速度と応答遅延も実際のアプリケーションでは同様に重要です。
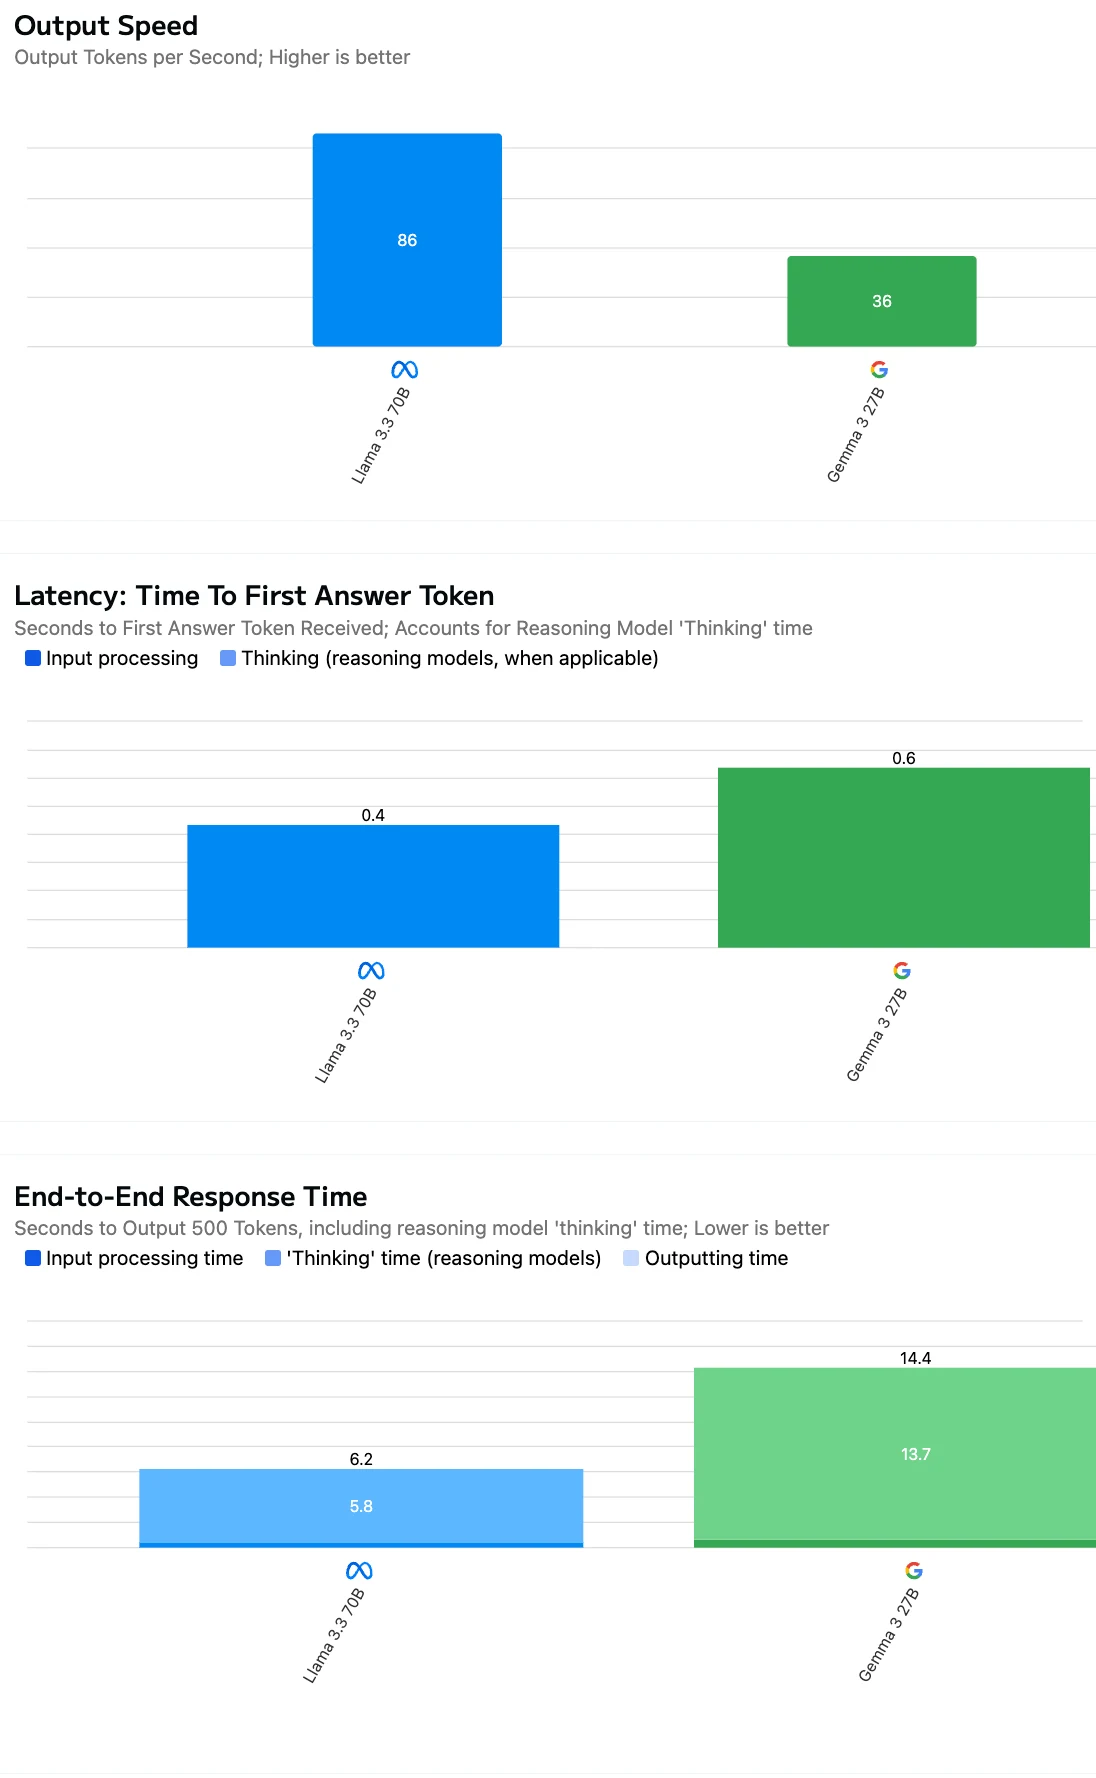
Artificial Analysis より引用
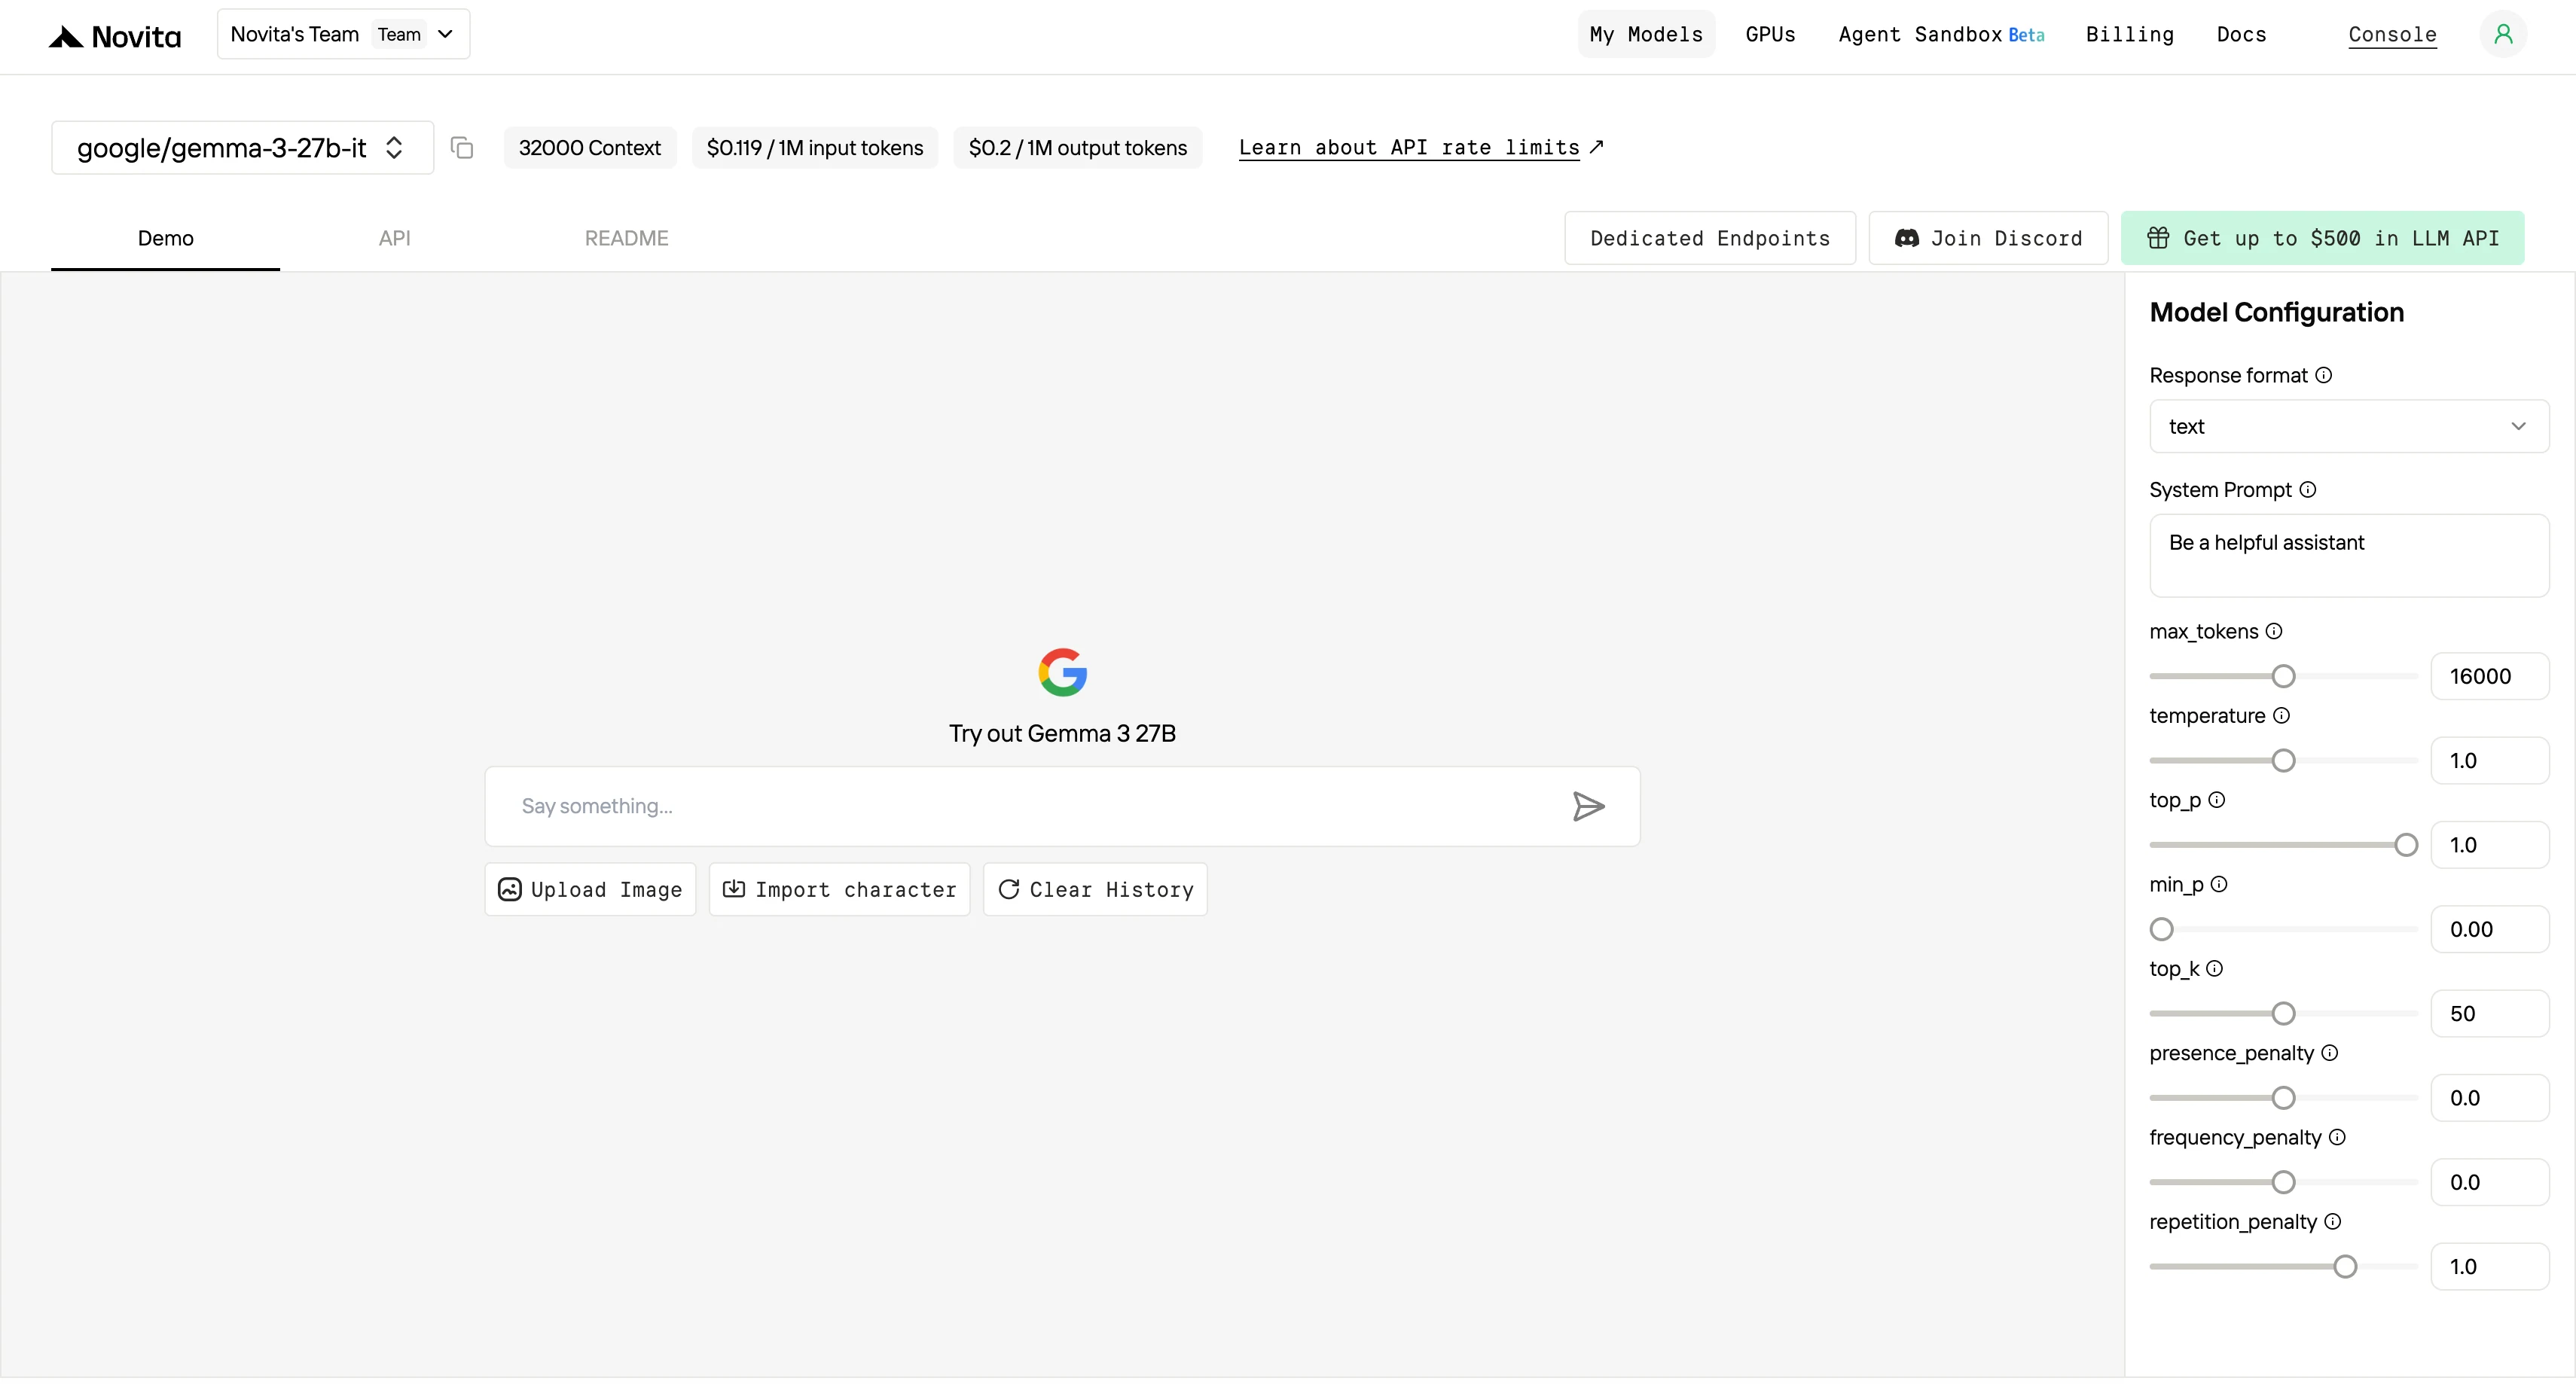
または、無料のプレイグラウンドを直接使用して、各タスクの速度をテストすることもできます。
2. ローカル推論ハードウェア
Llama 3.3 70B:
- VRAM: 4ビット量子化で 24GB (最小)、フル精度で 80GB 以上 (A100/H100)。
- 推奨: 2x NVIDIA A100/H100 (80GB)。
- RAM: 32–64GB 以上
- ストレージ: 250GB 以上
- ホームセットアップ: 難易度高、高い電力と冷却が必要。
Gemma 3 27B:
- VRAM: 1x H100 (80GB) または 3–4x RTX 4090 (24GB) に収まる。
- RAM: ~32–64GB
- ストレージ: 54GB (重み)、72.7GB (KVキャッシュ含む)
- ホームセットアップ: 比較的容易、高性能デスクトップでも実行可能。
概算の市場価格 (2025年第2四半期):
- RTX 4090 24 GB: ~$1,600
- NVIDIA H100 80 GB: ~$29,000
3. GPU クラウドスポット料金
| GPU タイプ | オンデマンド | 専用エンドポイント |
|---|---|---|
| A100 80 GB | $1.60/時間 | - |
| H100 80 GB | $2.56/時間 | $2.41/時間 |
| RTX4090 | $1.05/時間 (3枚) | $0.61/時間 |
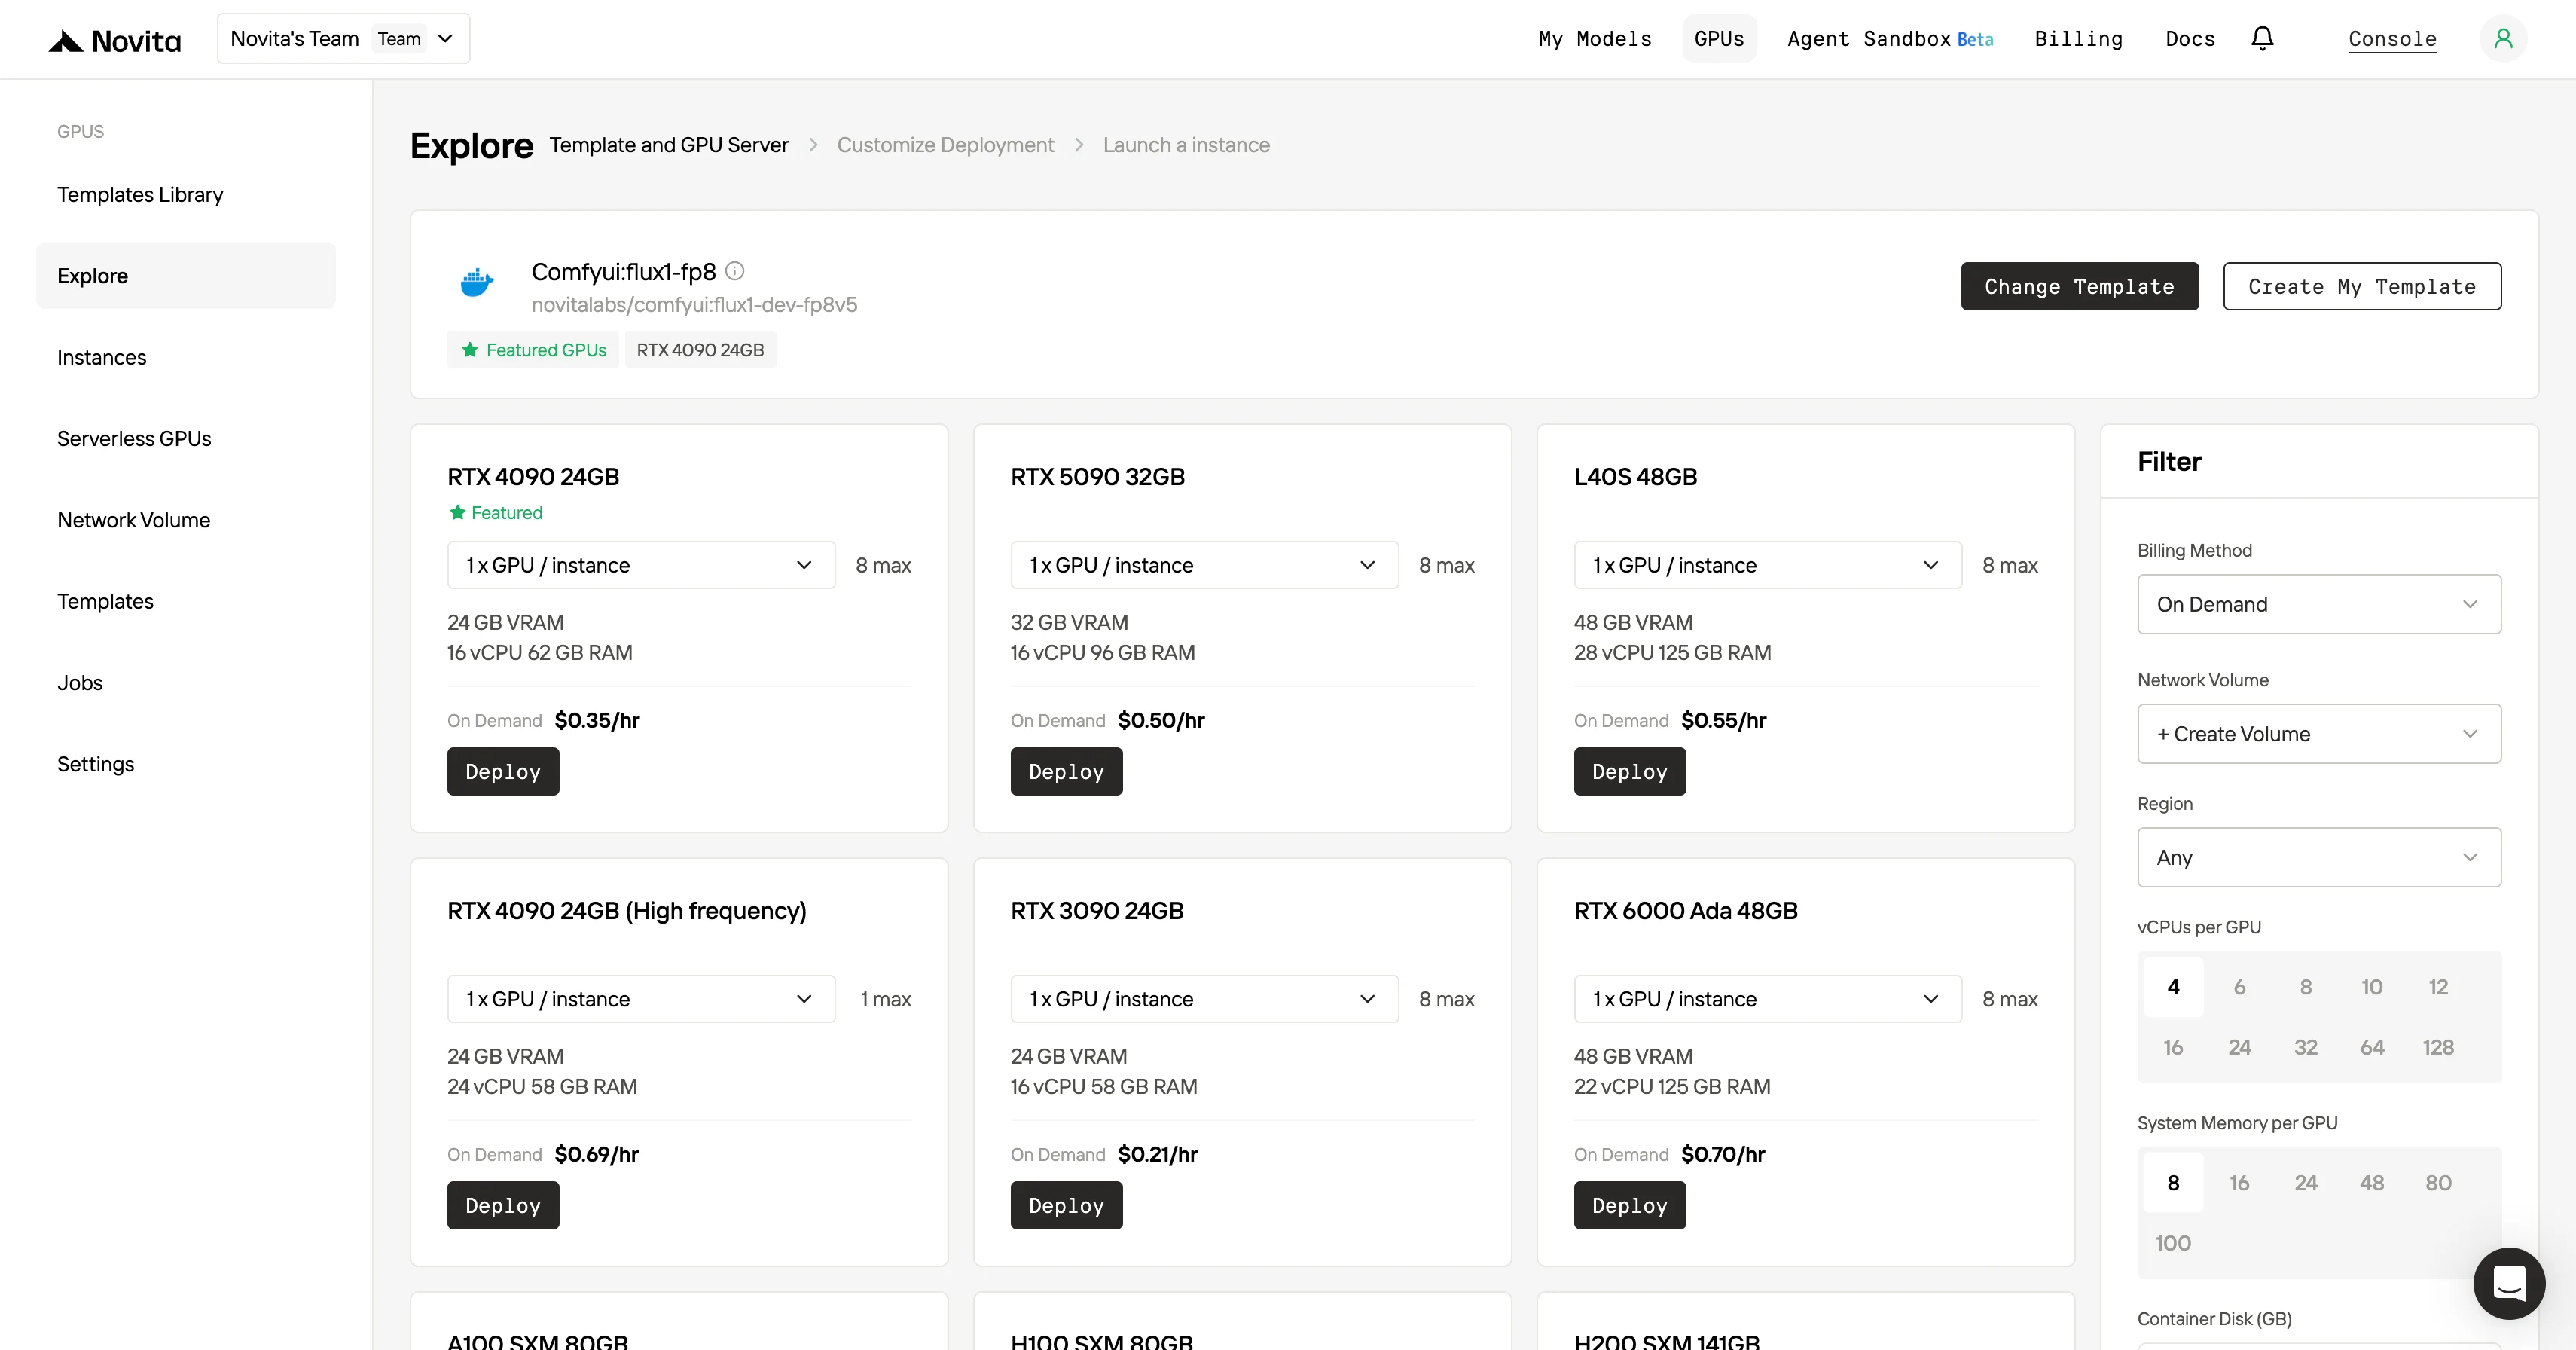
結論は明らかです。Gemma 3 27B は強力なモデルをローカルで実行するための障壁を下げ、Llama 3.3 70B は主にクラウド API アクセスや、オンプレミスハードウェアに大きな投資ができる組織向けです。
アプリケーション: タスクに適したツールの選択
これらのモデルの異なる特性は、さまざまなアプリケーションに適しています。
| **ユースケース ** | Gemma 3 27B | Llama 3.3 70B |
|---|---|---|
| チャットボット / AI アシスタント | 140以上の言語に対応し、グローバルな多言語会話 AI アプリケーションに最適 | 指示追従に優れ、要求の厳しい英語・多言語アシスタントに理想的 |
| コード生成 | 基本的なコードタスクから中程度のコードタスクで良好なパフォーマンス。プロトタイピングや学習プロジェクトに適している | HumanEval で 88% を達成。開発者ツール向けの複雑なコード生成やデバッグに強い |
| 長文ドラフト作成 | 最大 128k トークンを処理可能。長いドキュメント、レポート、研究資料の効率的な処理が可能 | 128k~130k トークンのコンテキストにも対応し、長時間のドラフト作成や要約タスクに適している |
| 画像サポート | SigLIP エンコーダによるネイティブなマルチモーダル入力 (テキスト + 画像) で、OCR、コンテンツモデレーション、ビジュアル Q&A を実現 | ネイティブなマルチモーダル機能はなく、テキスト入力のみに限定 |
| オンデバイス / エッジ展開 | 4B および 9B の軽量バージョンにより、個人や中小企業向けの効率的なローカル・エッジ展開が可能 | エッジ用に 8B バリアントあり。70B モデルはハイエンドハードウェアが必要 |
Novita API 経由で Gemma 3 27B と Llama 3.3 70B にアクセスする方法
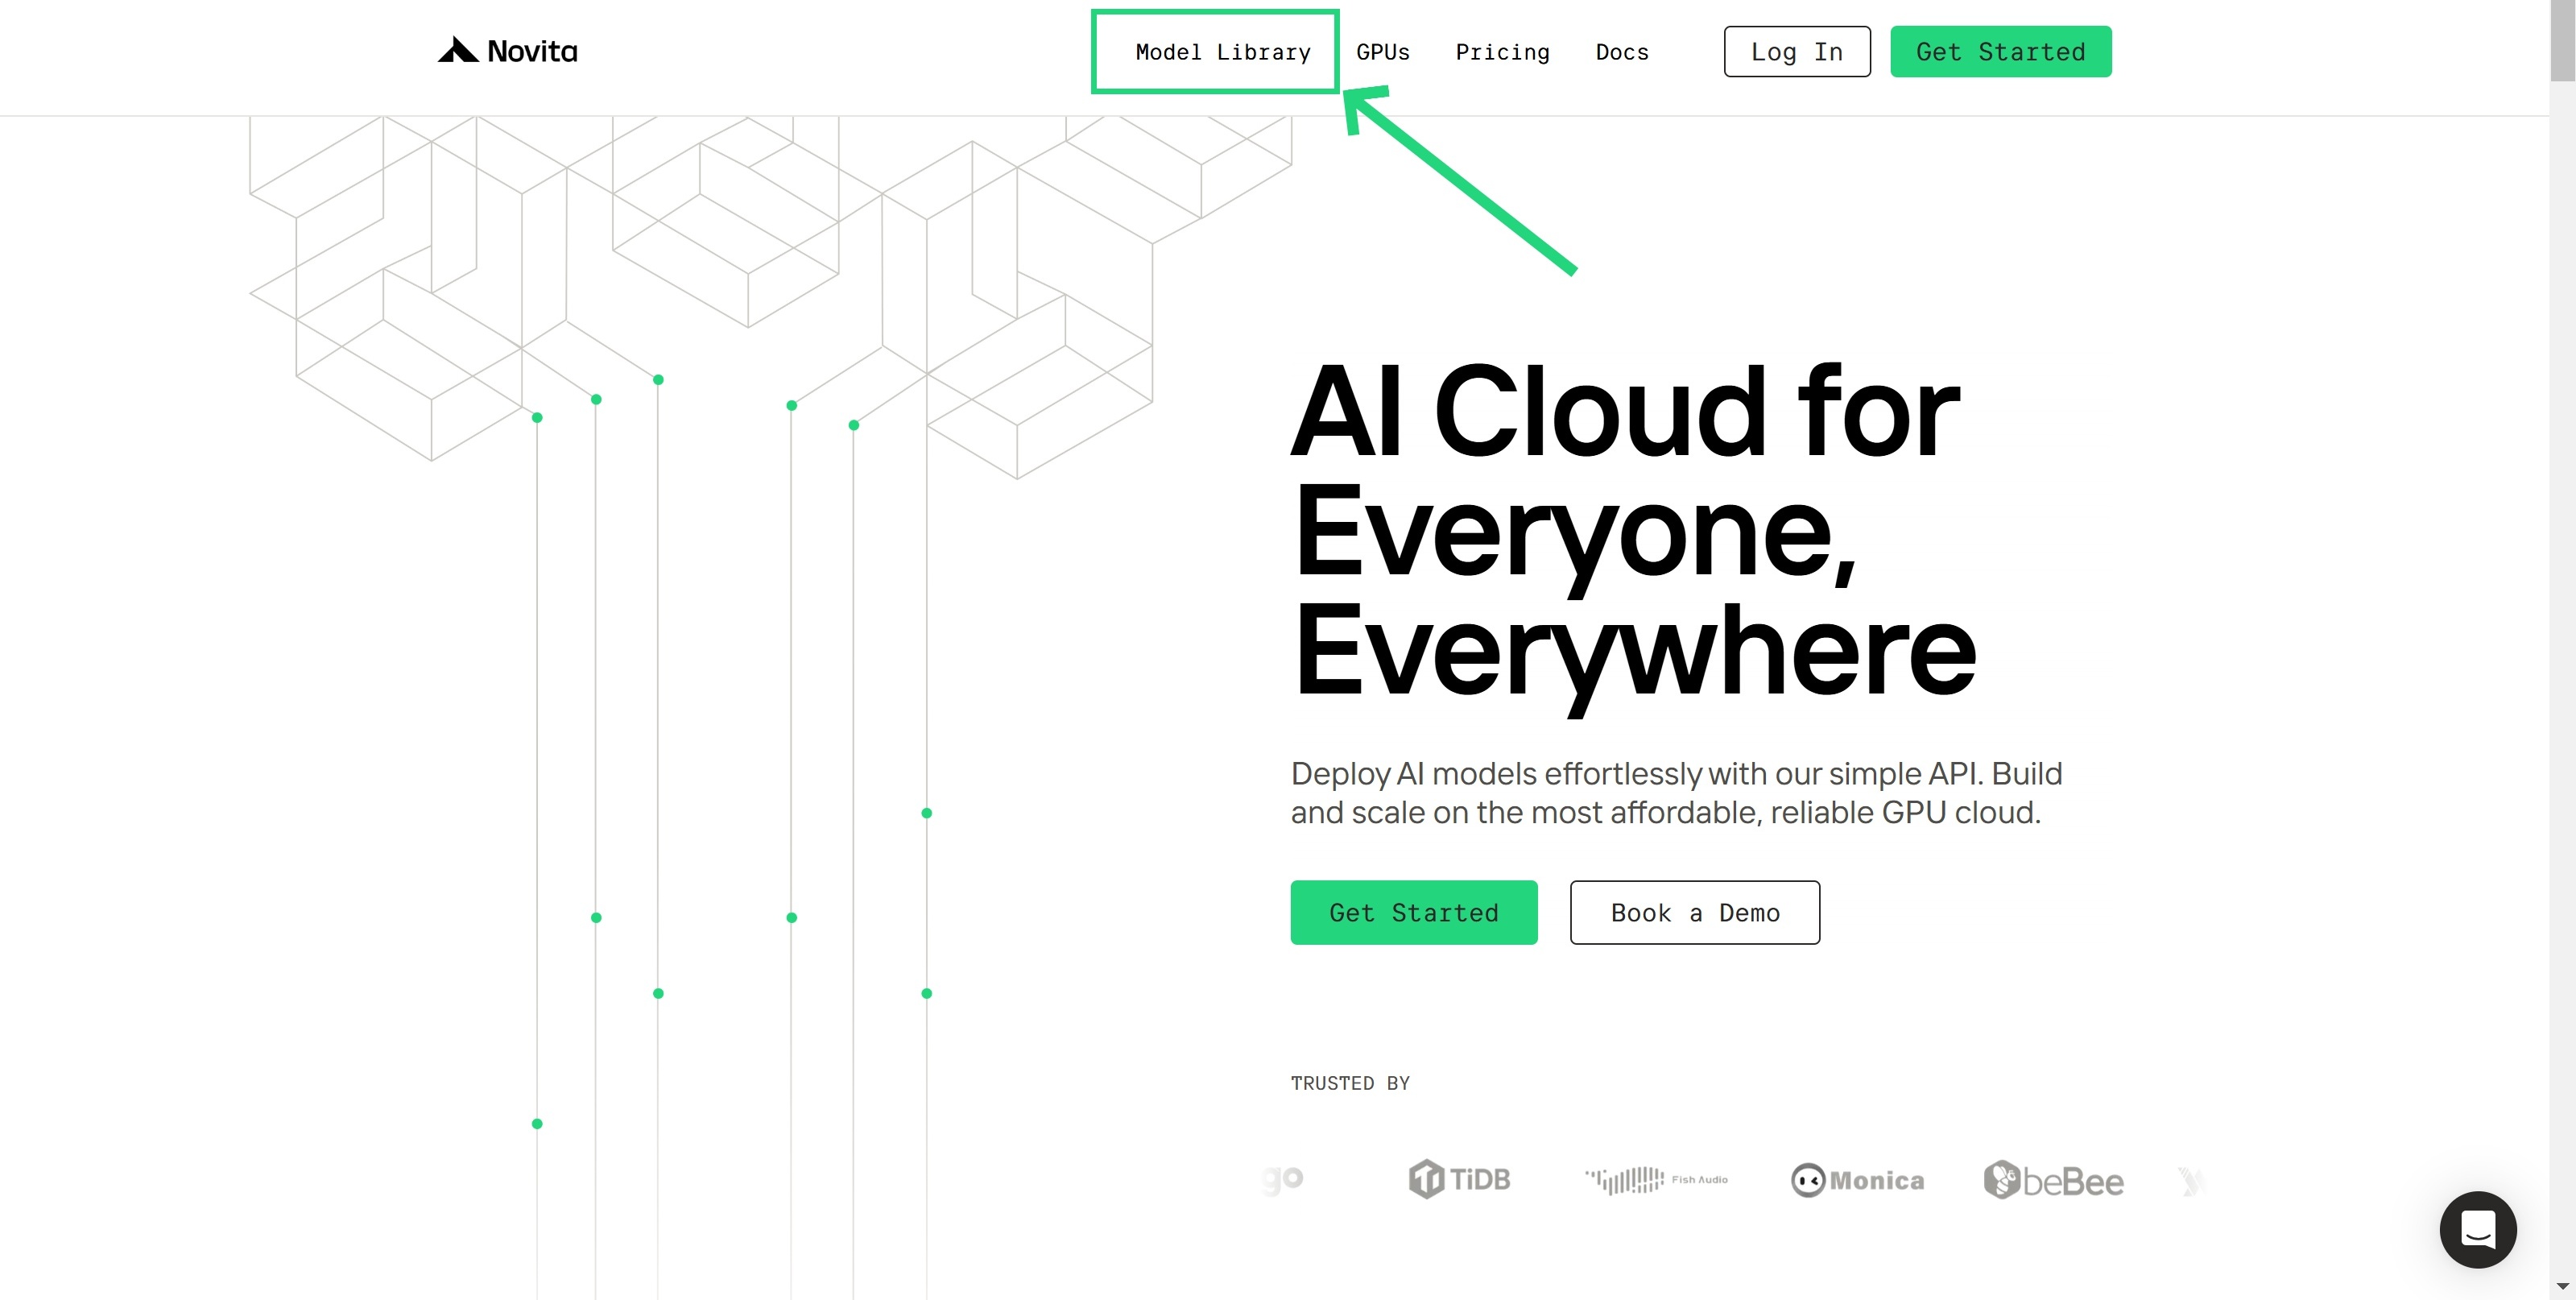
ステップ 1: ログインしてモデルライブラリにアクセス
アカウントにログインし、Model Library ボタンをクリックします。
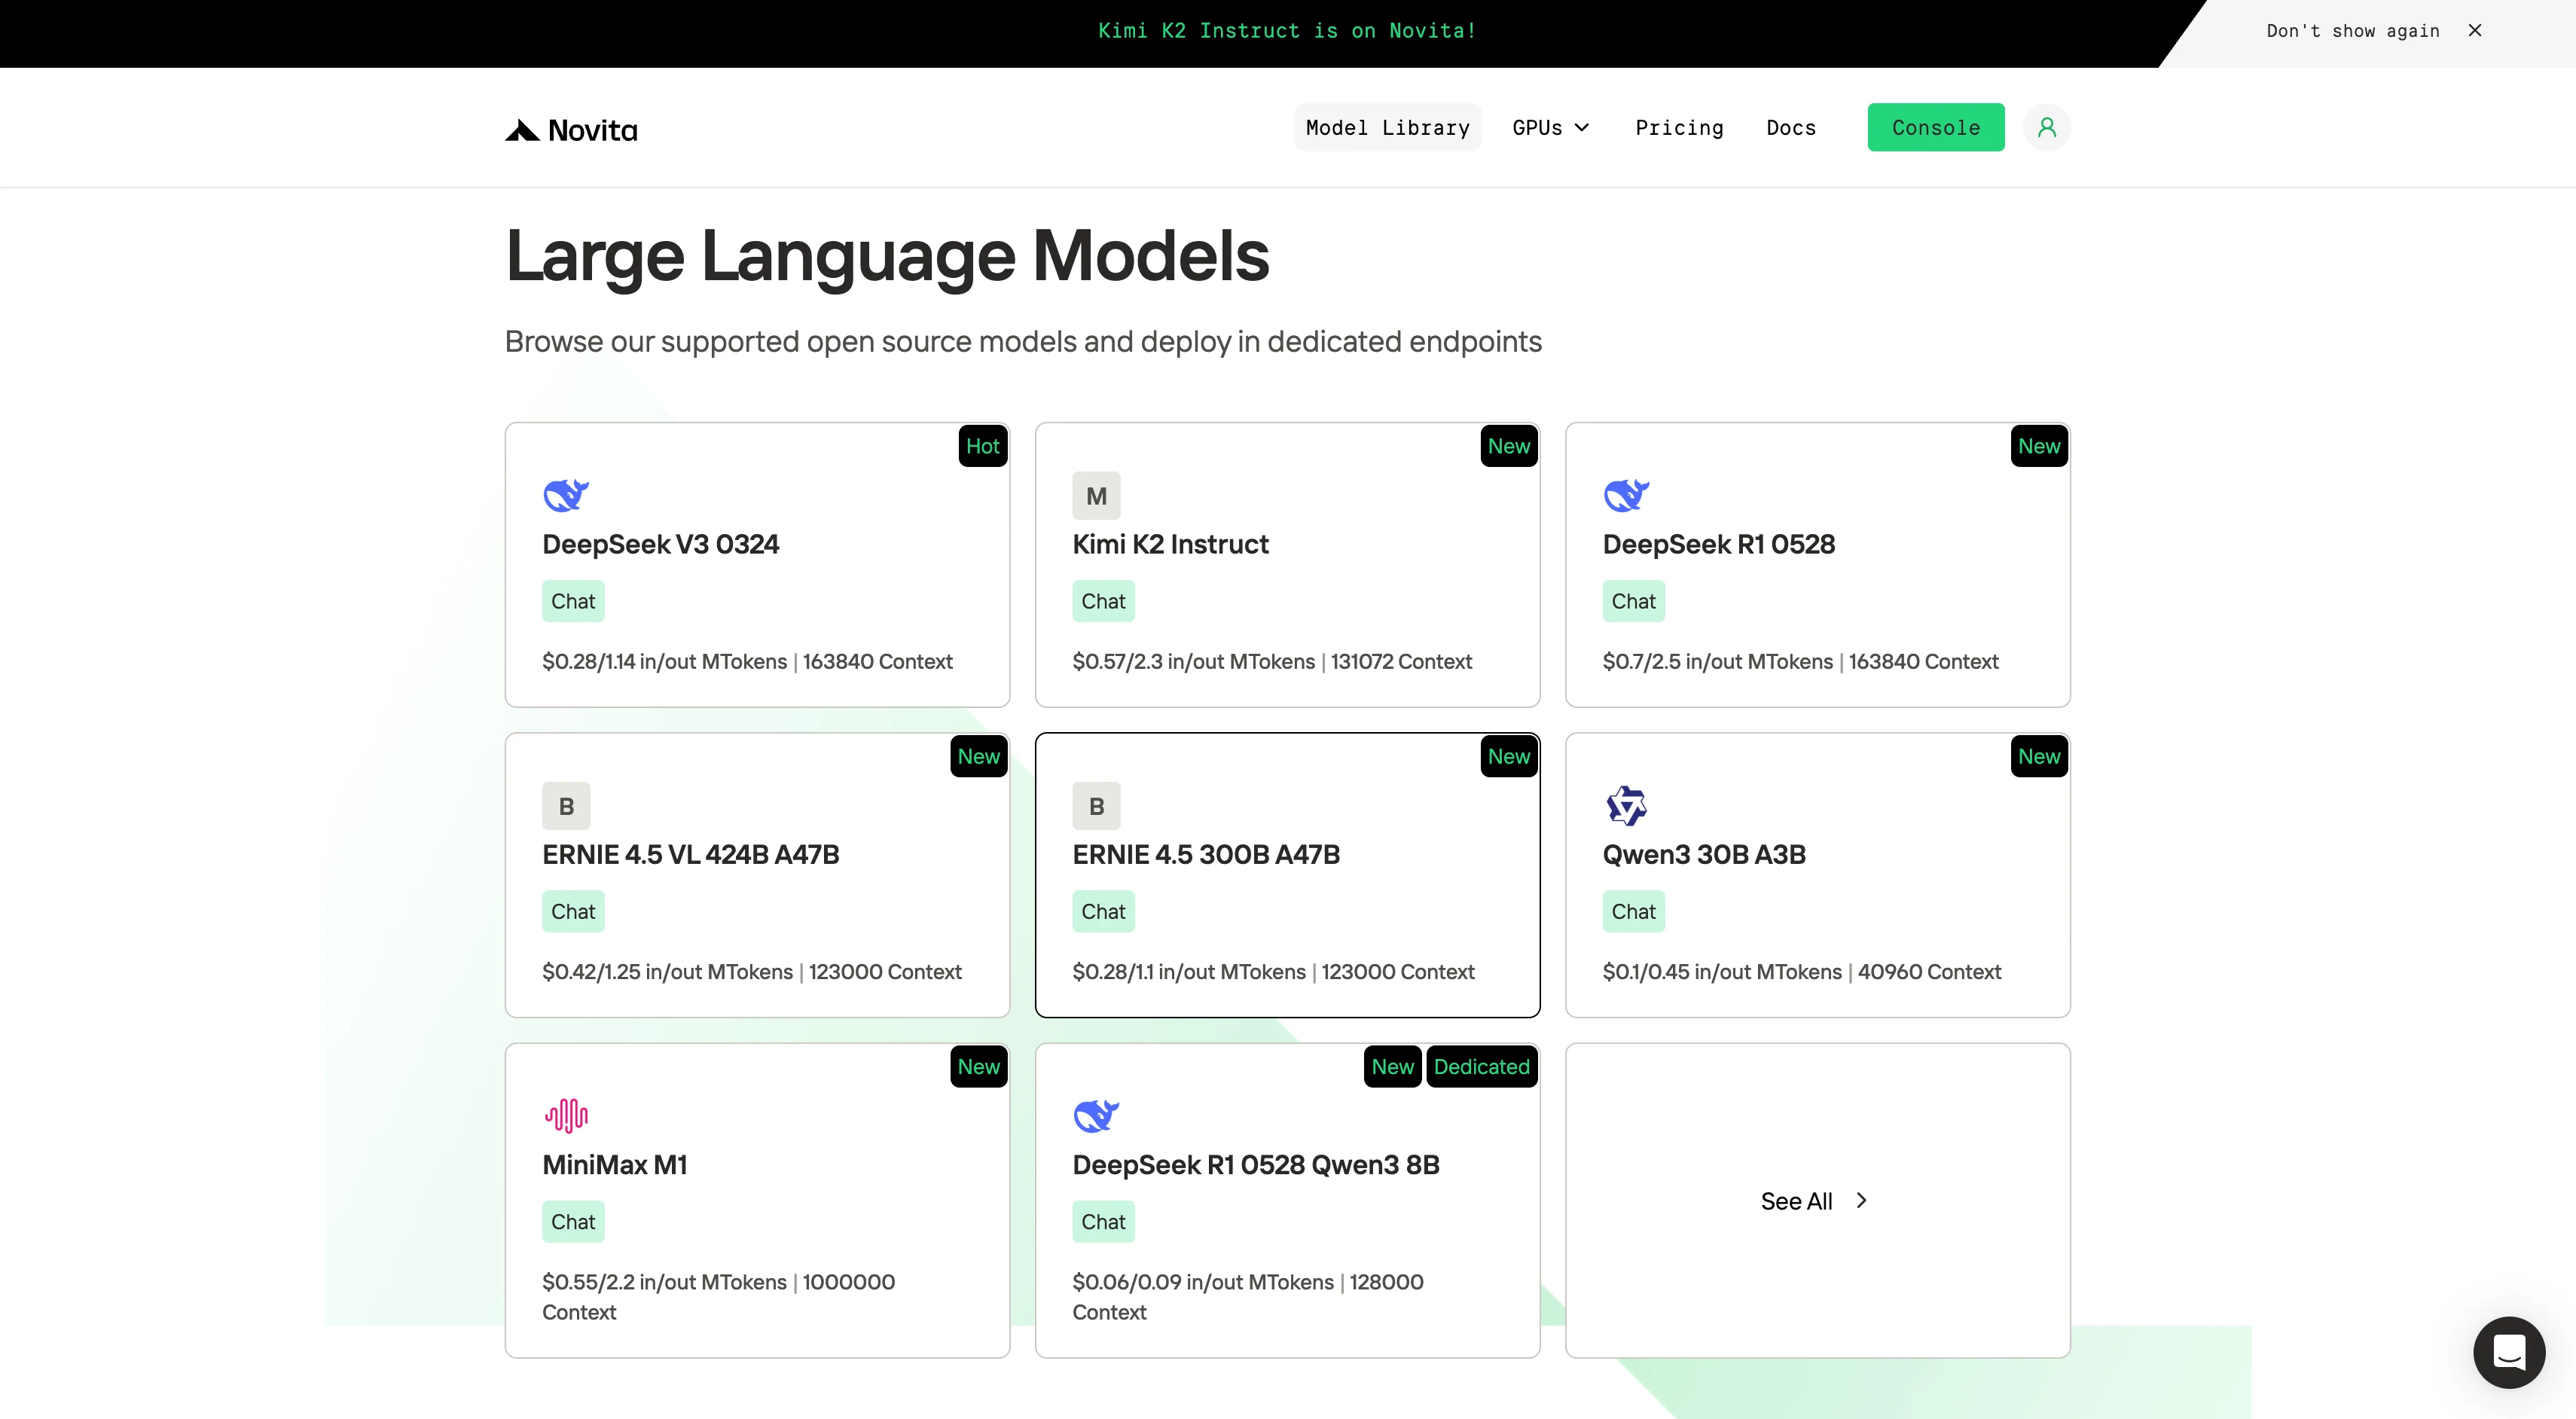
ステップ 2: モデルを選択
利用可能なオプションから、ニーズに合ったモデルを選択します。
ステップ 3: 無料トライアルを開始
選択したモデルの機能を試すために、無料トライアルを開始します。
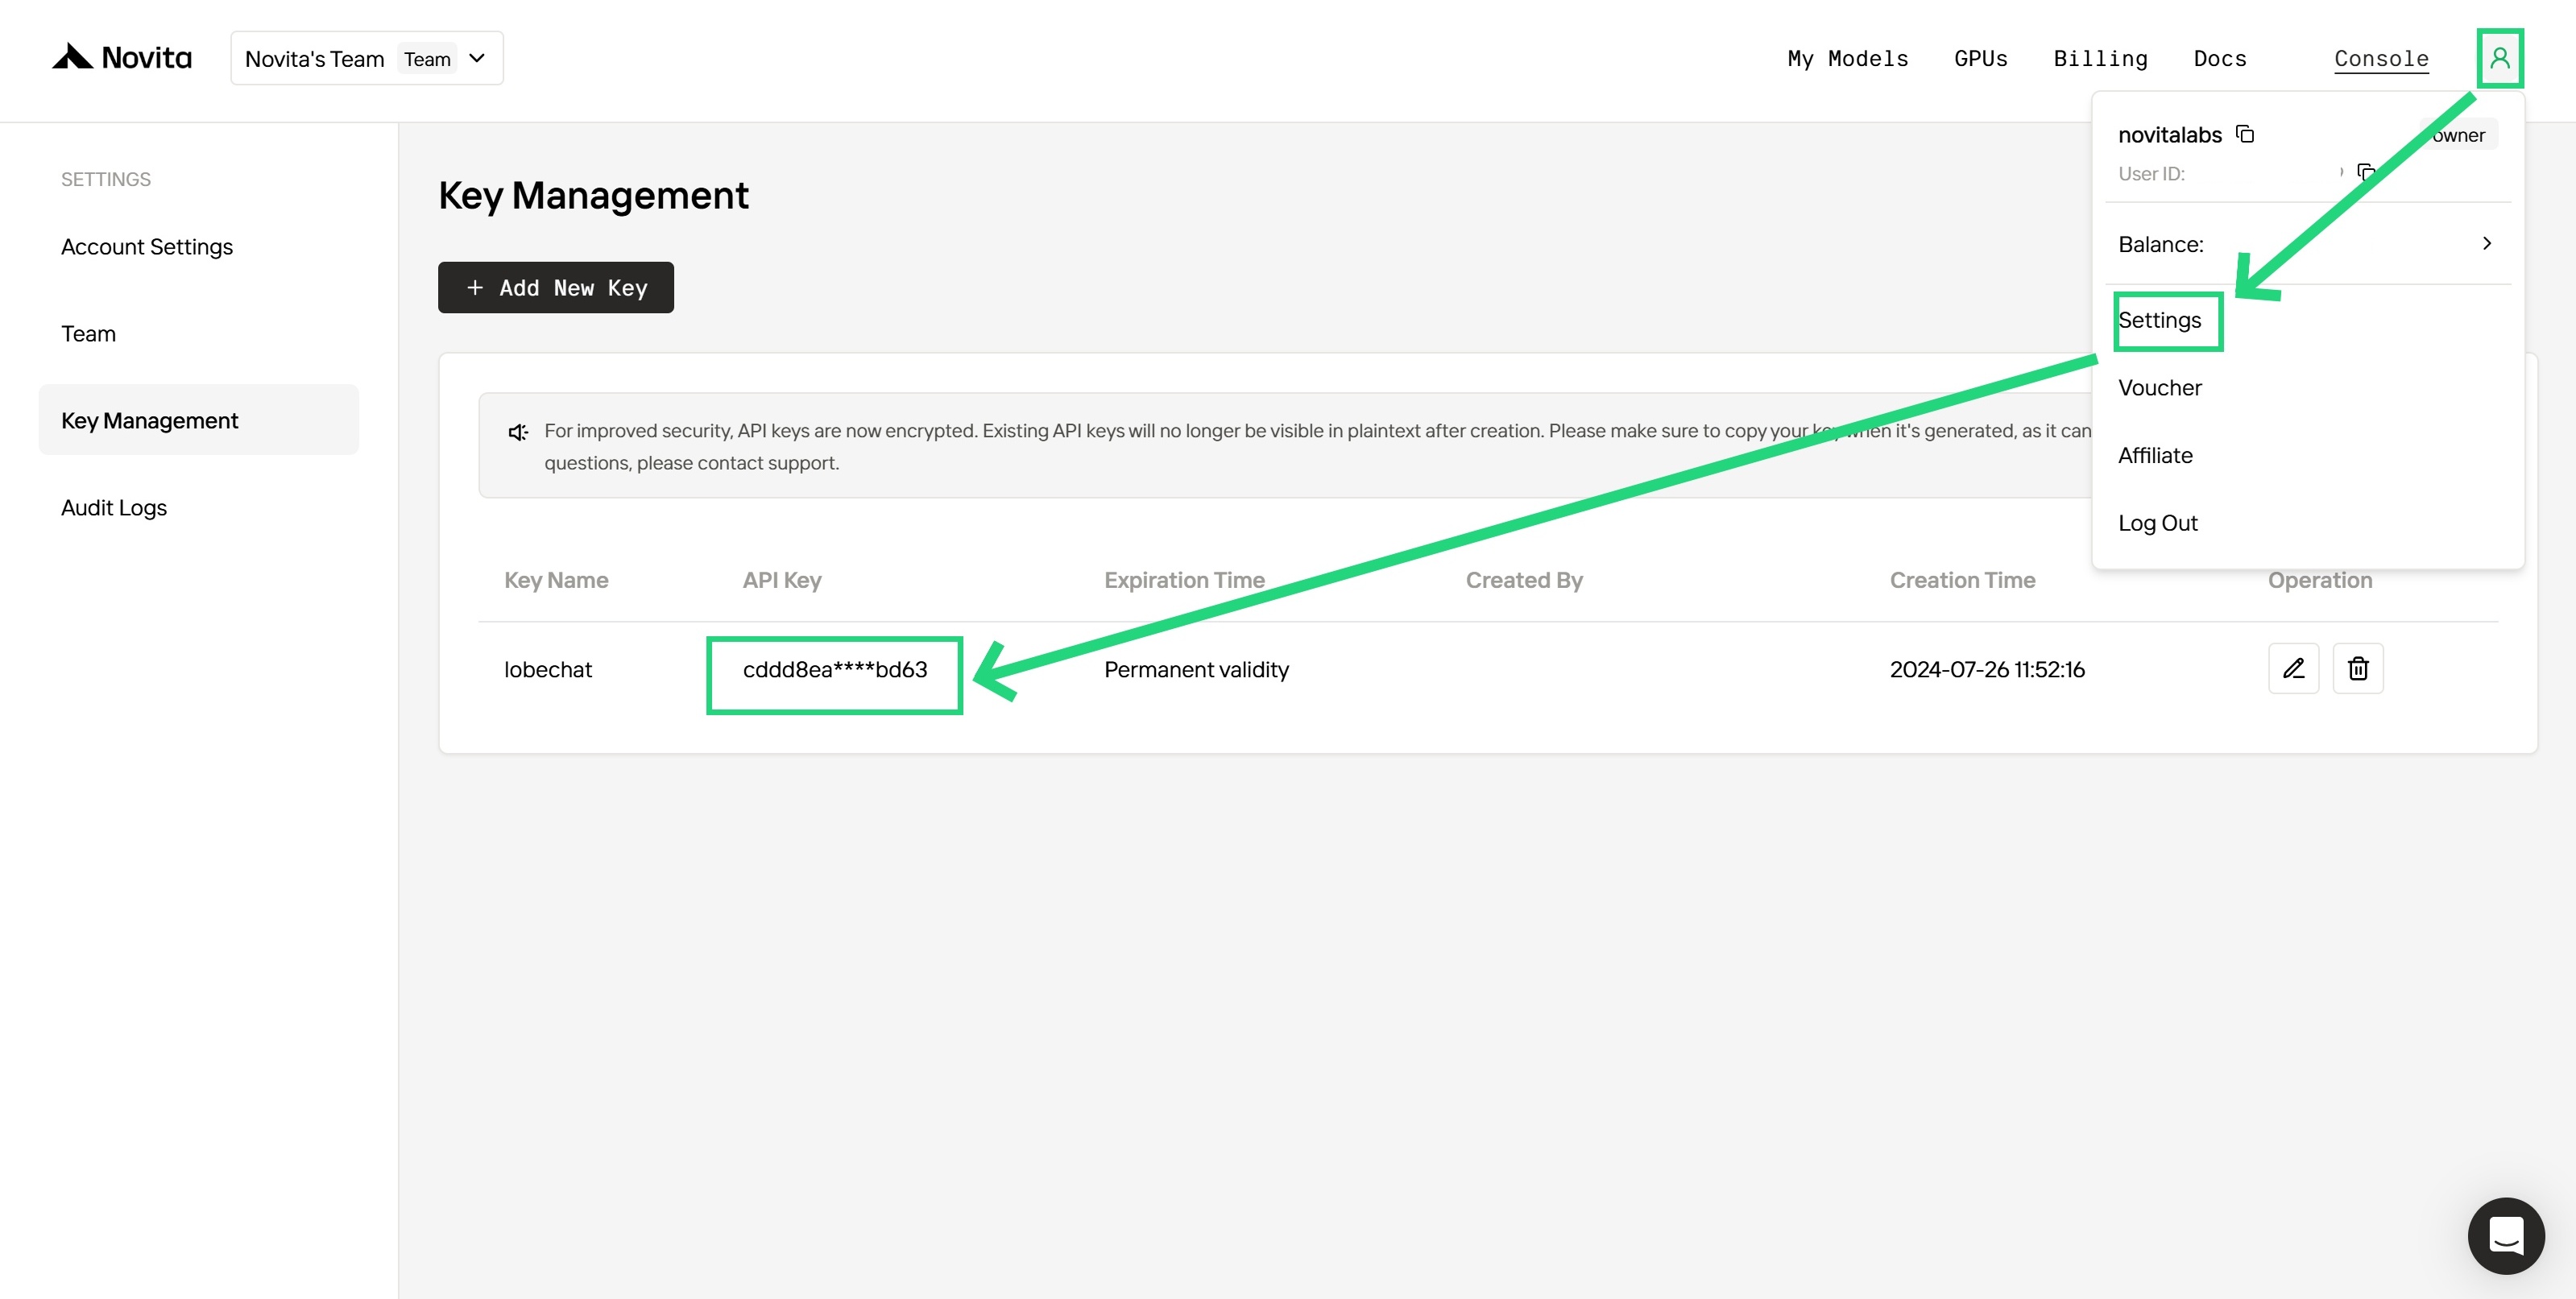
ステップ 4: API キーを取得
API で認証するために、新しい API キーが提供されます。「Settings」ページに入り、画像のように API キーをコピーします。
ステップ 5: API をインストール
お使いのプログラミング言語のパッケージマネージャーを使用して API をインストールします。
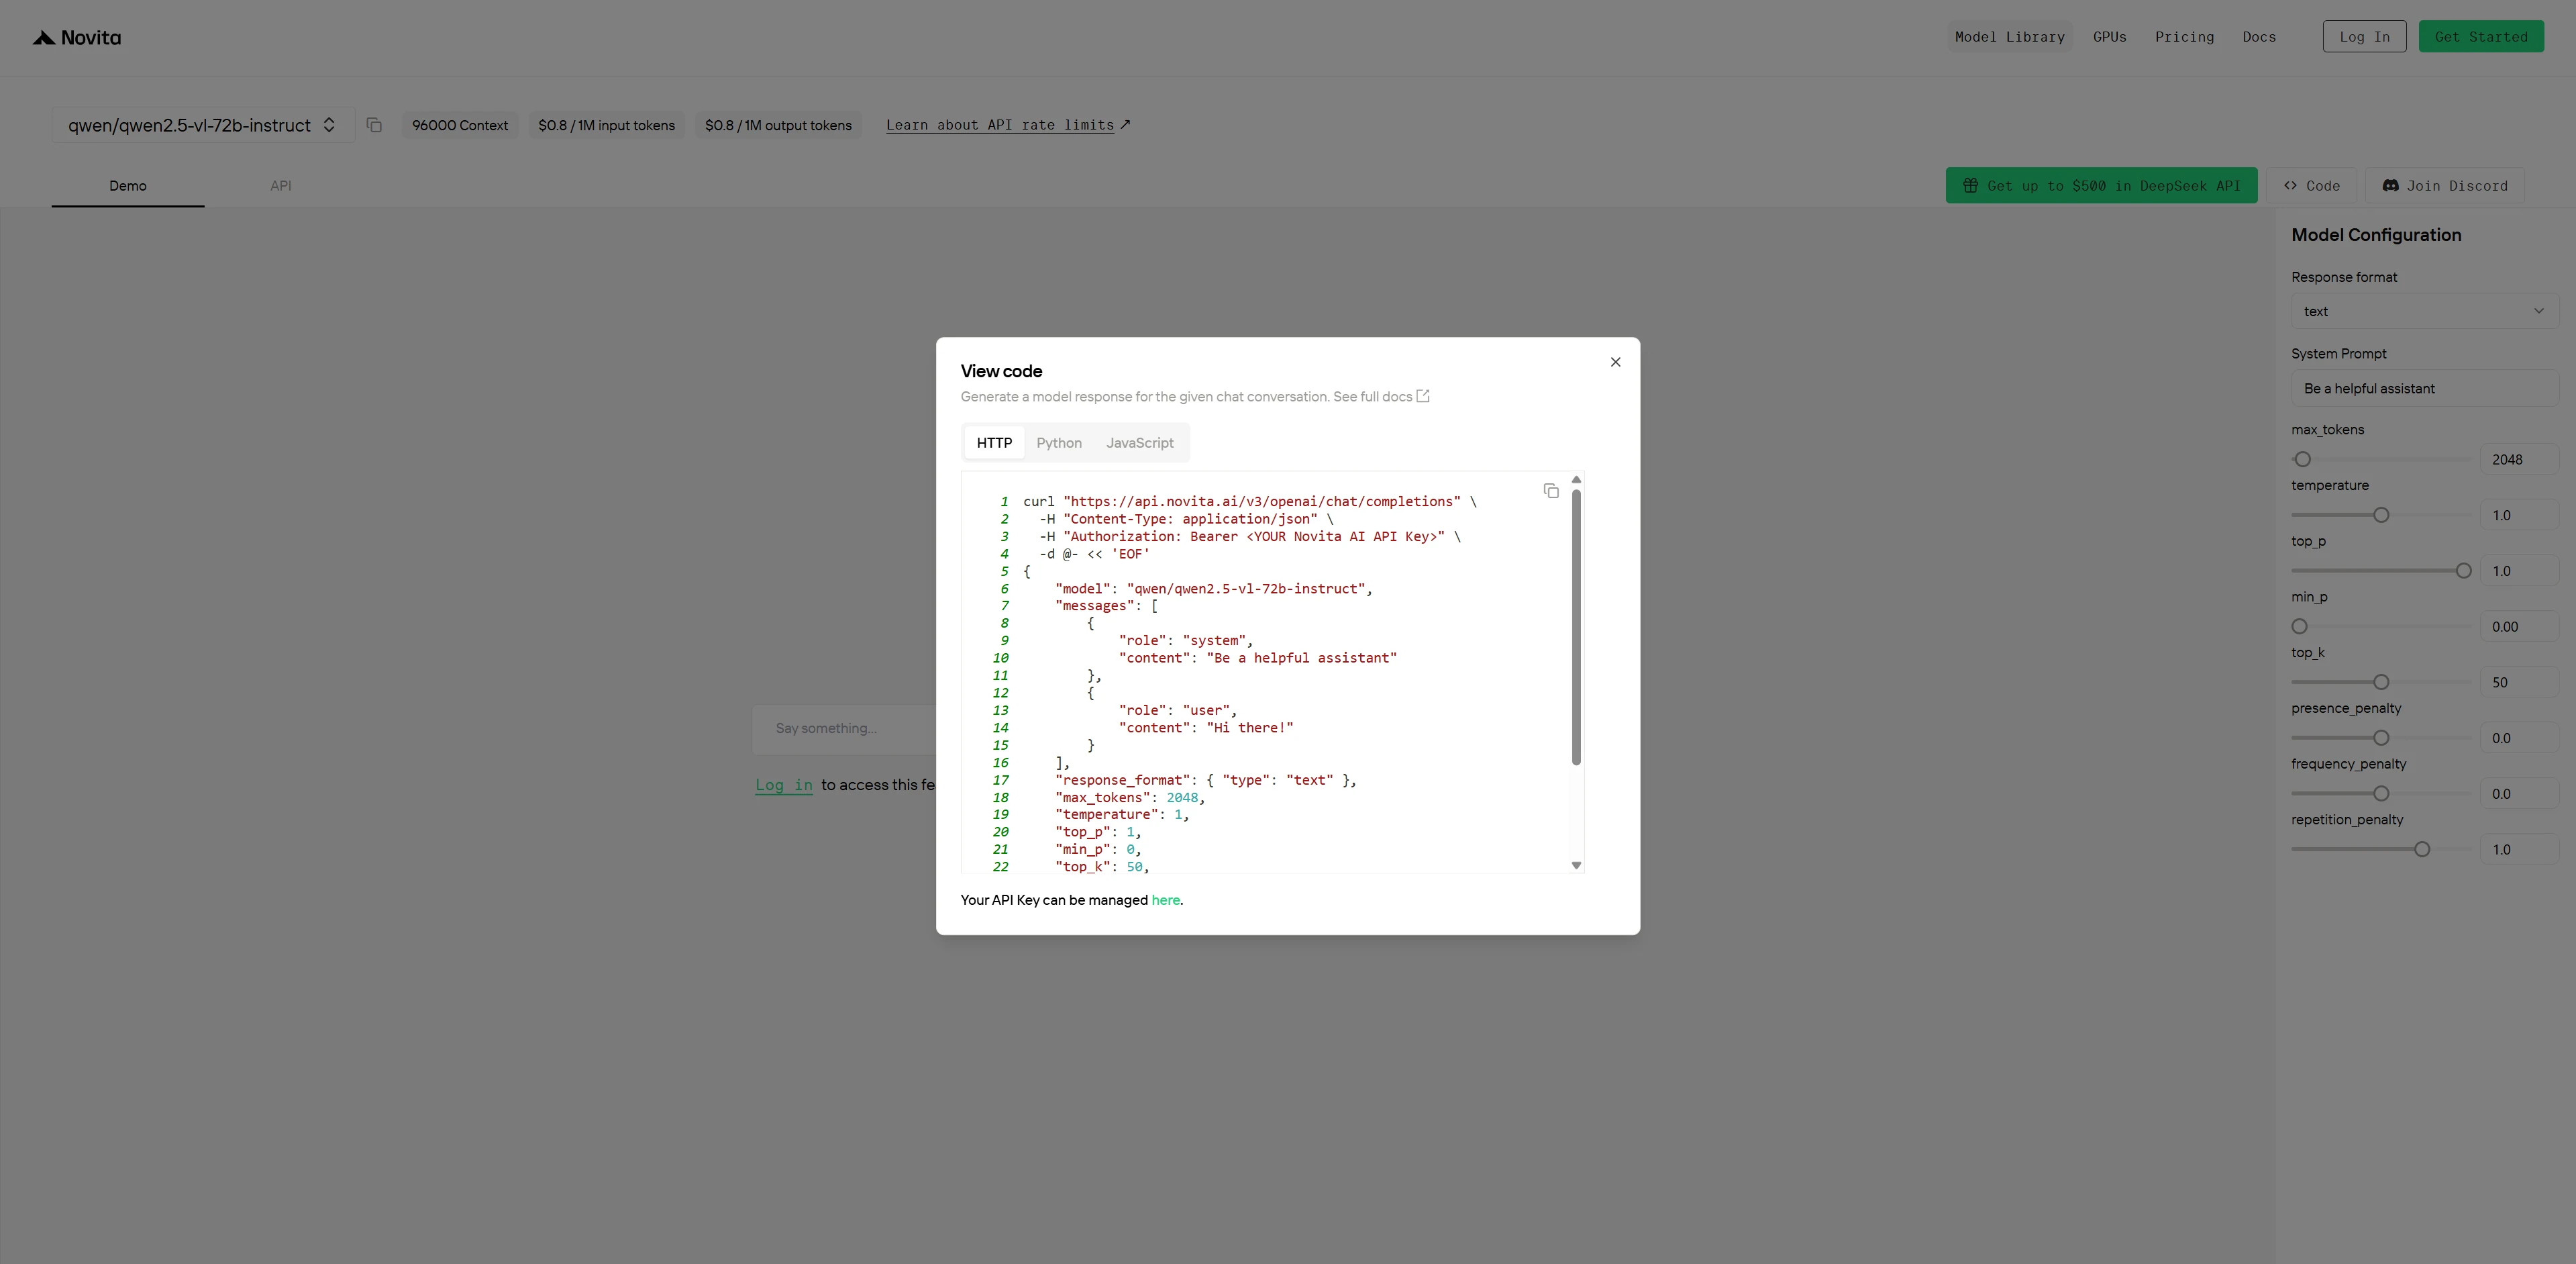
インストール後、開発環境に必要なライブラリをインポートします。API キーを使用して API を初期化し、Novita AI LLM とのやり取りを開始します。これは、Python ユーザー向けのチャット補完 API の使用例です。
from openai import OpenAI

client = OpenAI(
    base_url="https://api.novita.ai/v3/openai",
    api_key="session__FaCoze-7Vk7DBH0noVpc42JxmWIV4gCRV31Rz66AmBkUz5ZglF3sYVyGw3ZPlr08zck6KQHI51Scef6kEm8cQ==",
)

model = "google/gemma-3-27b-it"
stream = True # or False
max_tokens = 16000
system_content = ""Be a helpful assistant""
temperature = 1
top_p = 1
min_p = 0
top_k = 50
presence_penalty = 0
frequency_penalty = 0
repetition_penalty = 1
response_format = { "type": "text" }

chat_completion_res = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "system",
            "content": system_content,
        },
        {
            "role": "user",
            "content": "Hi there!",
        }
    ],
    stream=stream,
    max_tokens=max_tokens,
    temperature=temperature,
    top_p=top_p,
    presence_penalty=presence_penalty,
    frequency_penalty=frequency_penalty,
    response_format=response_format,
    extra_body={
      "top_k": top_k,
      "repetition_penalty": repetition_penalty,
      "min_p": min_p
    }
  )

if stream:
    for chunk in chat_completion_res:
        print(chunk.choices[0].delta.content or "", end="")
else:
    print(chat_completion_res.choices[0].message.content)
Gemma 3 27B と Llama 3.3 70B の選択は、どちらのモデルが「優れているか」ではなく、あなたにとってどちらが優れているか です。
Gemma 3 27B は、AI の多様性と効率性における飛躍を象徴しています。よりアクセスしやすいハードウェア環境に強力なマルチモーダル機能をもたらし、世界を見て理解できる新しいアプリケーションの波を促進します。革新的で柔軟性を必要とし、エンタープライズ規模の予算をかけずに最先端の AI を実行したい場合に最適なツールです。
Llama 3.3 70B は、スケールしたテキストベースのパフォーマンスにおいて比類のないチャンピオンです。推論、指示追従、コーディングタスクにおいて比類のないパワーを提供します。信じられないほど低い API コストと相まって、言語の優秀さが最優先される堅牢で高ボリュームのアプリケーションを構築する企業や開発者にとって決定的な選択です。
最終的に、あなたの決定は単純なトレードオフにかかっています。Gemma のマルチモーダルな汎用性とハードウェア効率が必要か、それとも Llama の生のテキスト処理能力と API のコスト効率が必要か、ということです。
よくある質問
Gemma 3 27B は Mac で実行できますか?
はい。小型の Gemma バリアント (例: 4B) は mlx-vlm を介して Apple Silicon をサポートしています。27B モデルには GPU アクセラレーション (例: クラウド API) が必要です。
リアルタイムチャットボットにはどちらのモデルが高速ですか?
Llama 3.3 70B は低レイテンシシナリオに優れています。Gemma のビジョン処理は若干のオーバーヘッドを追加します。
Llama 3.3 70B は本当に無料ですか?
はい。novita ai プレイグラウンド では無料です。ただし、ローカル展開には高価なハードウェアが必要であり、API はトークンベースのコストがかかります。
Novita AI は、シンプルな API を使用して AI モデルを簡単にデプロイできる環境を開発者に提供するとともに、手頃で信頼性の高い GPU クラウドを提供する AI クラウドプラットフォームです。
推奨記事
- [LLaMA 3.3 70B の VRAM 要件がホームサーバーにとって課題となる理由は?](http://Why LLaMA 3.3 70B VRAM Requirements Are a Challenge for Home Servers?)
- Qwen 2.5 72b vs Llama 3.3 70b: ニーズに合ったモデルはどちら?
- Llama 3.3 70B は本当に Llama 3.1 405B に匹敵するのか?