DeepSeek OCR API 를 찾고 계신가요? DeepSeek는 원조 DeepSeek-OCR과 후속 모델인 DeepSeek OCR2 두 세대를 출시했습니다. Novita AI는 현재 세대인 deepseek/deepseek-ocr-2 를 OpenAI 호환 엔드포인트로 호스팅하며, 이 가이드에서는 코드를 작성하기 전에 호출 방법, 비용, 두 세대를 구분하는 방법을 다룹니다.
OCR은 더 이상 단순한 "텍스트 추출"이 아닙니다. 현대 팀에게 필요한 것은 **문서 인텔리전스 **, 즉 읽기 순서, 레이아웃, 표, 구조화된 출력을 대규모로 처리하는 능력입니다. 그리고 엔터프라이즈 OCR의 비싼 가격표는 피해야 합니다. DeepSeek OCR2 는 새로운 시각적 인코딩 패러다임으로 이러한 흐름을 더욱 밀어붙였으며, Novita AI 는 API와 투명한 토큰 가격 책정을 통해 이를 실제 프로덕션 환경에 적용할 수 있게 해줍니다.
Gen 1 vs Gen 2: 이미
model="deepseek/deepseek-ocr"(Gen 1)을 호출하는 코드가 있다면, 새 작업을 배포하기 전에 Novita AI의 DeepSeek-OCR 문서를 확인하세요. Novita의 실시간 모델 카탈로그에는 해당 모델 ID가 다른 단종 세대 모델과 함께 레거시 상태로 표시되므로, 새 통합은 아래의deepseek/deepseek-ocr-2를 대상으로 해야 합니다.
DeepSeek OCR2란 무엇인가
기본 소개
DeepSeek-OCR 2 는 DeepSeek AI의 멀티모달 문서 인식 모델로, DeepSeek-OCR(Gen 1)의 업그레이드 버전입니다. 핵심 변화는 DeepEncoder V2 로, 시각적 처리를 경직된 “래스터 스캔”(왼쪽 위 → 오른쪽 아래) 방식에서 의미론적, 인과 기반 읽기 방식으로 전환합니다. 이는 인간이 복잡한 문서의 논리적 구조를 따라가는 방식에 더 가깝습니다.
기존 OCR 파이프라인은 다단 PDF, 복잡한 금융 보고서, 표+각주가 혼합된 문서, 읽기 순서가 까다로운 양식에서 자주 실패합니다. OCR2는 단순히 "문자를 인식"하는 것이 아니라 페이지를 이해 하도록 설계되었습니다.
| 특징 | DeepSeek OCR2 |
| 개발 기관 | DeepSeek AI |
| 모델 유형 | 멀티모달 문서 인식(OCR + 레이아웃 인지 이해) |
| 핵심 혁신 | DeepEncoder V2가 이미지 의미론에 따라 시각적 토큰을 재정렬(“고정 스캔” → “의미론적 추론”) |
| 컨텍스트 윈도우 / 최대 출력 | 8,192 / 8,192 |
| 입력 / 출력 | 입력: 텍스트, 이미지 / 출력: 텍스트 |
| 양자화 | bf16 |
| 라이선스 | Apache-2.0 |
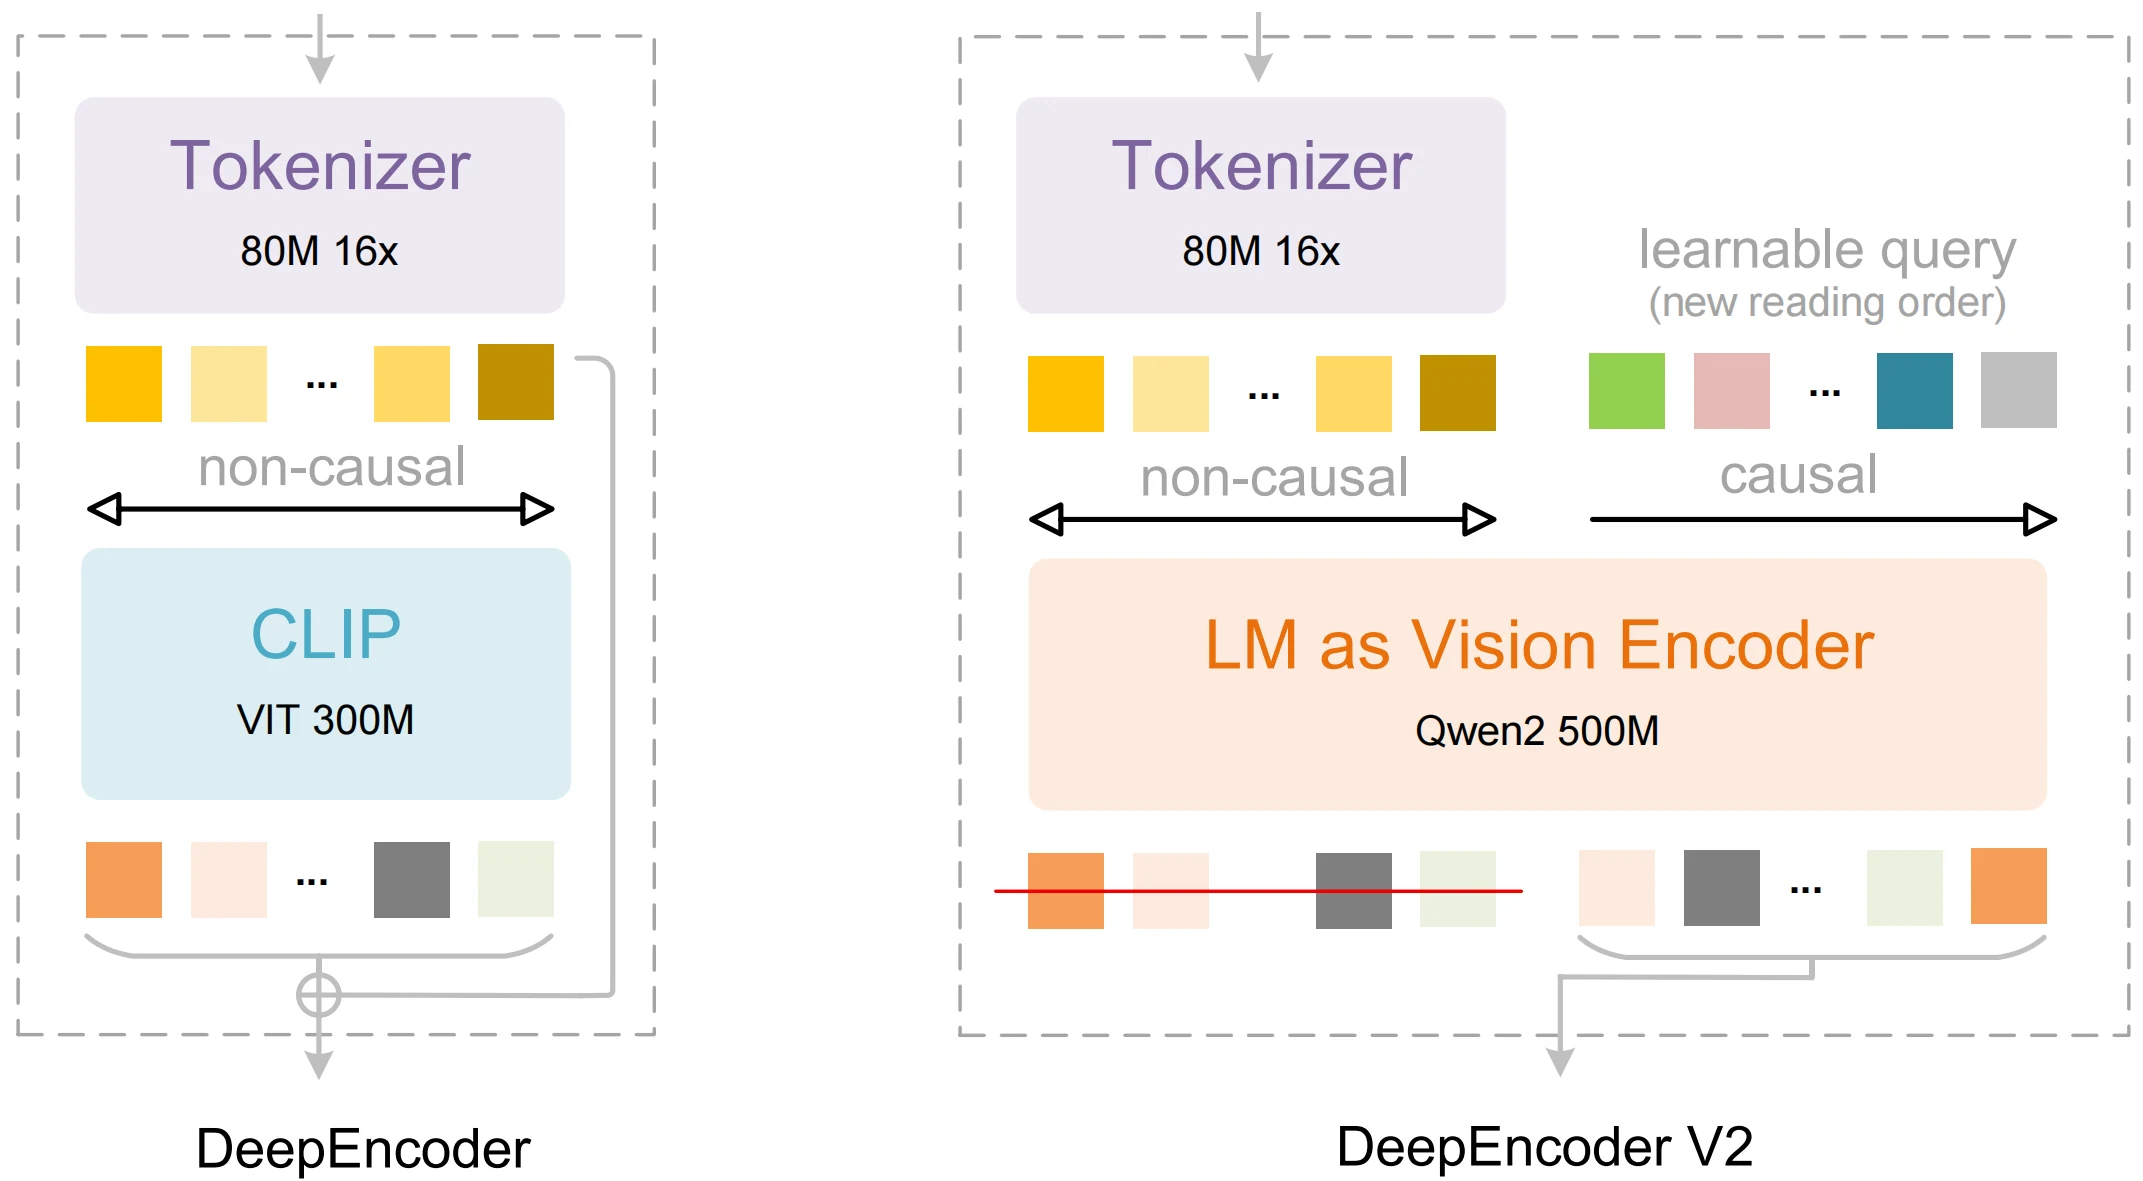
DeepSeek-OCR 2: Visual Causal Flow
🔍높은 수준에서 보면:
- **인코더 측면 : DeepEncoder V2는 LLM 스타일 디코딩 단계 전에 ** 이미지 의미론에 따라 시각적 토큰을 재정렬할 수 있습니다.
- **시스템 설계 **: OCR2는 **DeepSeek-3B-MoE 디코더 ** 를 유지하면서, 기존 CLIP 기반 인코더를 경량 LLM 컴포넌트(Qwen2-0.5B)로 교체한 것으로 설명됩니다.
- **토큰 효율성 **: OCR2는 제한된 시각적 토큰 예산을 사용하여 문서를 처리합니다(복잡도에 따라 256–1120 범위로 보고됨).
벤치마크 성능
OCR2의 개선은 문서 중심 벤치마크에서 가장 두드러집니다:
- OmniDocBench v1.5 에서 DeepSeek-OCR 2 는 전체 91.09% 를 달성하여 이전 모델 대비 +3.73% 향상되었고, ** 읽기 순서 편집 거리 **를 0.085 → 0.057 로 줄였습니다.
- OmniDocBench 는 다양한 문서 유형, 레이아웃, 언어에 걸친 실제 PDF 파싱 을 평가하도록 설계되었습니다.
송장 처리, 보험 청구 처리, 규정 준수 PDF, 매뉴얼 기반 RAG 등 문서 워크플로우를 구축하고 있다면 이러한 지표는 일반적인 "OCR 정확도"보다 더 중요합니다. 문자 수준 인식이 아닌 구조 + 레이아웃 이해 를 측정하기 때문입니다.
AI API 공급자를 평가하는 방법: 5가지 핵심 지표
모델 선택은 결정의 절반에 불과합니다. 공급자 가 안정적인 확장 가능 여부를 결정합니다.
| 지표 | 핵심 초점 | 비즈니스 영향 | Novita AI / DeepSeek-OCR2 맥락 |
| 컨텍스트 길이 | 토큰 제한 | 청크 감소 → 호출 감소 → 파이프라인 단순화 | 8,192-토큰 컨텍스트로 다중 페이지 파싱을 한 번에 처리 가능 |
| 토큰 비용 | API 가격 | 대규모 추출 ROI에 직접 영향 | 대용량 OCR 워크로드를 위한 최적화된 가격(아래 세부 정보) |
| 지연 시간(TTFT/TPOT) | 응답 속도 | 사용자 대면 OCR 경험 개선 | 빠른 미리보기와 반응형 앱을 위한 낮은 지연 시간 |
| 처리량 | RPS / 동시성 | 배치 처리 및 피크 트래픽 처리 가능 | 배치 + 동시 작업을 위한 높은 동시성 용량 |
| 통합 | 호환성 | 기존 도구 재사용으로 더 빠른 출시 | OpenAI 호환 도구와 작동, Anthropic 스타일 통합도 지원 |
왜 Novita AI를 선택해야 할까?
**참고 **: OpenAI 호환 API 외에도 Novita AI는 Anthropic 호환 인터페이스 도 제공하므로, 기존 Claude 스타일 도구와 프롬프트를 최소한의 변경만으로 재사용할 수 있습니다.
개발 효율성
통합이 빠를수록 가치 실현도 빨라집니다. Novita는 OpenAI 호환 인터페이스를 제공하므로 대부분의 팀은 다음 항목만 변경하여 OCR2를 통합할 수 있습니다:
- base_url:
https://api.novita.ai/openai - api_key:
<Your API Key> - model name:
deepseek/deepseek-ocr-2
비용 우위
Novita는 OCR2에 대해 매우 간단한 가격을 제시합니다: 입력과 출력 토큰 모두 동일한 저렴한 요율로, OCR 중심 워크로드의 비용 예측을 단순화합니다.
또한 Novita는 서버리스 엔드포인트를 운영하므로 일반적으로 다음과 같은 운영 부담을 피할 수 있습니다:
- GPU 프로비저닝
- 추론 서버 자동 확장
- CUDA + 추론 스택 유지 관리
DeepSeek OCR2 API 가격
Novita 모델 카탈로그에서 deepseek/deepseek-ocr-2 는 다음과 같이 표시됩니다(2026-08-24 확인, 가격은 지속적으로 업데이트됨):
- 입력: $0.03 / 1M 토큰
- 출력: $0.03 / 1M 토큰
- 컨텍스트 윈도우: 8,192 토큰
DeepSeek OCR2 API 접근 방법
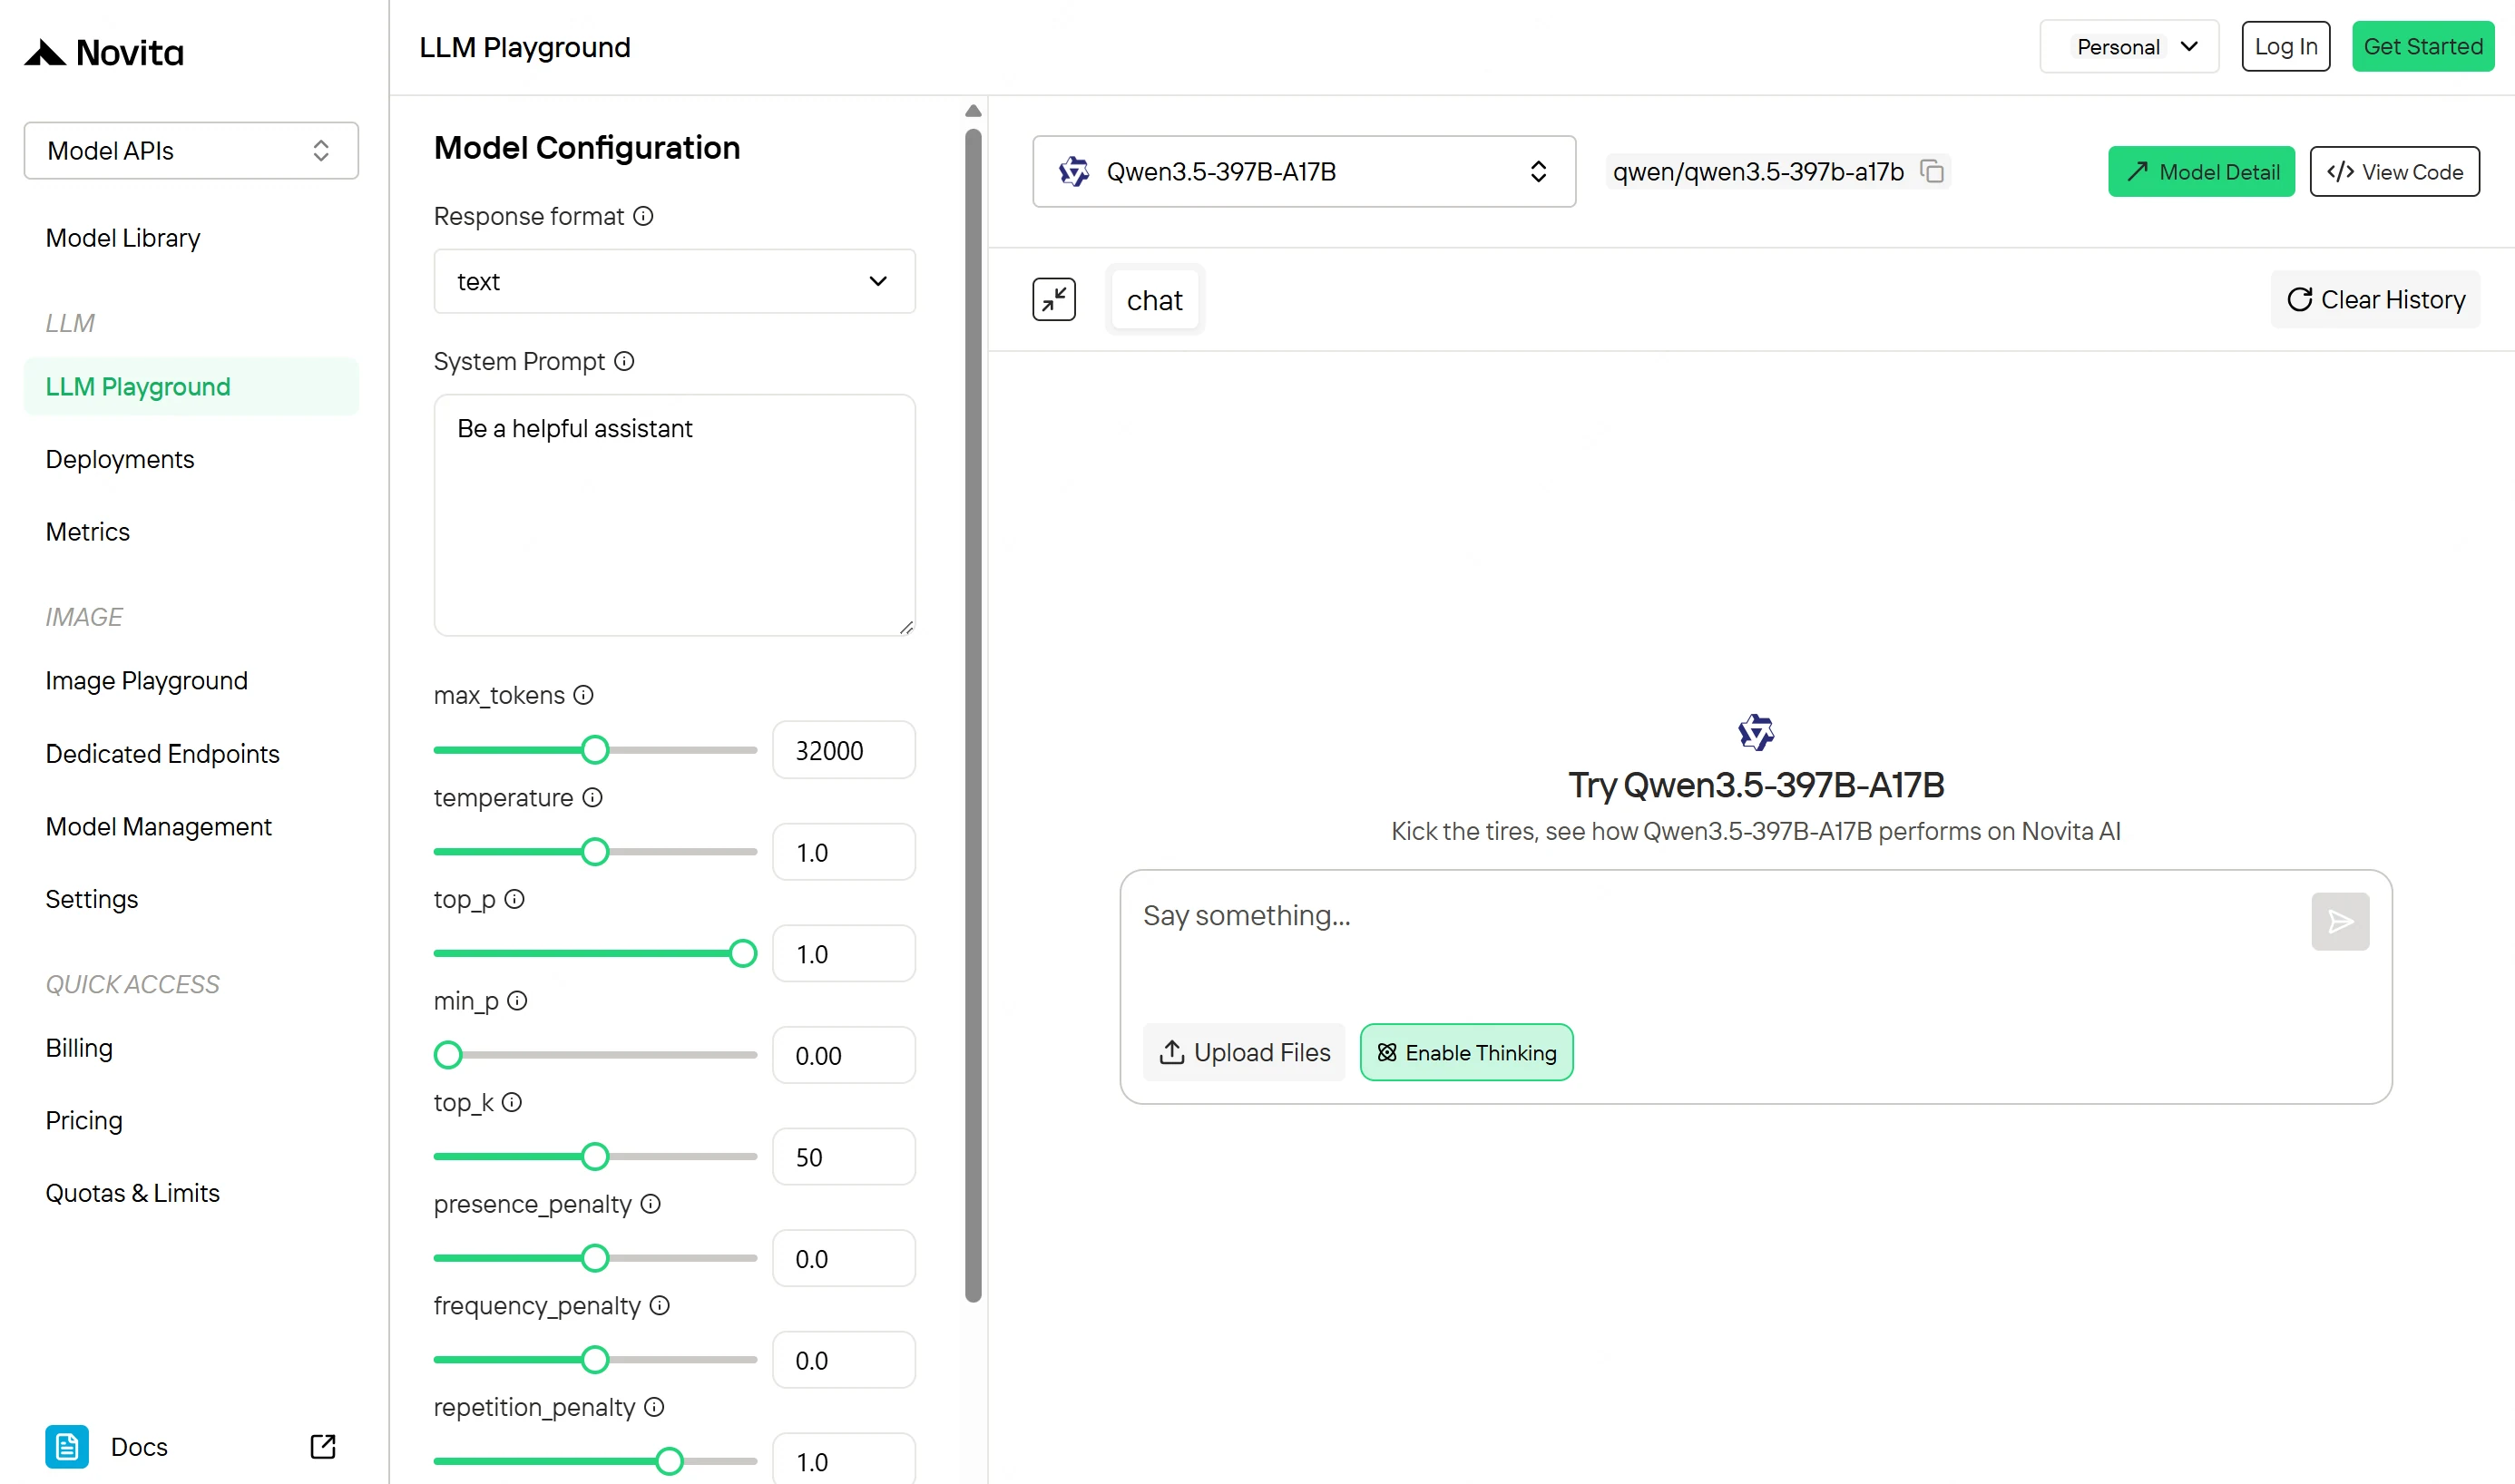
빠른 시작: Novita Playground에서 DeepSeek OCR2 즉시 사용해 보기
문서에 대한 OCR2를 검증하는 가장 빠른 방법은 설정 없이 Novita Playground 에서 몇 가지 실제 샘플을 실행하는 것입니다.
⚠ 참고: 결정적이고 안정적인 출력을 위해
temperature와top_k를 모두0으로 설정하세요. 이렇게 하면 무작위성이 비활성화되어 실행 간에 일관된 결과가 보장됩니다.
API 키 발급
- 1단계: 계정 만들기 또는 로그인
novita.ai를 방문하여 ** 회원가입**하거나 기존 계정으로 로그인하세요.
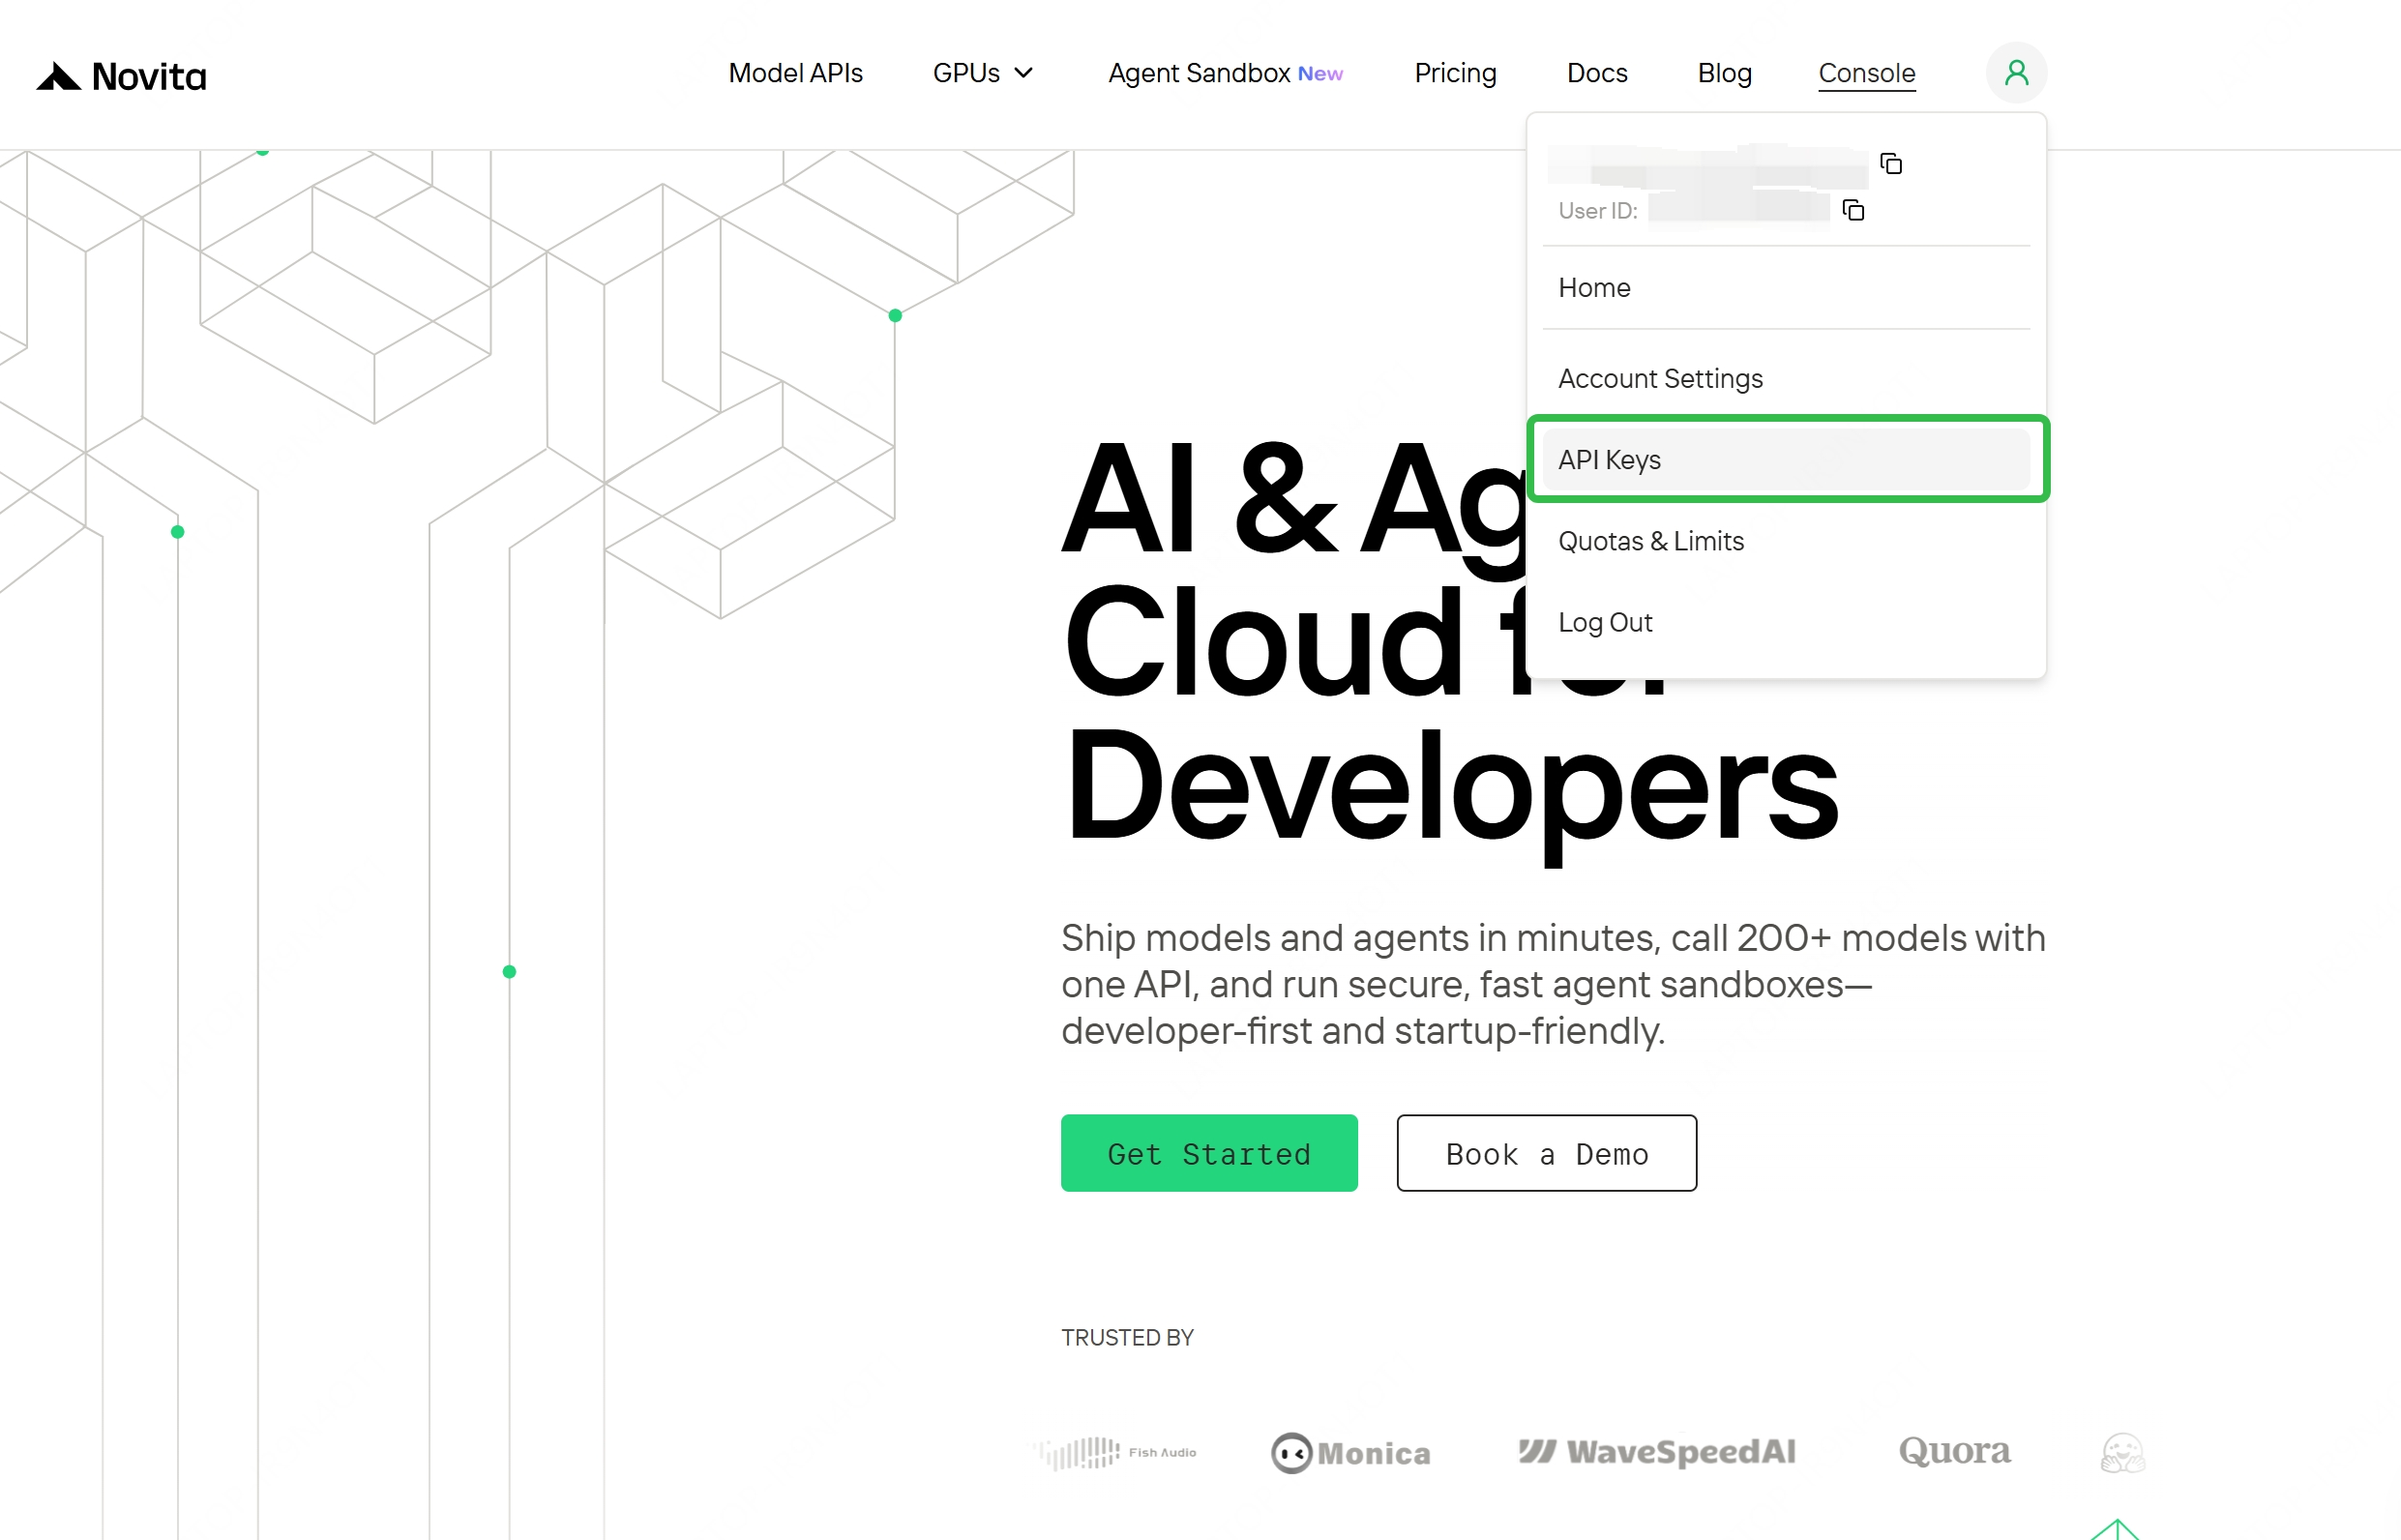
- 2단계: 키 관리로 이동
로그인 후 "API Keys"를 찾으세요.
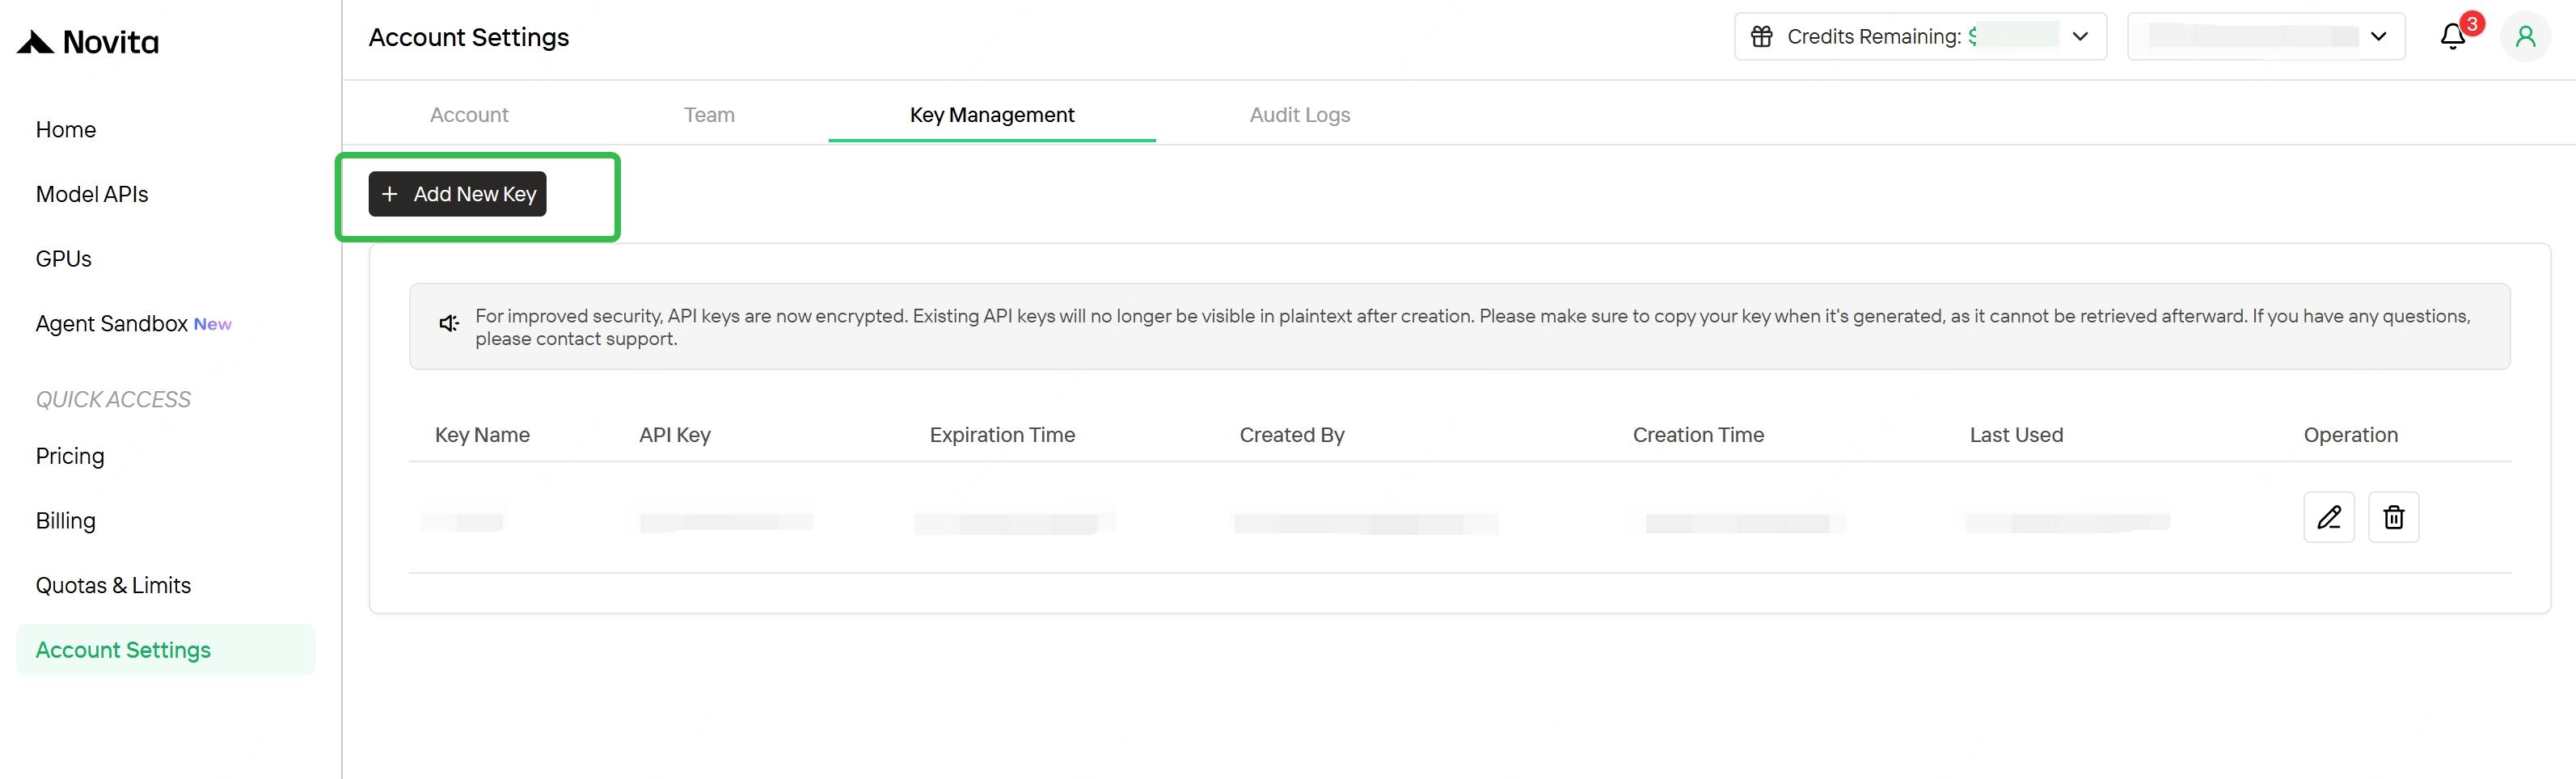
- 3단계: 새 키 만들기
“Add New Key” 버튼을 클릭하세요.
- 4단계: 키를 즉시 저장하세요
키가 생성되면 바로 복사하여 보관하세요. 일반적으로 한 번만 표시되며 나중에 다시 조회할 수 없습니다. 키는 비밀번호 관리자나 암호화된 메모와 같은 안전한 위치에 보관하세요.
API 사용법 (Python)
다음 코드 예제를 사용하여 API와 통합하세요:
from openai import OpenAI

client = OpenAI(
    api_key="<Your API Key>",
    base_url="https://api.novita.ai/openai"
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr-2",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Hello, how are you?"}
    ],
    max_tokens=8192,
    temperature=0.7
)

print(response.choices[0].message.content)
위 예제는 Python을 사용하지만, Novita의 API는 TypeScript, Java, Go, Shell 과 같은 다른 언어에서도 동일하게 작동합니다. 클라이언트 라이브러리만 변경하면 됩니다.
결론
DeepSeek OCR2는 시각적 인코딩을 고정 스캔에서 의미론적, 인과 기반 읽기로 전환하여 문서 인텔리전스를 한 단계 끌어올립니다. 특히 표, 다단 PDF, 복잡한 양식과 같은 복잡한 레이아웃에서 매우 유용합니다. Novita AI를 OCR2 API 공급자로 사용하면 OpenAI 호환 통합, 빠른 온보딩, 입력 토큰 100만 개당 $0.03, ** 출력 토큰 100만 개당 $0.03**의 투명한 가격을 얻을 수 있습니다. 프로덕션 OCR 워크플로우(PDF → Markdown/JSON, 송장 추출, 문서 → RAG)를 구축하고 있다면, Novita는 프로토타입에서 대규모 처리량까지 깔끔하고 확장 가능한 경로를 제공합니다.
Novita AI는 개발자에게 간단한 API를 통해 AI 모델을 손쉽게 배포할 수 있는 환경을 제공하고, 구축과 확장을 위한 합리적이고 안정적인 GPU 클라우드도 제공하는 AI 클라우드 플랫폼입니다.
자주 묻는 질문
DeepSeek는 OCR을 지원하나요?
네. DeepSeek는 문서 및 이미지 텍스트 인식을 위한 2세대 OCR 모델인 DeepSeek OCR2 를 통해 OCR 기능을 제공합니다. 강력한 레이아웃 이해 기능을 갖추고 있습니다.
DeepSeek OCR은 무료인가요?
DeepSeek OCR2는 **모델 수준에서는 오픈소스 ** 이지만, API 사용은 무료가 아닙니다.
Novita AI 를 사용하면 비용 효율적이고 투명한 종량제 가격 으로 인프라 오버헤드 없이 이용할 수 있어, 프로덕션 사용을 위한 자체 호스팅보다 훨씬 실용적이고 경제적입니다.
DeepSeek OCR에 어떻게 접근하나요?
DeepSeek OCR2는 **오픈소스 모델을 자체 호스팅 ** 하거나 Novita AI 와 같은 클라우드 API 공급자 를 통해 접근할 수 있습니다. Novita AI는 즉시 사용 가능한 API 액세스, 플레이그라운드, SDK 호환 통합을 제공합니다.
DeepSeek OCR API와 DeepSeek OCR2 API 사이에 차이가 있나요?
네. deepseek/deepseek-ocr(Gen 1)과 deepseek/deepseek-ocr-2는 Novita 카탈로그에서 별개의 모델 ID이며, Gen 2만 현재 활발히 지원되는 버전입니다. 통합이 여전히 Gen 1 모델 ID를 가리키고 있다면 deepseek/deepseek-ocr-2로 전환하세요. 위 설정 단계는 해당 문자열 하나만 제외하면 동일합니다.