DeepSeek OCR API をお探しですか?DeepSeek は、初代 DeepSeek-OCR とその後継である DeepSeek OCR2 の 2 世代をリリースしています。Novita AI は現行世代である deepseek/deepseek-ocr-2 を OpenAI 互換エンドポイントとして提供しており、このガイドではその呼び出し方、コスト、そしてコードを書く前に 2 世代を区別する方法について解説します。
OCR はもはや単なる「テキスト抽出」ではありません。現代のチームに求められているのは **ドキュメントインテリジェンス **、すなわち、読み順、レイアウト、表、構造化された出力を、エンタープライズ OCR の価格タグを付けずに大規模に処理することです。DeepSeek OCR2 は、新しい視覚エンコードパラダイムによってこのトレンドをさらに推し進め、Novita AI は API と透明なトークン価格設定により、本番環境への導入を実用的なものにしています。
Gen 1 vs Gen 2: すでに
model="deepseek/deepseek-ocr"(Gen 1)を呼び出すコードがある場合は、新しい作業をデプロイする前に DeepSeek-OCR on Novita AI の記事を確認してください。Novita のライブモデルカタログでは、このモデル ID は他の引退世代モデルとともにレガシーステータスでリストされているため、新しい統合は代わりに以下のdeepseek/deepseek-ocr-2をターゲットにする必要があります。
DeepSeek OCR2 とは
基本紹介
DeepSeek-OCR 2 は、DeepSeek AI によるマルチモーダル文書認識モデルであり、DeepSeek-OCR(Gen 1)のアップグレード版として位置づけられています。その主要な変更点は DeepEncoder V2 であり、視覚処理を rigid な「ラスタースキャン」(左上→右下)から、** 意味的で因果関係に基づいた読み取り**へと移行させます。これは、複雑な文書内の論理構造を人間がたどる方法に近いものです。
従来の OCR パイプラインは、マルチカラムの PDF、密集した財務諸表、表と脚注が混在した文書、読み順が複雑なフォームなどでしばしば破綻します。OCR2 は、「文字を認識する」だけでなく、ページを理解する ように設計されています。
| 特徴 | DeepSeek OCR2 |
| 組織 | DeepSeek AI |
| モデルタイプ | マルチモーダル文書認識(OCR + レイアウト認識) |
| 主要な革新 | DeepEncoder V2 が画像セマンティクスに基づいて視覚トークンを再順序付け(「固定スキャン」→「意味的推論」) |
| コンテキストウィンドウ / 最大出力 | 8,192 / 8,192 |
| 入力 / 出力 | 入力:テキスト、画像 / 出力:テキスト |
| 量子化 | bf16 |
| ライセンス | Apache-2.0 |
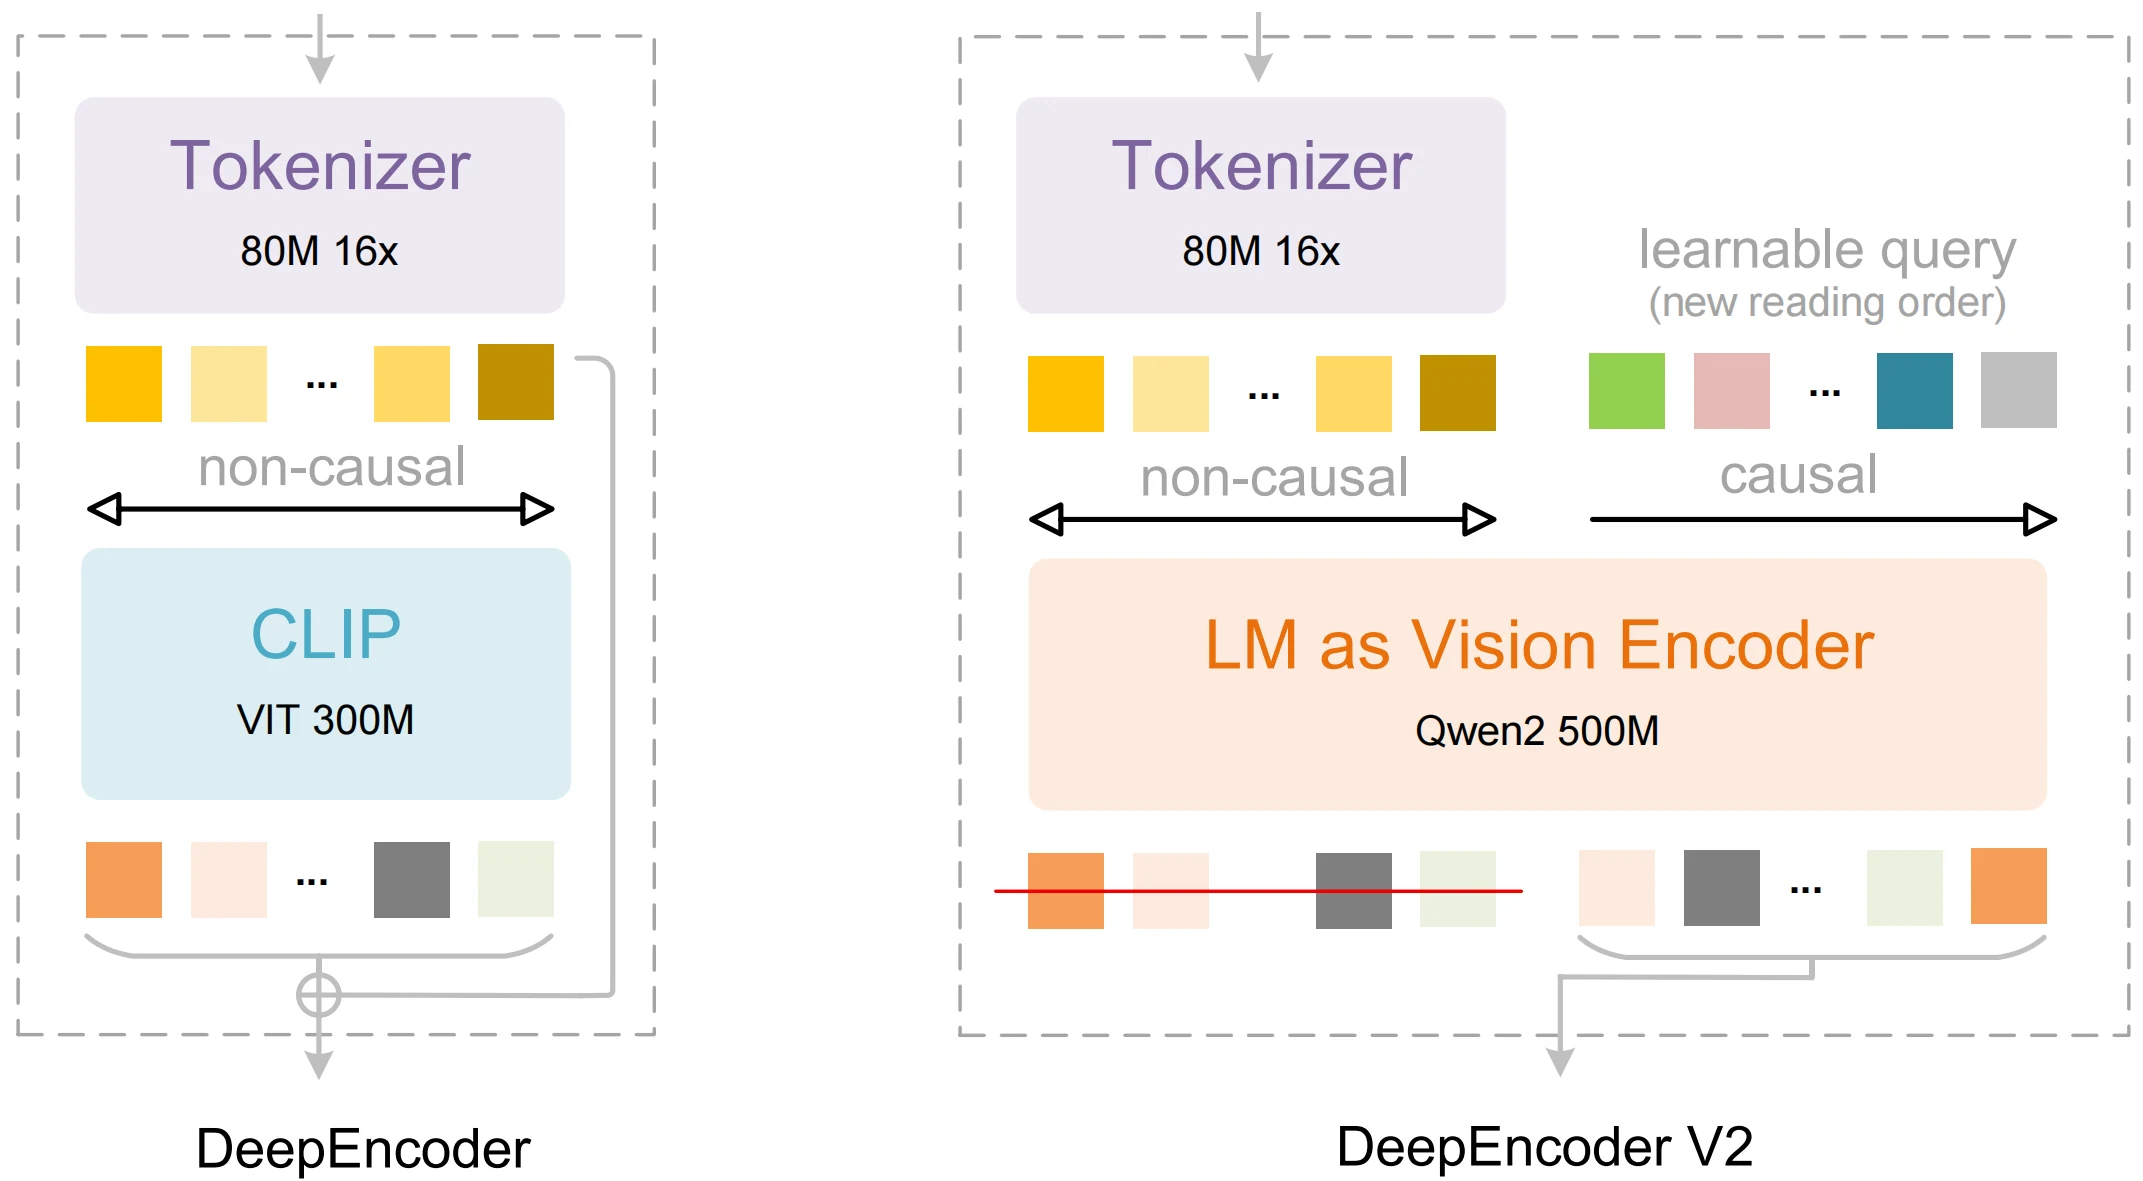
DeepSeek-OCR 2: Visual Causal Flow
🔍 概要は以下の通りです:
- エンコーダ側 : DeepEncoder V2 は、LLM スタイルのデコードステップの前に、 画像セマンティクスに基づいて視覚トークンを再順序付けできます。
- **システム設計 **: OCR2 は、**DeepSeek-3B-MoE デコーダ ** を維持しつつ、元の CLIP ベースのエンコーダを軽量 LLM コンポーネント(Qwen2-0.5B)に置き換えたものと説明されています。
- **トークン効率 **: OCR2 は、制約された視覚トークンバジェット(複雑さに応じて 256~1120 の範囲と報告)を使用して文書カバレッジをターゲットにしています。
ベンチマークパフォーマンス
OCR2 の改善は、ドキュメント中心のベンチマークで最も顕著です:
- OmniDocBench v1.5 では、DeepSeek-OCR 2 は ** 全体で 91.09%** を達成し、前世代から +3.73% の向上を示し、** 読み順編集距離 ** を 0.085 → 0.057 に削減しました。
- OmniDocBench は、多様な文書タイプ、レイアウト、言語にわたる ** 現実世界の PDF 解析** を評価するために設計されています。
請求書取り込み、請求処理、コンプライアンス PDF、マニュアルに対する RAG などのドキュメントワークフローを構築している場合、これらの指標は、単なる文字レベルの認識ではなく、構造 + レイアウトの理解 を測定するため、一般的な「OCR 精度」よりも重要です。
AI API プロバイダーの評価方法:5 つの重要な指標
モデルを選ぶことは意思決定の半分に過ぎません。プロバイダー によって、信頼性を持ってスケールできるかどうかが決まります。
| 指標 | 主要な焦点 | ビジネスへの影響 | Novita AI / DeepSeek-OCR2 のコンテキスト |
| コンテキスト長 | トークン制限 | チャンク削減 → 呼び出し削減 → パイプラインの単純化 | 8,192 トークンのコンテキストは、マルチページ解析を 1 パスで処理するのに役立つ |
| トークンコスト | API 価格設定 | 大規模抽出の ROI に直接影響 | 高ボリューム OCR ワークロード向けに最適化された価格設定(詳細は以下) |
| レイテンシ(TTFT/TPOT) | 応答速度 | ユーザー向け OCR エクスペリエンスの向上 | 低レイテンシで高速プレビューと応答性の高いアプリを実現 |
| スループット | RPS / 同時実行性 | バッチ処理とピーク時トラフィック処理を可能にする | バッチ処理と同時ジョブ向けの高い同時実行容量 |
| 統合 | 互換性 | 既存のツールを再利用して迅速にリリース | OpenAI 互換ツールで動作。Anthropic スタイルの統合もサポート |
なぜ Novita AI を選ぶべきか?
**注 **: OpenAI 互換 API に加えて、Novita AI は Anthropic 互換インターフェース も提供しており、チームは既存の Claude スタイルのツールやプロンプトを最小限の変更で再利用できます。
開発効率
統合が速い = 価値実現までの時間が短い。Novita は OpenAI 互換 インターフェースを提供しているため、ほとんどのチームは以下を変更するだけで OCR2 を統合できます:
- base_url:
https://api.novita.ai/openai - api_key:
<Your API Key> - モデル名:
deepseek/deepseek-ocr-2
コスト面での優位性
Novita は OCR2 の価格を非常に明確に提示しています。入力トークンと出力トークンに同じ低料金を適用しており、OCR 主体のワークロードの予測を容易にします。
また、Novita はサーバーレスエンドポイントで運用されるため、通常は以下の運用負担が発生しません:
- GPU のプロビジョニング
- 推論サーバーのオートスケーリング
- CUDA + 推論スタックのメンテナンス
DeepSeek OCR2 の API 価格
Novita のモデルカタログでは、deepseek/deepseek-ocr-2 は以下のようにリストされています(2026-08-24 確認、価格は随時更新):
- 入力: $0.03 / 100 万トークン
- 出力: $0.03 / 100 万トークン
- コンテキストウィンドウ: 8,192 トークン
DeepSeek OCR2 API へのアクセス
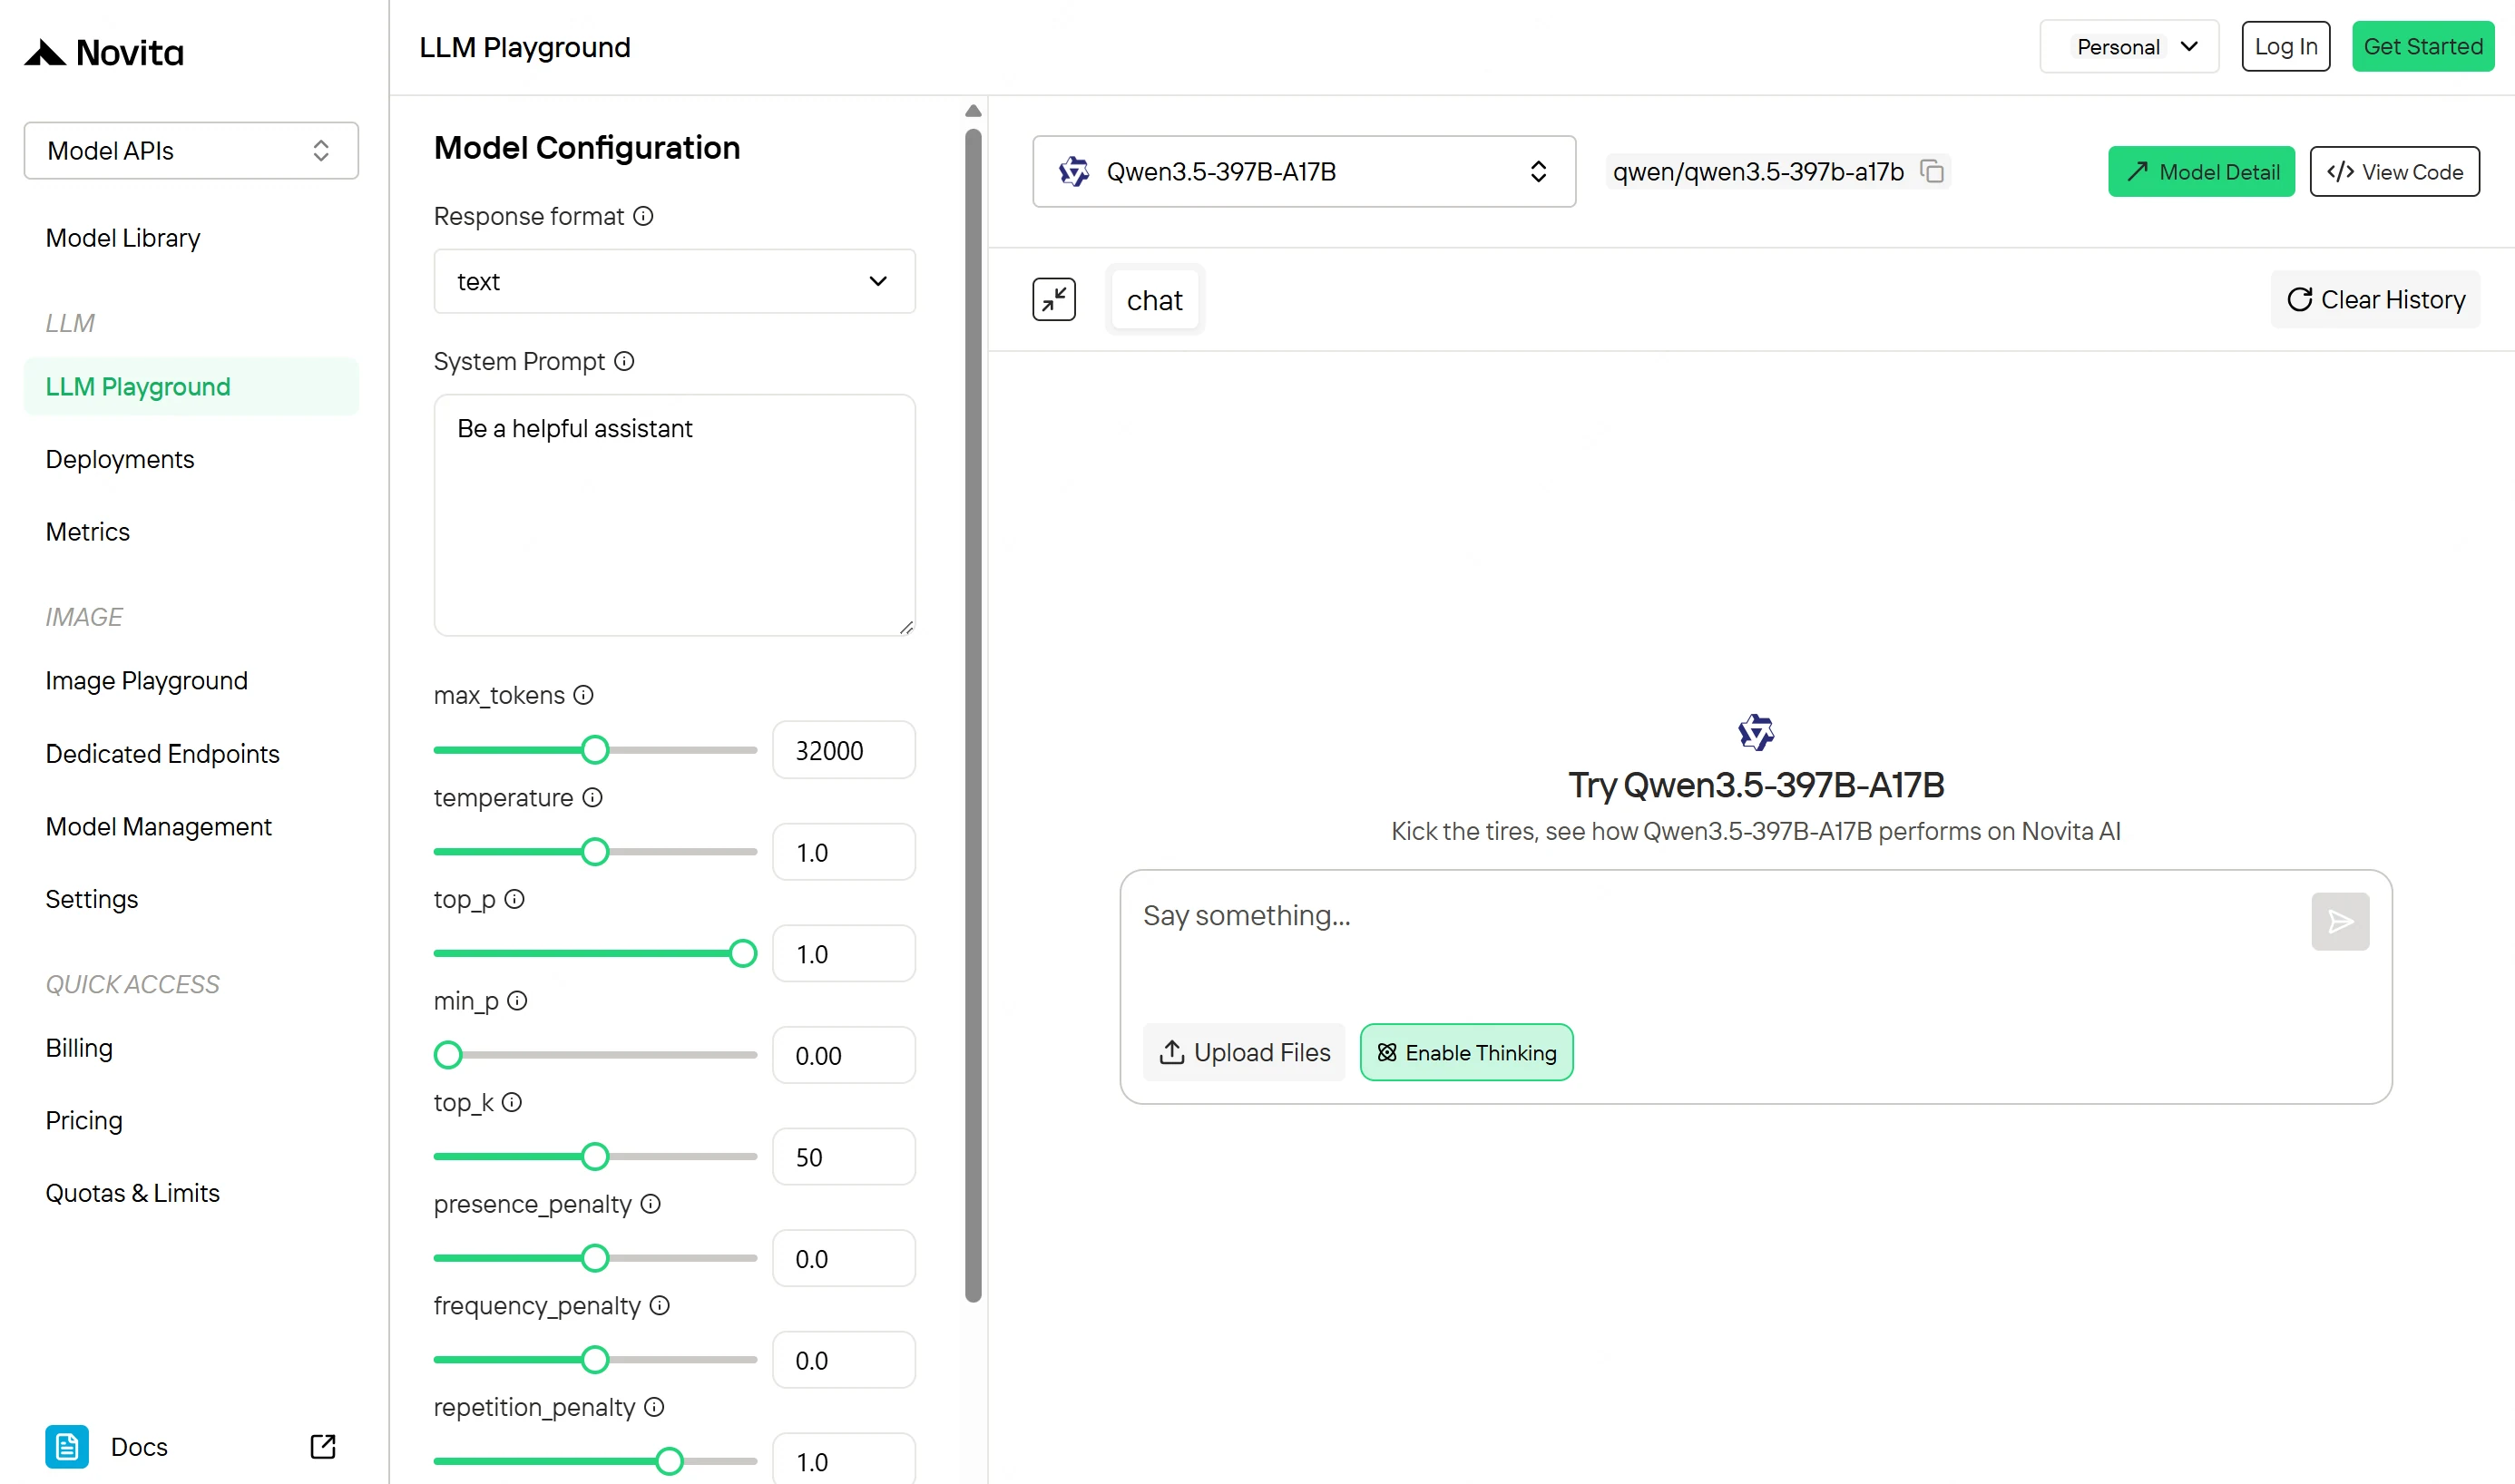
クイックスタート: Novita Playground で DeepSeek OCR2 をすぐに試す
ドキュメントに対する OCR2 を検証する最速の方法は、Novita Playground で実際のサンプルをいくつか実行することです。セットアップは不要です。
⚠ 注意: 決定論的で安定した出力を得るには、
temperatureとtop_kの両方を0に設定してください。これによりランダム性が無効になり、実行間でモデルが一貫した結果を生成することが保証されます。
API キーの取得
- ステップ 1: アカウントを作成またはログインする
novita.ai にアクセスし、** サインアップ** するか、既存のアカウントにログインします。
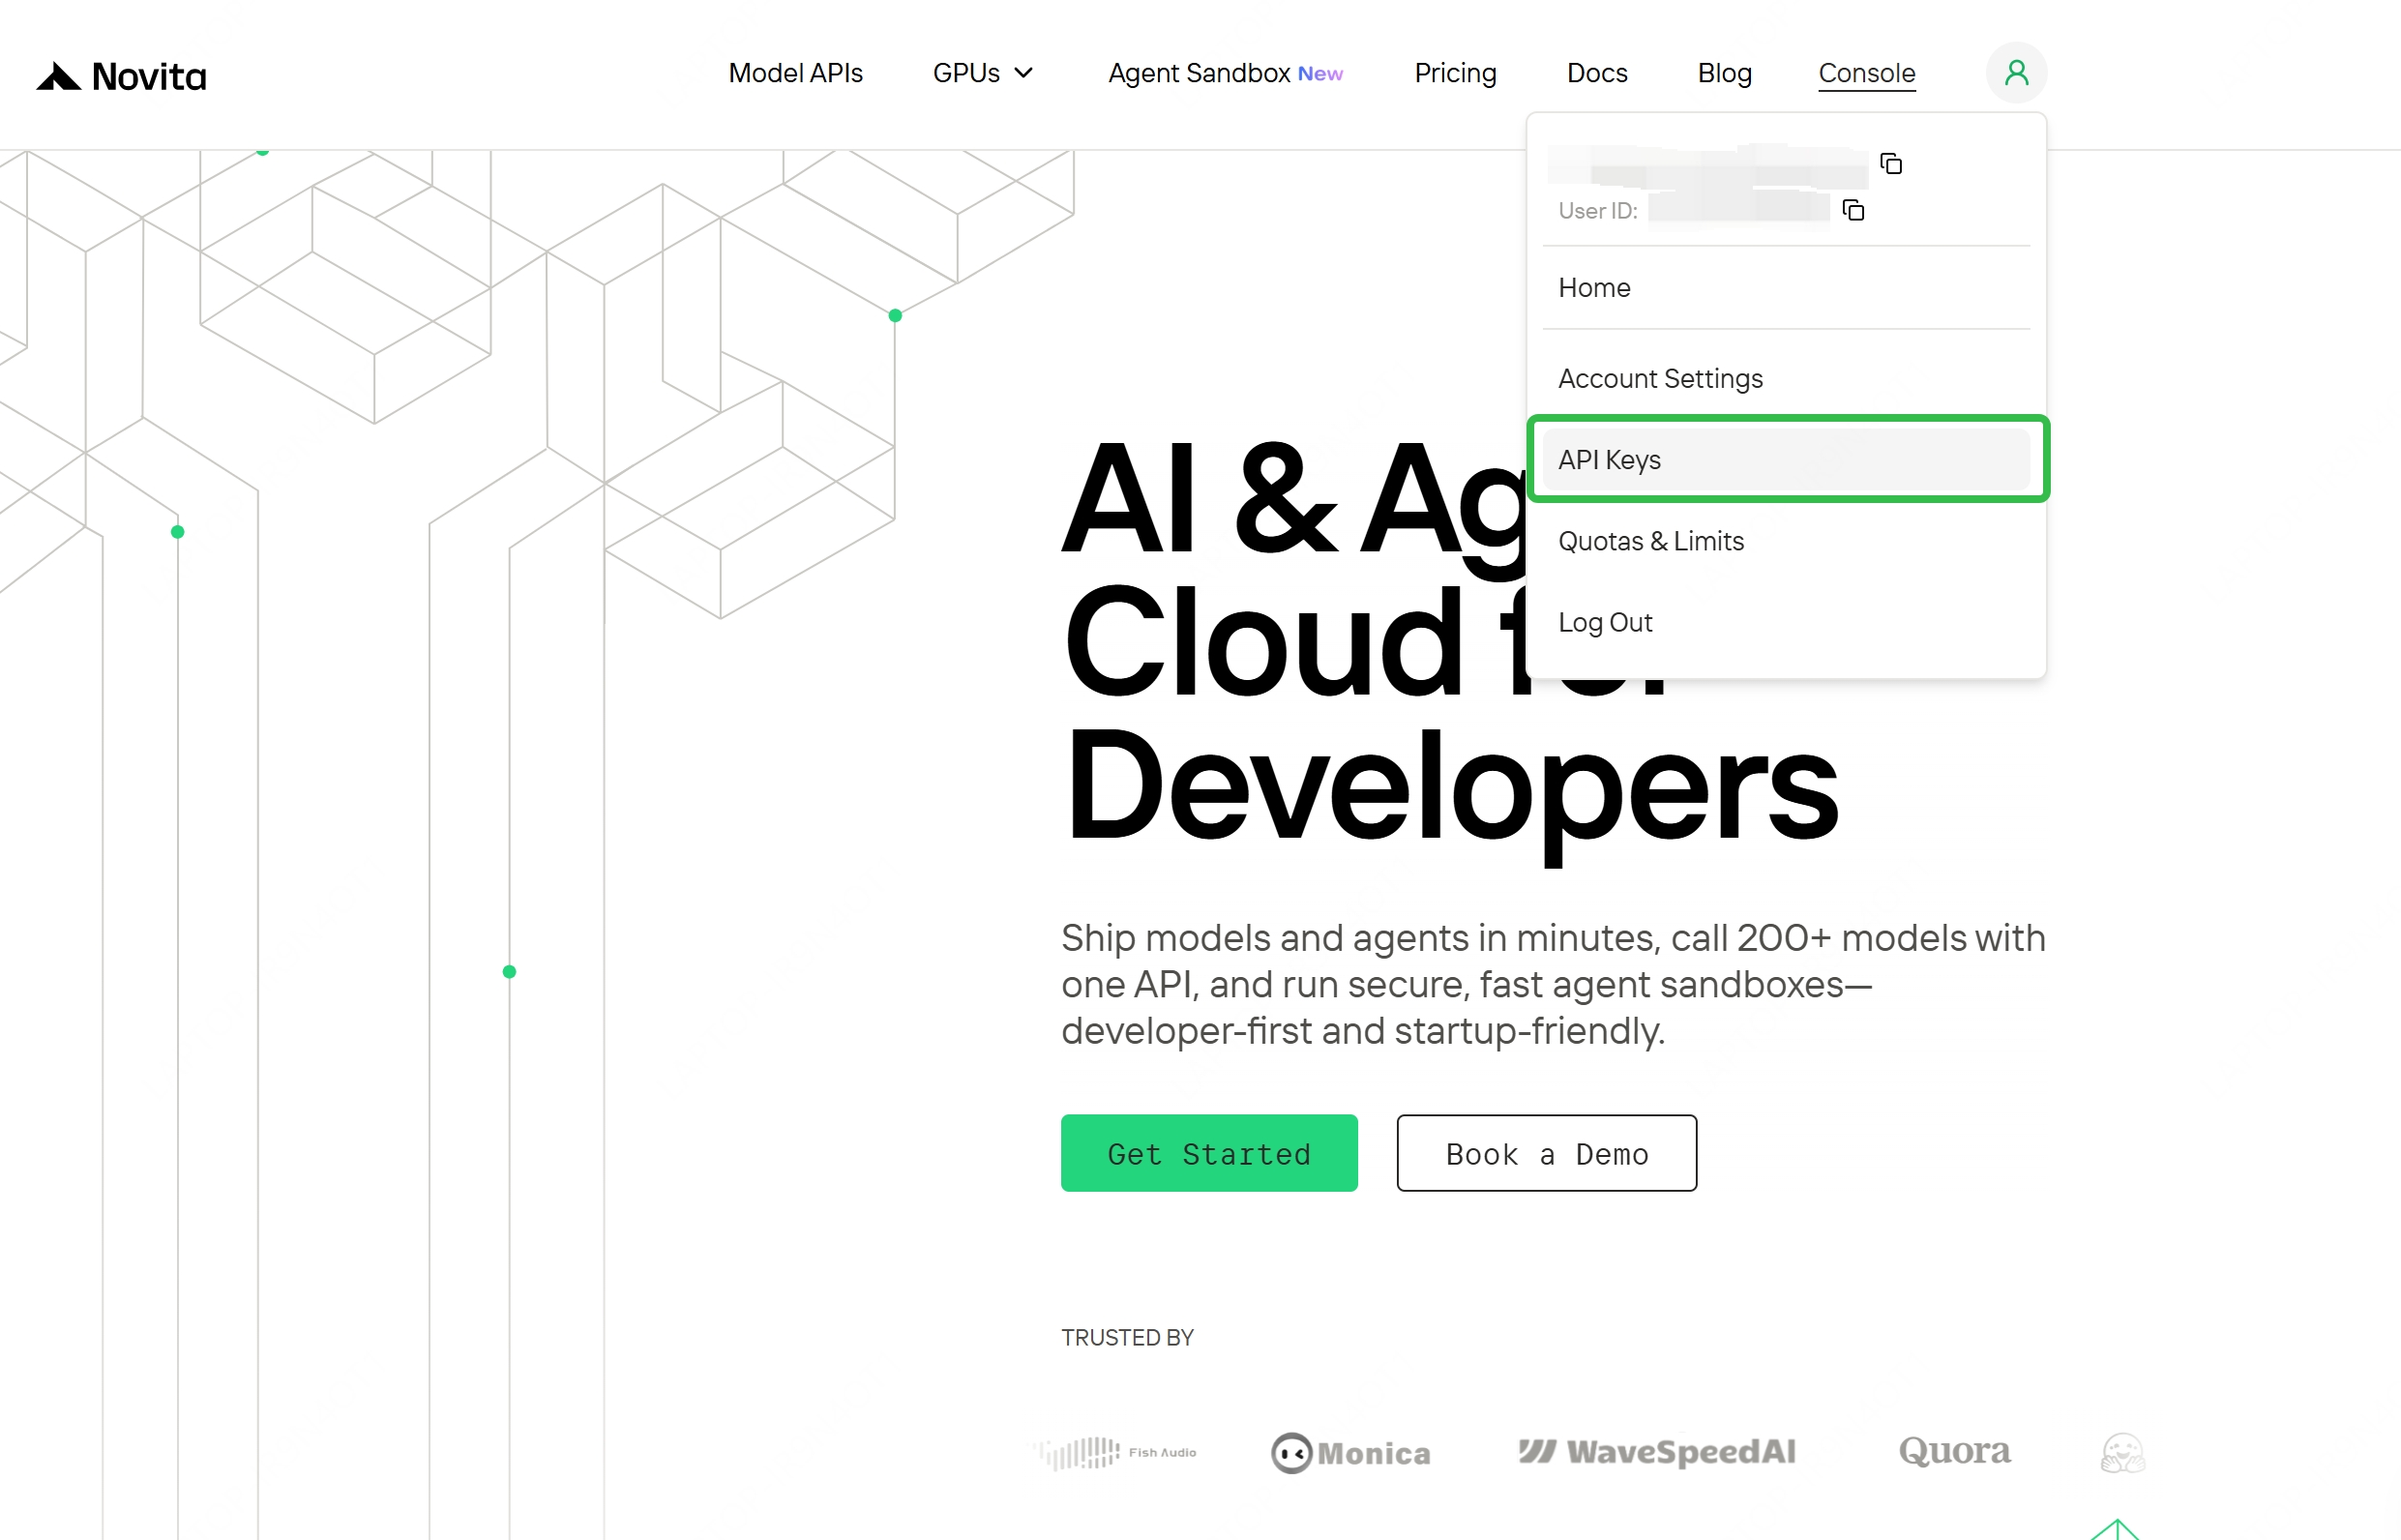
- ステップ 2: キー管理に移動する
ログイン後、「API Keys」を見つけます。
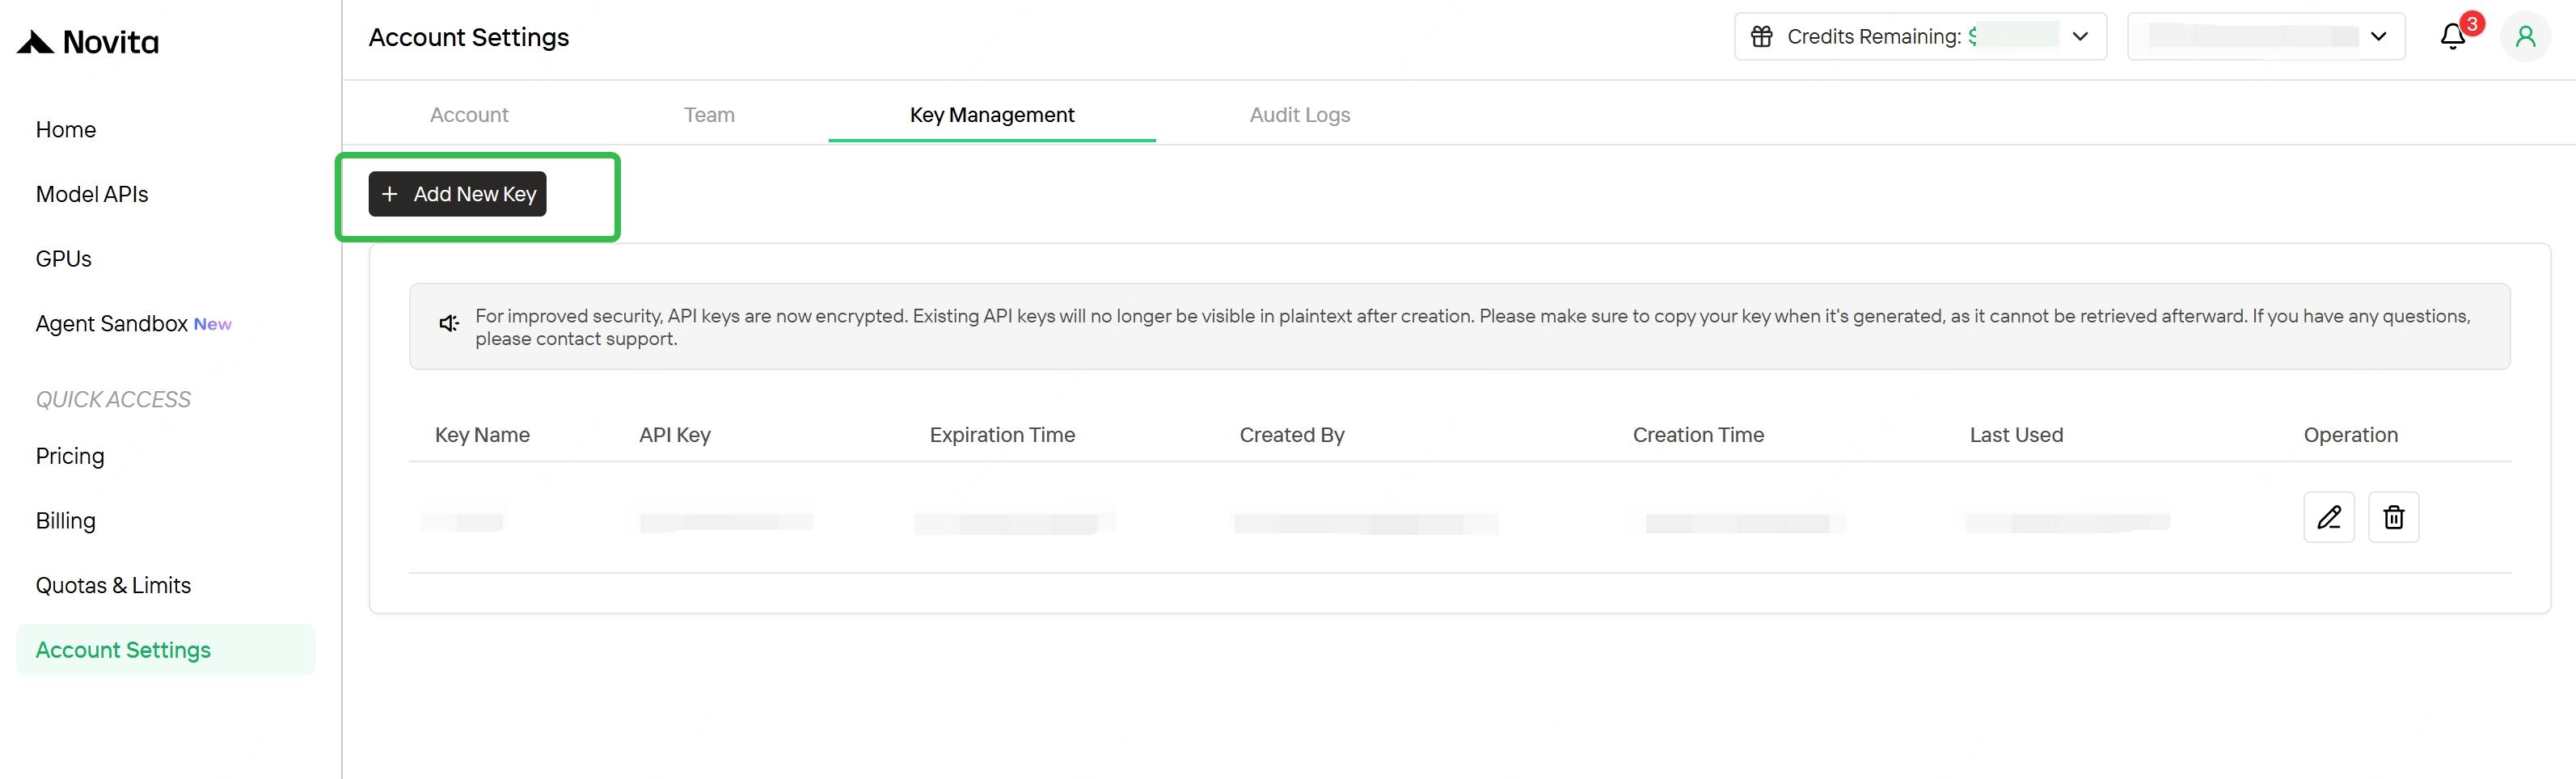
- ステップ 3: 新しいキーを作成する
「Add New Key」ボタンをクリックします。
- ステップ 4: キーをすぐに保存する
キーが生成されたらすぐにコピーして保存してください。通常は一度だけ表示され、後で再取得することはできません。パスワードマネージャーや暗号化されたメモなど、安全な場所にキーを保管してください。
API の使用法(Python)
以下のコード例を使用して、API と統合してください:
from openai import OpenAI

client = OpenAI(
    api_key="<Your API Key>",
    base_url="https://api.novita.ai/openai"
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr-2",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Hello, how are you?"}
    ],
    max_tokens=8192,
    temperature=0.7
)

print(response.choices[0].message.content)
上記の例は Python を使用していますが、Novita の API は TypeScript、Java、Go、Shell などの他の言語でも同じように動作します。クライアントライブラリのみが変更されます。
結論
DeepSeek OCR2 は、視覚エンコーディングを固定スキャンから意味的で因果関係に基づいた読み取りへと移行させることで、ドキュメントインテリジェンスを向上させます。これは、表、マルチカラム PDF、密集したフォームなどの複雑なレイアウトに特に有効です。OCR2 API プロバイダーとして Novita AI を利用することで、OpenAI 互換の統合、迅速なオンボーディング、そして 入力トークン 100 万あたり $0.03、** 出力トークン 100 万あたり $0.03** という透明な価格設定を利用できます。本番環境の OCR ワークフロー(PDF → Markdown/JSON、請求書抽出、文書から RAG へ)を構築している場合、Novita はプロトタイプからスループットまで、クリーンでスケーラブルなパスを提供します。
Novita AI は、開発者がシンプルな API を使用して AI モデルを簡単にデプロイできるようにするとともに、構築とスケーリングのための手頃で信頼性の高い GPU クラウドを提供する AI クラウドプラットフォームです。
よくある質問
DeepSeek は OCR をサポートしていますか?
はい。DeepSeek は、強力なレイアウト理解を備えた文書および画像のテキスト認識用に設計された第 2 世代 OCR モデル DeepSeek OCR2 を通じて OCR 機能を提供しています。
DeepSeek OCR は無料ですか?
DeepSeek OCR2 は モデルレベルではオープンソース ** ですが、API の使用は無料ではありません。
Novita AI を利用することで、 コスト効率が高く、透明性のある、従量課金制の価格設定** をインフラストラクチャのオーバーヘッドなしで利用でき、本番環境での使用においてセルフホスティングよりもはるかに実用的で経済的です。
DeepSeek OCR にアクセスするにはどうすればよいですか?
DeepSeek OCR2 には、オープンソースモデルをセルフホスティングする ** か、Novita AI のような ** クラウド API プロバイダー を使用してアクセスできます。Novita AI は、インスタントな API アクセス、プレイグラウンド、SDK 互換の統合を提供します。
DeepSeek OCR API と DeepSeek OCR2 API に違いはありますか?
はい。Novita のカタログでは deepseek/deepseek-ocr(Gen 1)と deepseek/deepseek-ocr-2 は 2 つの別々のモデル ID であり、Gen 2 のみが現在のアクティブにサポートされているバージョンです。統合がまだ Gen 1 のモデル ID を指している場合は、deepseek/deepseek-ocr-2 に切り替えてください。上記のセットアップ手順は、その文字列以外は同一です。