Procurando por uma API DeepSeek OCR? A DeepSeek lançou duas gerações: o DeepSeek-OCR original e seu sucessor, DeepSeek OCR2. A Novita AI hospeda a geração atual, deepseek/deepseek-ocr-2, como um endpoint compatível com OpenAI, e este guia cobre como chamá-lo, quais seus custos e como distinguir as duas gerações antes de escrever qualquer código.
OCR não é mais apenas “extração de texto”. Equipes modernas precisam de inteligência documental: ordem de leitura, layout, tabelas e saídas estruturadas em escala — sem os preços exorbitantes de OCR empresarial. O DeepSeek OCR2 leva essa tendência adiante com um novo paradigma de codificação visual, e a Novita AI torna prático colocá-lo em produção com API e precificação transparente por token.
Experimente o DeepSeek OCR 2 Agora
Gen 1 vs Gen 2: Se você já possui código chamando
model="deepseek/deepseek-ocr"(Gen 1), consulte o artigo DeepSeek-OCR na Novita AI antes de implantar novos trabalhos nele. O catálogo de modelos ao vivo da Novita lista esse ID de modelo com status legado, junto a outros modelos de geração descontinuada, portanto novas integrações devem mirar emdeepseek/deepseek-ocr-2abaixo.
O que é o DeepSeek OCR2
Introdução Básica
DeepSeek-OCR 2 é um modelo multimodal de reconhecimento de documentos da DeepSeek AI, posicionado como uma atualização do DeepSeek-OCR (Gen 1). Sua principal mudança é o DeepEncoder V2, que move o processamento visual de uma “varredura raster” rígida (canto superior esquerdo → inferior direito) para uma leitura semântica e causalmente informada — mais próxima de como os humanos seguem estruturas lógicas em documentos complexos.
Pipelines tradicionais de OCR frequentemente falham em PDFs com múltiplas colunas, demonstrações financeiras densas, tabelas misturadas com notas de rodapé e formulários com ordem de leitura complicada. O OCR2 é projetado para entender a página, não apenas “reconhecer caracteres”.
| Funcionalidade | DeepSeek OCR2 |
| Organização | DeepSeek AI |
| Tipo de Modelo | Reconhecimento multimodal de documentos (OCR + compreensão de layout) |
| Inovação Principal | DeepEncoder V2 reordena tokens visuais com base na semântica da imagem (“varredura fixa” → “raciocínio semântico”) |
| Janela de Contexto / Saída Máxima | 8.192 / 8.192 |
| Entrada / Saída | Entrada: texto, imagem / Saída: texto |
| Quantização | bf16 |
| Licença | Apache-2.0 |
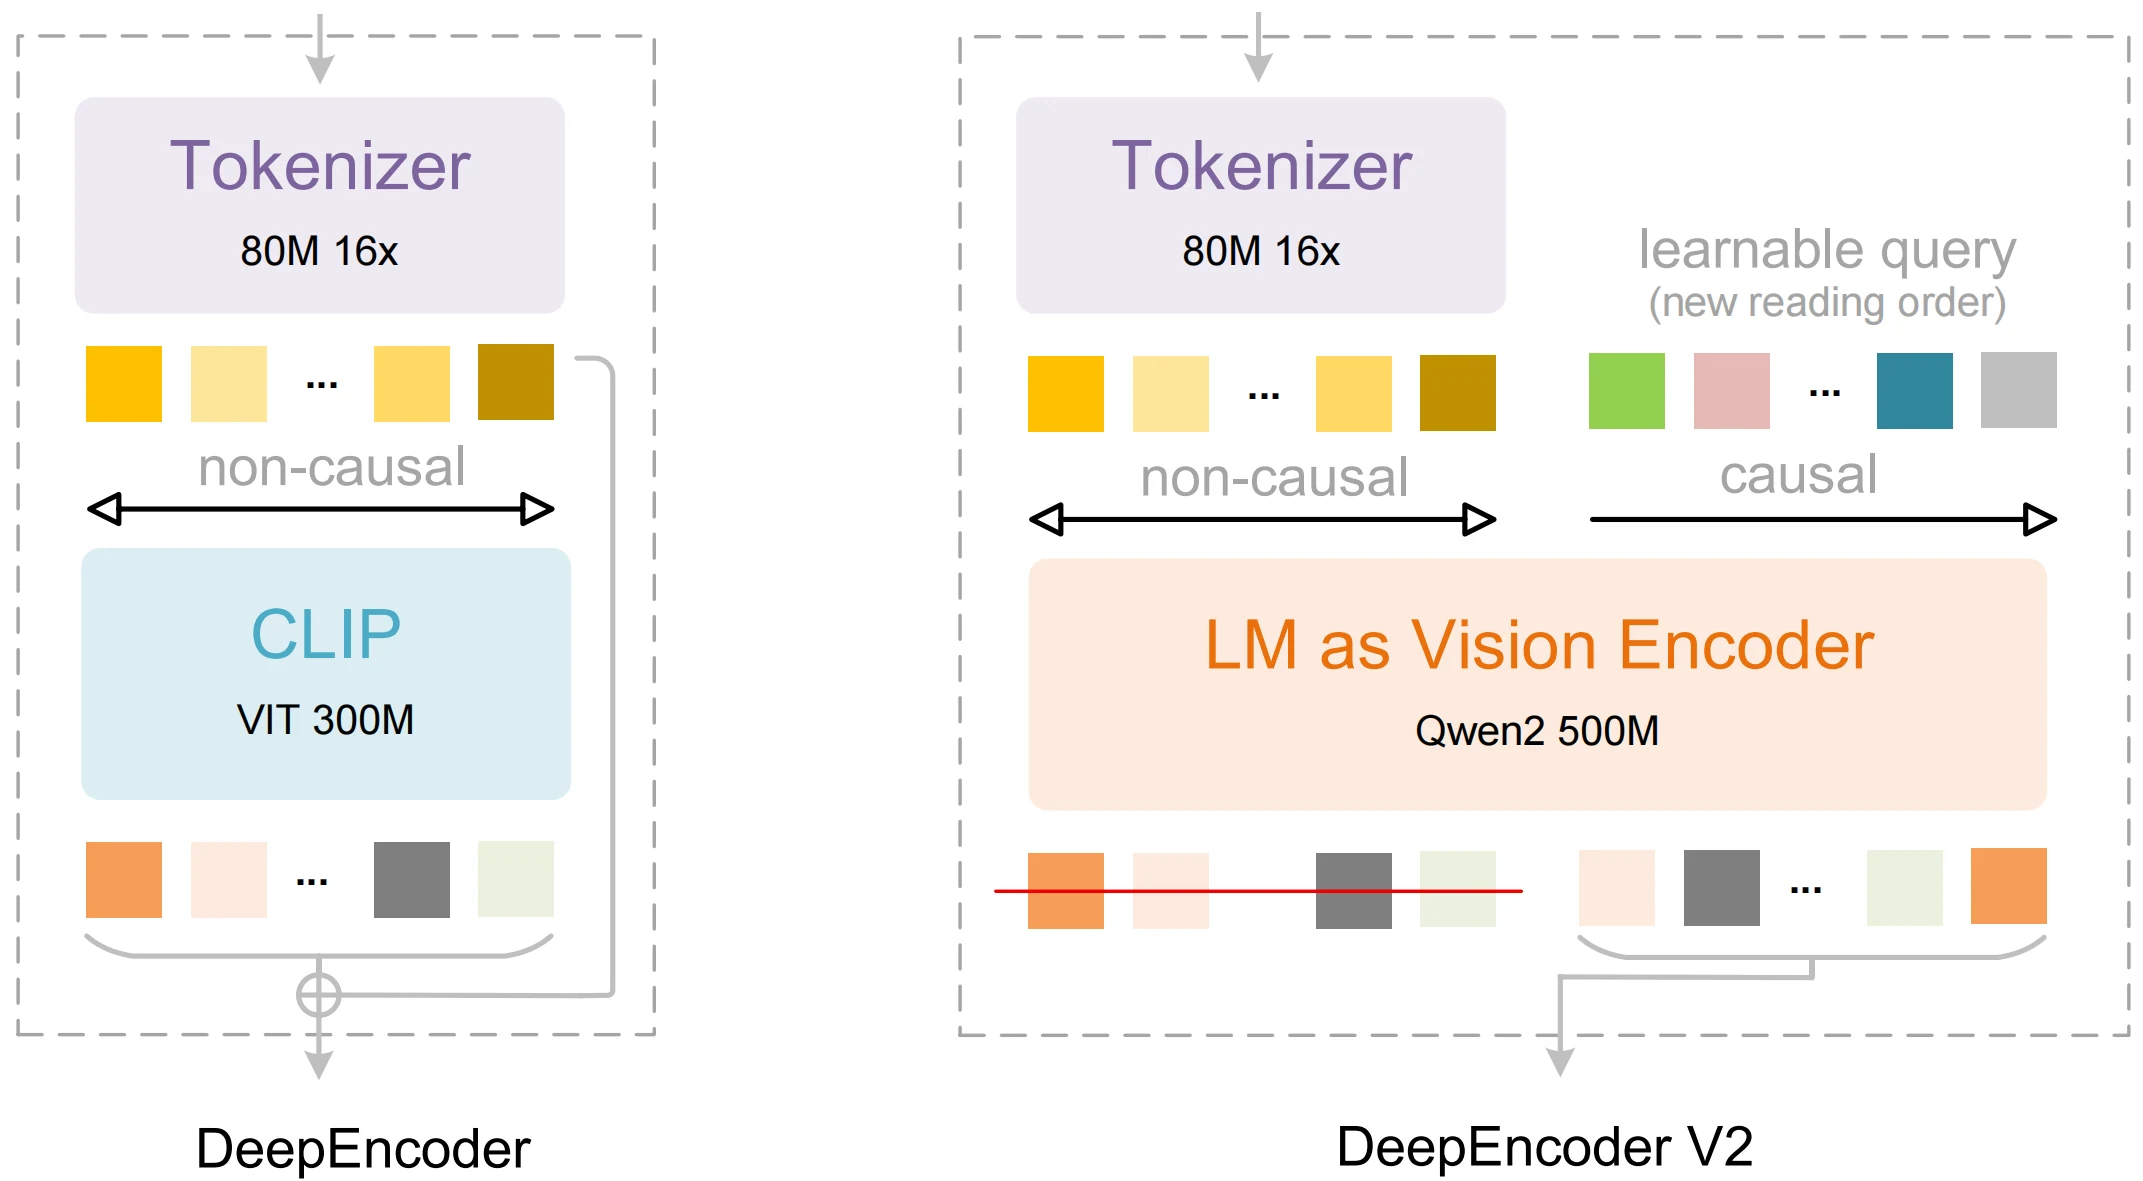
DeepSeek-OCR 2: Fluxo Causal Visual
🔍Em alto nível:
- Lado do codificador: O DeepEncoder V2 pode reordenar tokens visuais com base na semântica da imagem antes da etapa de decodificação estilo LLM.
- Design do sistema: O OCR2 é descrito como mantendo o decodificador DeepSeek-3B-MoE, enquanto substitui o codificador baseado em CLIP original por um componente LLM leve (Qwen2-0.5B).
- Eficiência de tokens: O OCR2 visa cobertura de documentos usando um orçamento restrito de tokens visuais (relatado na faixa de 256–1120 dependendo da complexidade).
Desempenho em Benchmarks
As melhorias do OCR2 são mais visíveis em benchmarks focados em documentos:
- No OmniDocBench v1.5, o DeepSeek-OCR 2 alcança 91,09% no geral, um ganho de +3,73% sobre seu predecessor, e reduz a distância de edição da ordem de leitura de 0,085 → 0,057.
- O OmniDocBench é projetado para avaliar a análise de PDFs do mundo real em diversos tipos de documentos, layouts e idiomas.
Se você está construindo fluxos de trabalho com documentos (extração de faturas, processamento de sinistros, PDFs de conformidade, RAG sobre manuais), essas métricas importam mais do que a “precisão de OCR” genérica, porque medem a compreensão de estrutura + layout, não apenas o reconhecimento no nível de caracteres.
Como Avaliar Provedores de API de IA: As 5 Métricas Principais
Escolher um modelo é apenas metade da decisão — o provedor determina se você pode escalar de forma confiável.
| Métrica | Foco Principal | Impacto nos Negócios | Contexto Novita AI / DeepSeek-OCR2 |
| Comprimento do Contexto | Limite de tokens | Menos chunks → menos chamadas → pipelines mais simples | Janela de 8.192 tokens ajuda a manter a análise de várias páginas em uma única passada |
| Custo por Token | Precificação da API | Impacta diretamente o ROI para extração em larga escala | Precificação otimizada para cargas de trabalho de OCR em alto volume (detalhes abaixo) |
| Latência (TTFT/TPOT) | Velocidade de resposta | Melhora experiências de OCR voltadas ao usuário | Baixa latência para pré-visualizações mais rápidas e aplicativos responsivos |
| Taxa de Transferência | RPS / concorrência | Permite processamento em lote e picos de tráfego | Alta capacidade de concorrência para trabalhos em lote + simultâneos |
| Integração | Compatibilidade | Implante mais rápido reutilizando ferramentas existentes | Funciona com ferramentas compatíveis com OpenAI; também suporta integração estilo Anthropic |
Por que Escolher a Novita AI?
Nota: Além de APIs compatíveis com OpenAI, a Novita AI também fornece interfaces compatíveis com Anthropic, permitindo que equipes reutilizem ferramentas e prompts existentes no estilo Claude com mínimas alterações.
Eficiência de Desenvolvimento
Integração mais rápida = tempo para gerar valor mais rápido. A Novita oferece uma interface compatível com OpenAI, então a maioria das equipes pode integrar o OCR2 apenas alterando:
- base_url:
https://api.novita.ai/openai - api_key:
<Sua Chave de API> - nome do modelo:
deepseek/deepseek-ocr-2
Vantagem de Custo
A Novita lista o OCR2 com precificação extremamente direta: a mesma taxa baixa para tokens de entrada e saída, o que simplifica a previsão para cargas de trabalho pesadas de OCR.
E como a Novita executa endpoints serverless, você geralmente evita o ônus operacional de:
- provisionar GPUs,
- escalar automaticamente servidores de inferência,
- manter pilhas CUDA + inferência.
Preço da API DeepSeek OCR2
No catálogo de modelos da Novita, deepseek/deepseek-ocr-2 é listado como (verificado em 2026-08-24, os preços são atualizados continuamente):
- Entrada: $0,03 / 1M tokens
- Saída: $0,03 / 1M tokens
- Janela de contexto: 8.192 tokens
Acesso à API DeepSeek OCR2
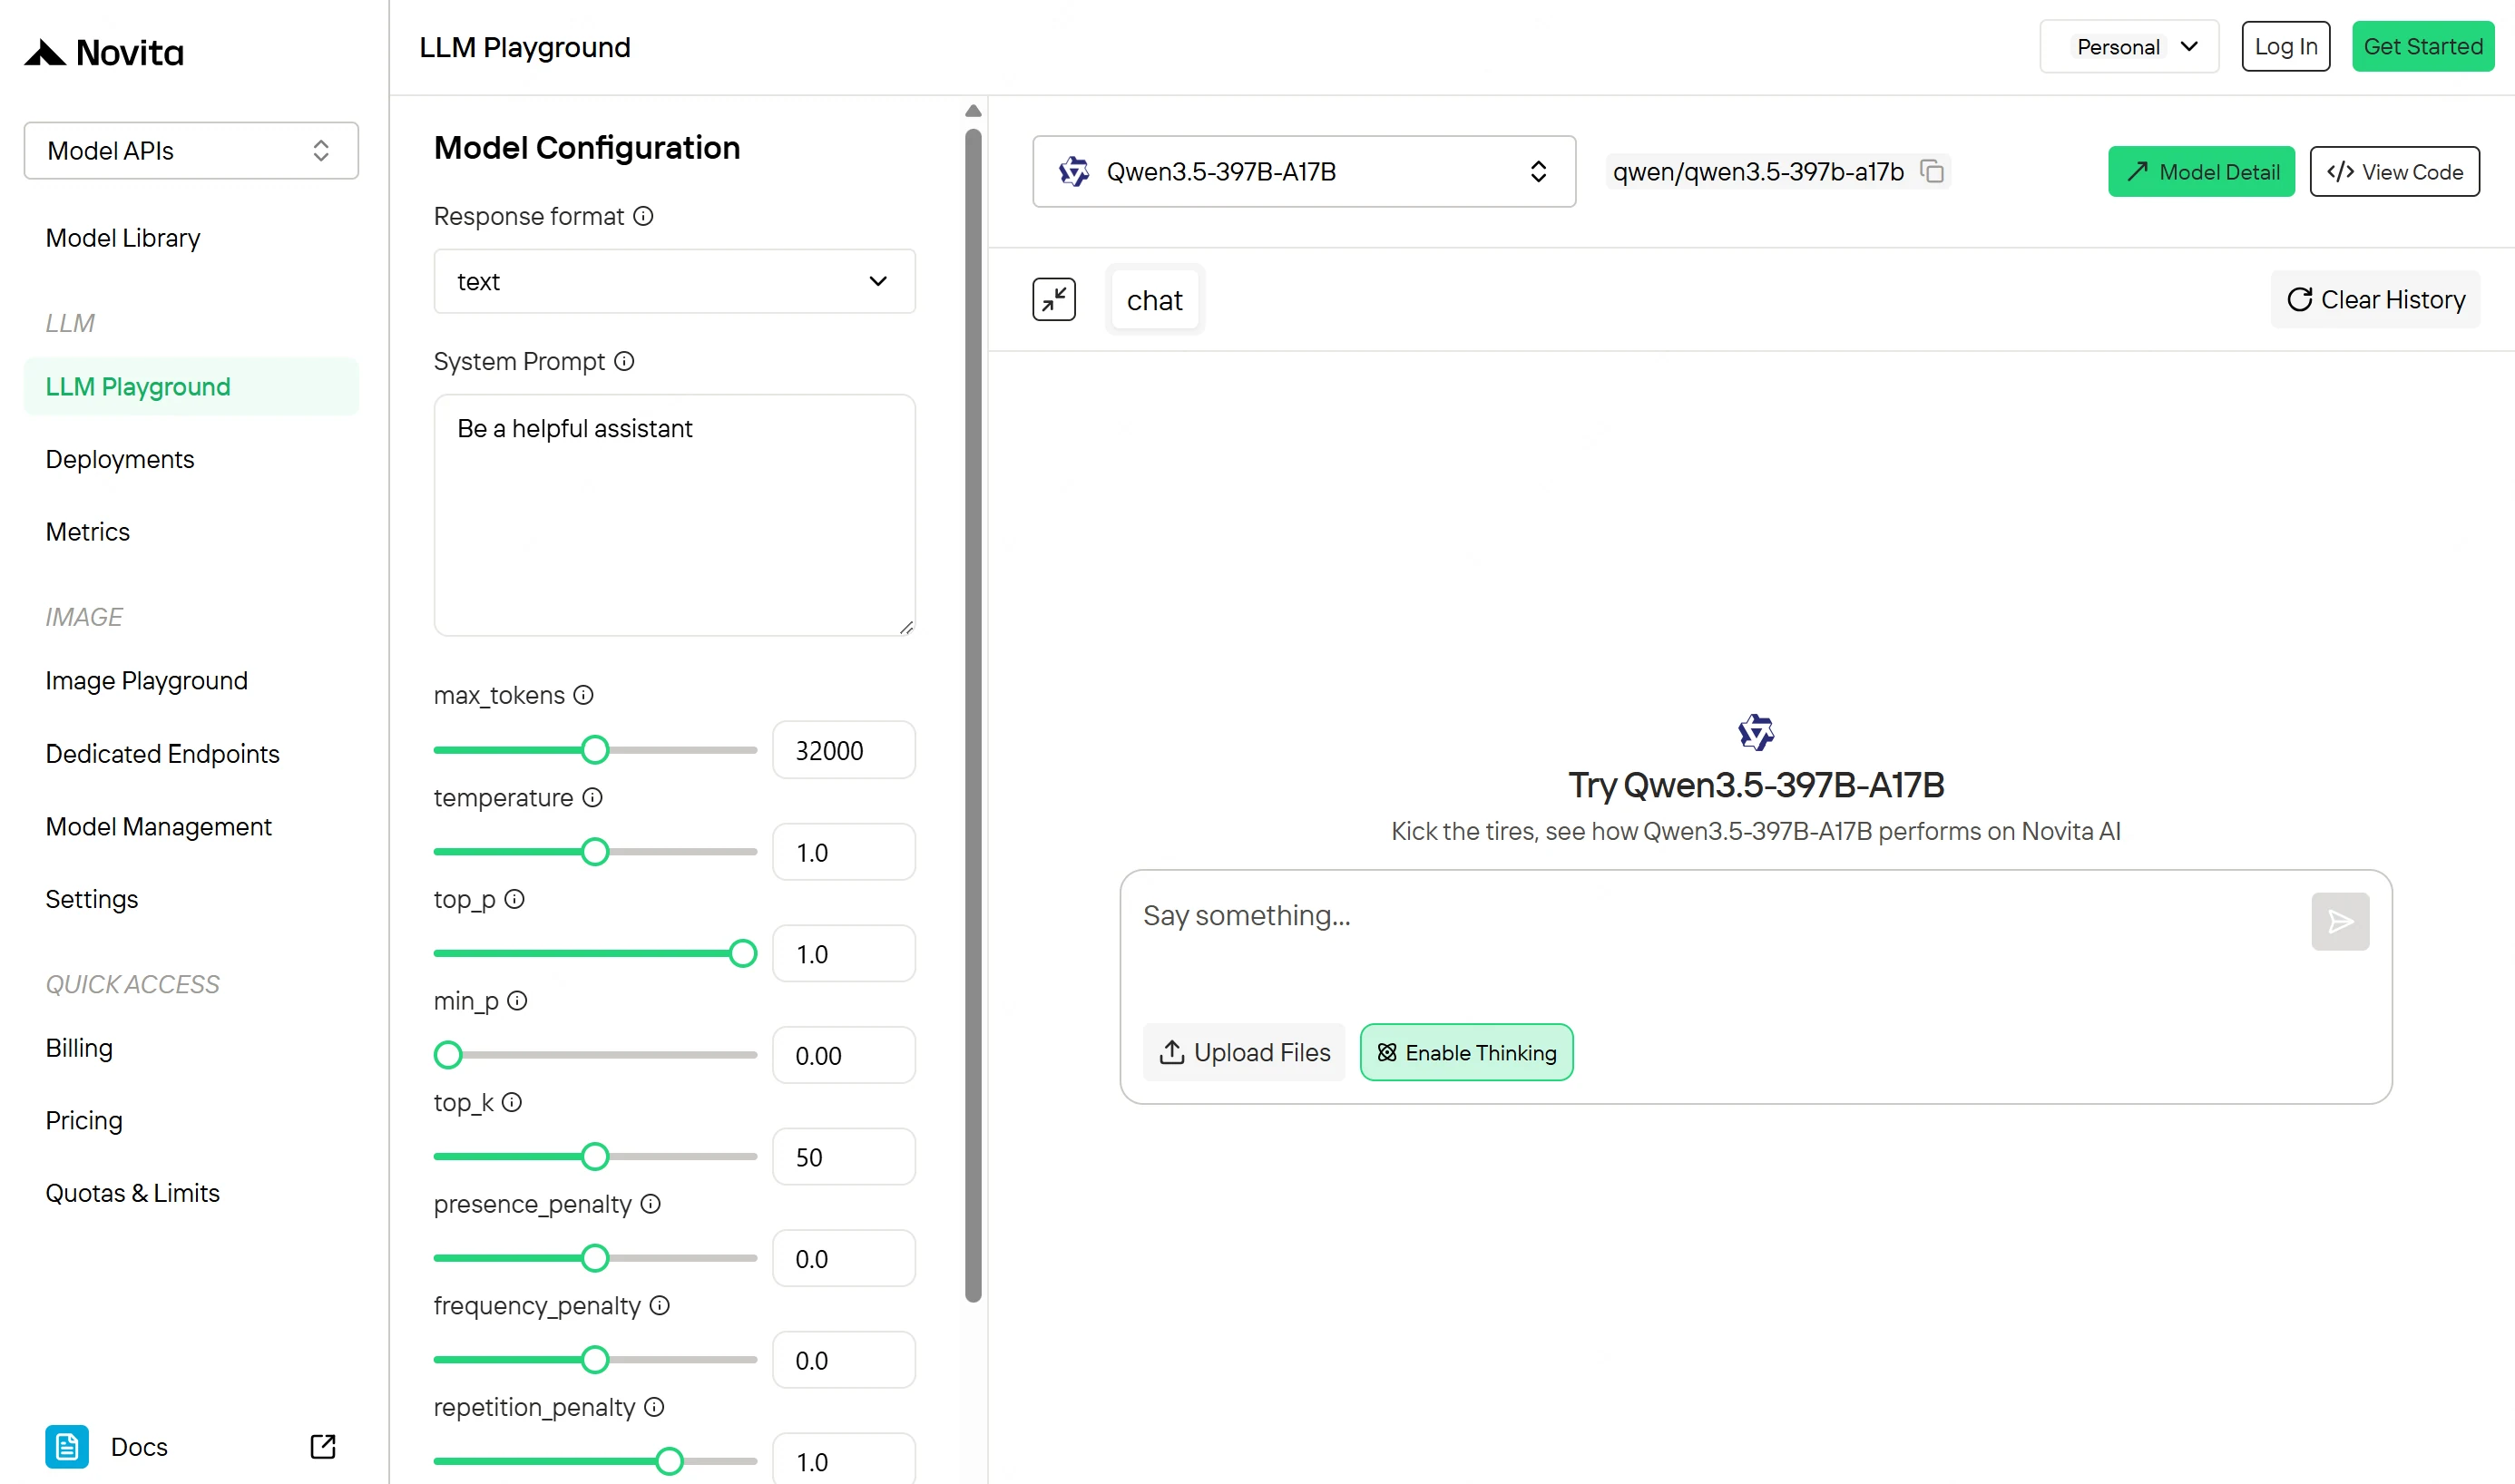
Início Rápido: Experimente o DeepSeek OCR2 Instantaneamente no Novita Playground
A maneira mais rápida de validar o OCR2 para seus documentos é executar algumas amostras reais no Novita Playground — sem necessidade de configuração
⚠ Nota: Para saídas determinísticas e estáveis, defina
temperatureetop_kcomo0. Isso desativa a aleatoriedade e garante que o modelo produza resultados consistentes entre execuções.
Obter uma Chave de API
- Passo 1: Crie ou Faça Login na Sua Conta
Visite novita.ai e cadastre-se ou faça login na sua conta existente
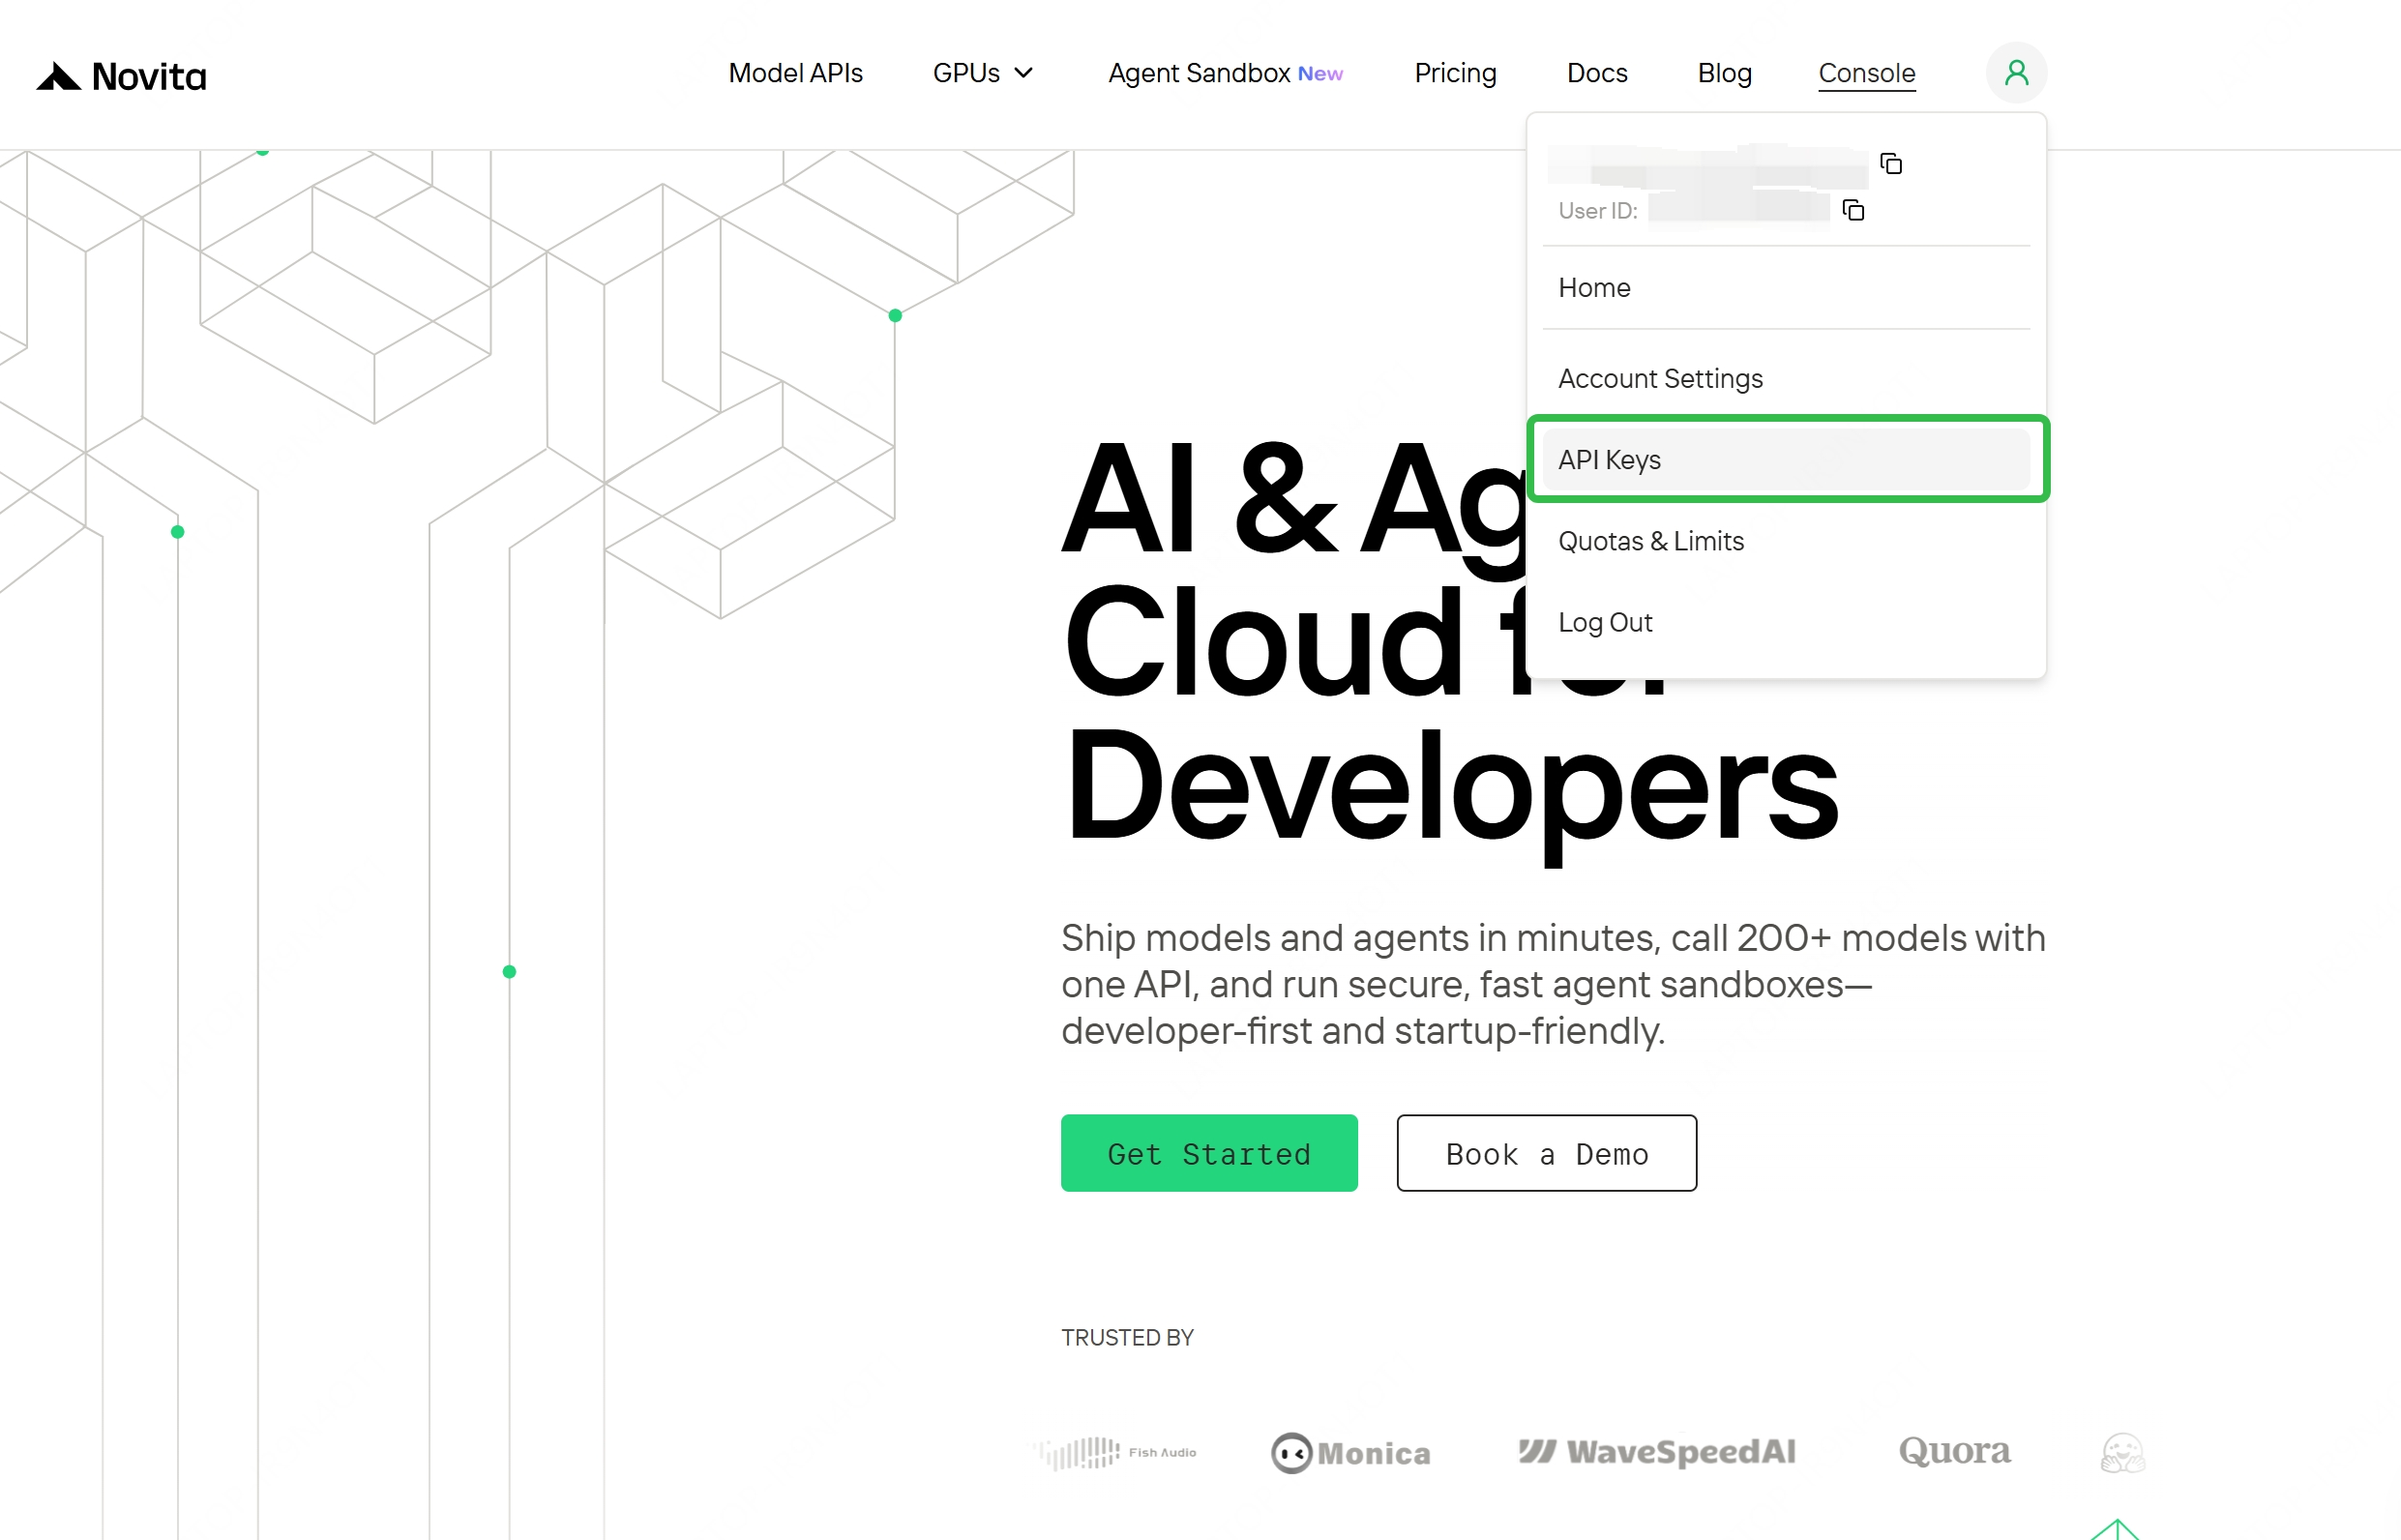
- Passo 2: Navegue até o Gerenciamento de Chaves
Após fazer login, encontre “API Keys”
- Passo 3: Crie uma Nova Chave
Clique no botão “Add New Key”.
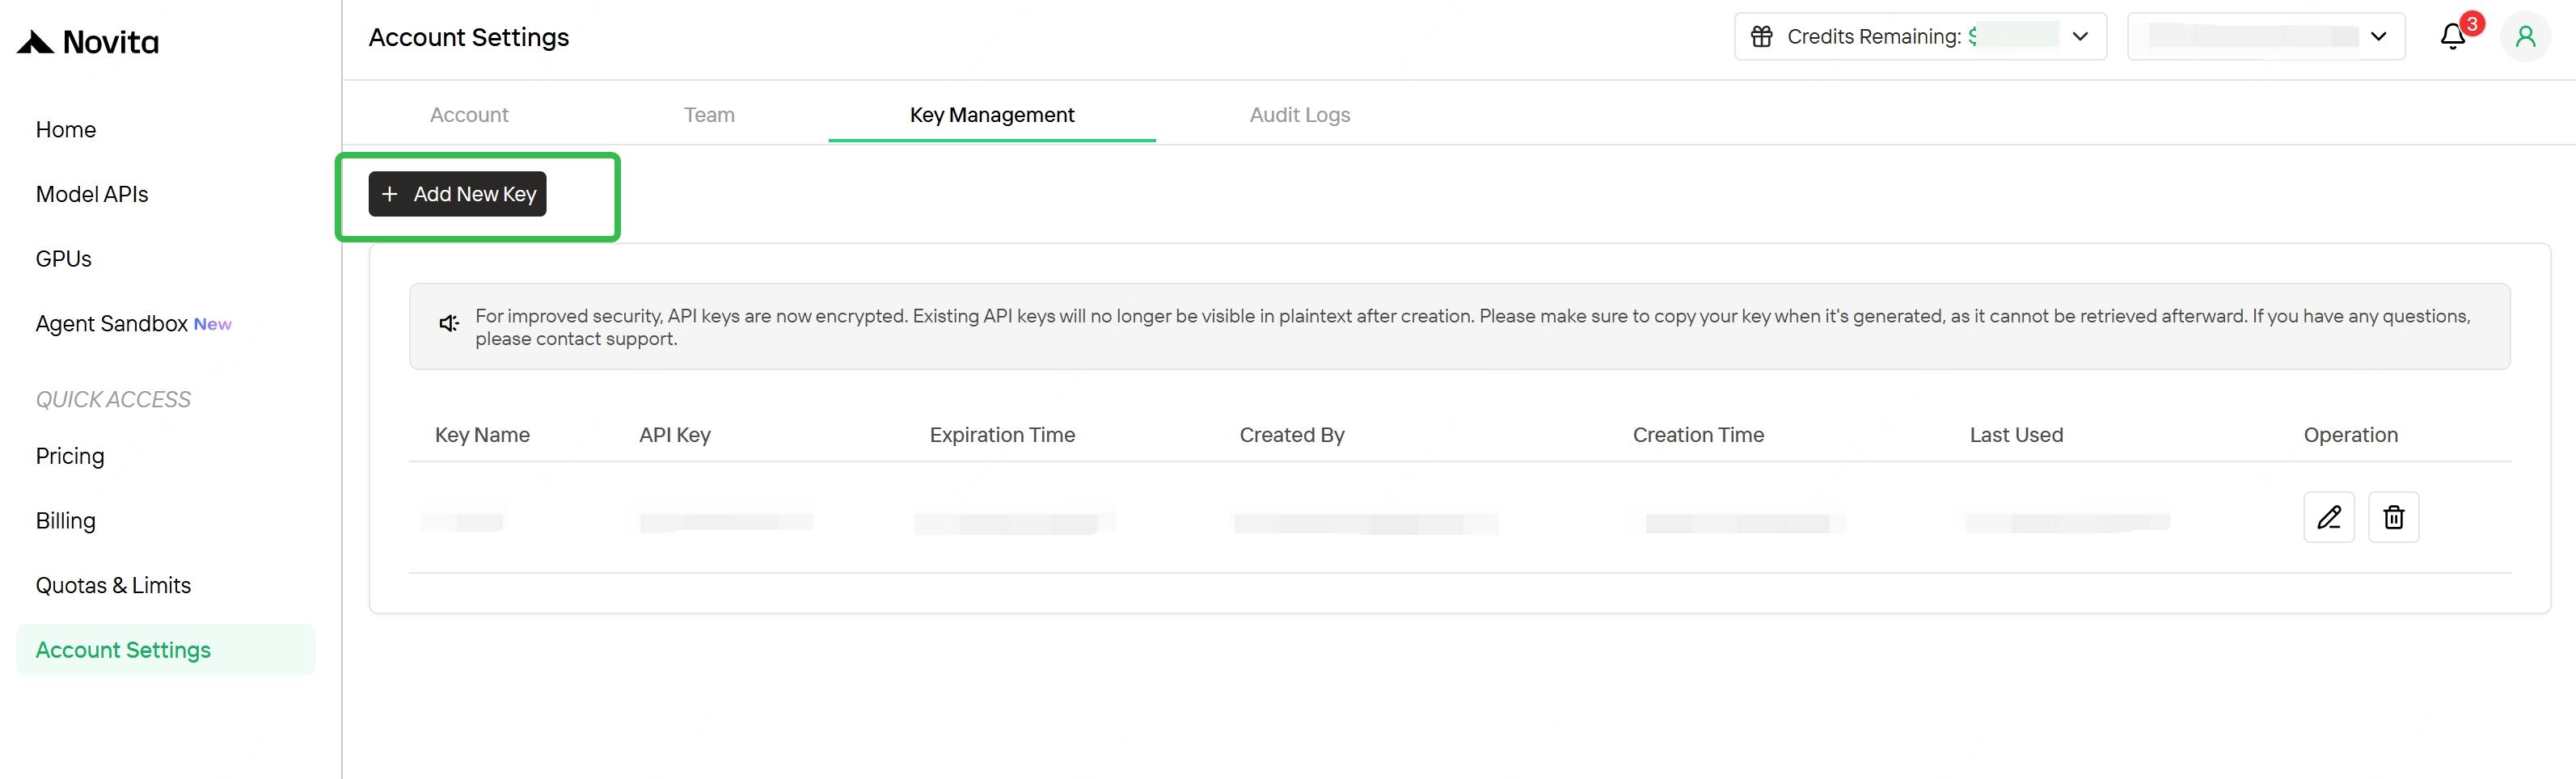
- Passo 4: Salve Sua Chave Imediatamente
Copie e armazene a chave assim que ela for gerada; normalmente ela é exibida apenas uma vez e não pode ser recuperada posteriormente. Mantenha a chave em um local seguro, como um gerenciador de senhas ou notas criptografadas
Uso da API (Python)
Use os seguintes exemplos de código para integrar com nossa API:
from openai import OpenAI

client = OpenAI(
    api_key="<Sua Chave de API>",
    base_url="https://api.novita.ai/openai"
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr-2",
    messages=[
        {"role": "system", "content": "Você é um assistente útil."},
        {"role": "user", "content": "Olá, como você está?"}
    ],
    max_tokens=8192,
    temperature=0.7
)

print(response.choices[0].message.content)
Embora o exemplo acima use Python, a API da Novita funciona da mesma forma em outras linguagens como TypeScript, Java, Go e Shell — apenas a biblioteca do cliente muda.
Conclusão
O DeepSeek OCR2 eleva a inteligência documental ao deslocar a codificação visual da varredura fixa para uma leitura semântica e causalmente informada — especialmente valiosa para layouts complexos como tabelas, PDFs com múltiplas colunas e formulários densos. Com a Novita AI como seu provedor de API OCR2, você obtém integração compatível com OpenAI, onboarding rápido e precificação transparente de $0,03 por 1M de tokens de entrada e $0,03 por 1M de tokens de saída. Se você está construindo fluxos de trabalho de OCR em produção (PDF → Markdown/JSON, extração de faturas, doc-to-RAG), a Novita é um caminho limpo e escalável do protótipo à alta capacidade.
Novita AI é uma plataforma de nuvem de IA que oferece aos desenvolvedores uma maneira fácil de implantar modelos de IA usando nossa API simples, além de fornecer GPU na nuvem acessível e confiável para construir e escalar.
Perguntas Frequentes
O DeepSeek suporta OCR?
Sim. O DeepSeek fornece capacidades de OCR através do DeepSeek OCR2, seu modelo de OCR de segunda geração projetado para reconhecimento de texto em documentos e imagens com forte compreensão de layout.
O DeepSeek OCR é gratuito?
O DeepSeek OCR2 é código aberto no nível do modelo, mas o uso da API não é gratuito.
Ao usar a Novita AI, você obtém precificação justa, transparente e pré-paga, sem sobrecarga de infraestrutura — tornando-o muito mais prático e econômico do que auto-hospedar para uso em produção.
Como acessar o DeepSeek OCR?
Você pode acessar o DeepSeek OCR2 auto-hospedando o modelo de código aberto ou usando um provedor de API na nuvem como a Novita AI, que oferece acesso instantâneo à API, um playground e integração compatível com SDK.
Há diferença entre a API DeepSeek OCR e a API DeepSeek OCR2?
Sim. deepseek/deepseek-ocr (Gen 1) e deepseek/deepseek-ocr-2 são dois IDs de modelo separados no catálogo da Novita, e apenas a Gen 2 é a versão atual e ativamente suportada. Se sua integração ainda aponta para o ID do modelo Gen 1, mude para deepseek/deepseek-ocr-2 — as etapas de configuração acima são idênticas, exceto por essa string.