Vous cherchez une API DeepSeek OCR ? DeepSeek a livré deux générations : l’original DeepSeek-OCR et son successeur, DeepSeek OCR2. Novita AI héberge la génération actuelle, deepseek/deepseek-ocr-2, en tant que point de terminaison compatible OpenAI. Ce guide explique comment l’appeler, combien cela coûte et comment distinguer les deux générations avant d’écrire du code.
L’OCR n’est plus seulement « l’extraction de texte ». Les équipes modernes ont besoin d’intelligence documentaire : ordre de lecture, mise en page, tableaux et sorties structurées à grande échelle, sans les prix des OCR d’entreprise. DeepSeek OCR2 pousse cette tendance plus loin avec un nouveau paradigme d’encodage visuel, et Novita AI rend son déploiement en production pratique grâce à une API et une tarification transparente par tokens.
Essayez DeepSeek OCR 2 maintenant
Gen 1 vs Gen 2 : Si vous avez déjà du code appelant
model="deepseek/deepseek-ocr"(Gen 1), consultez l’article DeepSeek-OCR sur Novita AI avant de déployer de nouveaux travaux. Le catalogue de modèles en direct de Novita liste cet ID de modèle avec un statut hérité, à côté d’autres modèles de génération retirés. Les nouvelles intégrations doivent donc ciblerdeepseek/deepseek-ocr-2ci-dessous.
Qu’est-ce que DeepSeek OCR2
Introduction de base
DeepSeek-OCR 2 est un modèle de reconnaissance documentaire multimodale de DeepSeek AI, présenté comme une mise à niveau de DeepSeek-OCR (Gen 1). Son changement clé est DeepEncoder V2, qui fait passer le traitement visuel d’un « balayage raster » rigide (haut-gauche → bas-droite) à une lecture sémantique et causale — plus proche de la façon dont les humains suivent les structures logiques dans des documents complexes.
Les pipelines OCR traditionnels échouent souvent sur les PDF multi-colonnes, les états financiers denses, les tableaux avec notes de bas de page, et les formulaires dont l’ordre de lecture est délicat. OCR2 est conçu pour comprendre la page, pas seulement « reconnaître les caractères ».
| Fonctionnalité | DeepSeek OCR2 |
| Organisation | DeepSeek AI |
| Type de modèle | Reconnaissance documentaire multimodale (OCR + compréhension de la mise en page) |
| Innovation clé | DeepEncoder V2 réorganise les tokens visuels en fonction de la sémantique de l’image (« balayage fixe » → « raisonnement sémantique ») |
| Fenêtre de contexte / Sortie max | 8 192 / 8 192 |
| Entrée / Sortie | Entrée : texte, image / Sortie : texte |
| Quantification | bf16 |
| Licence | Apache-2.0 |
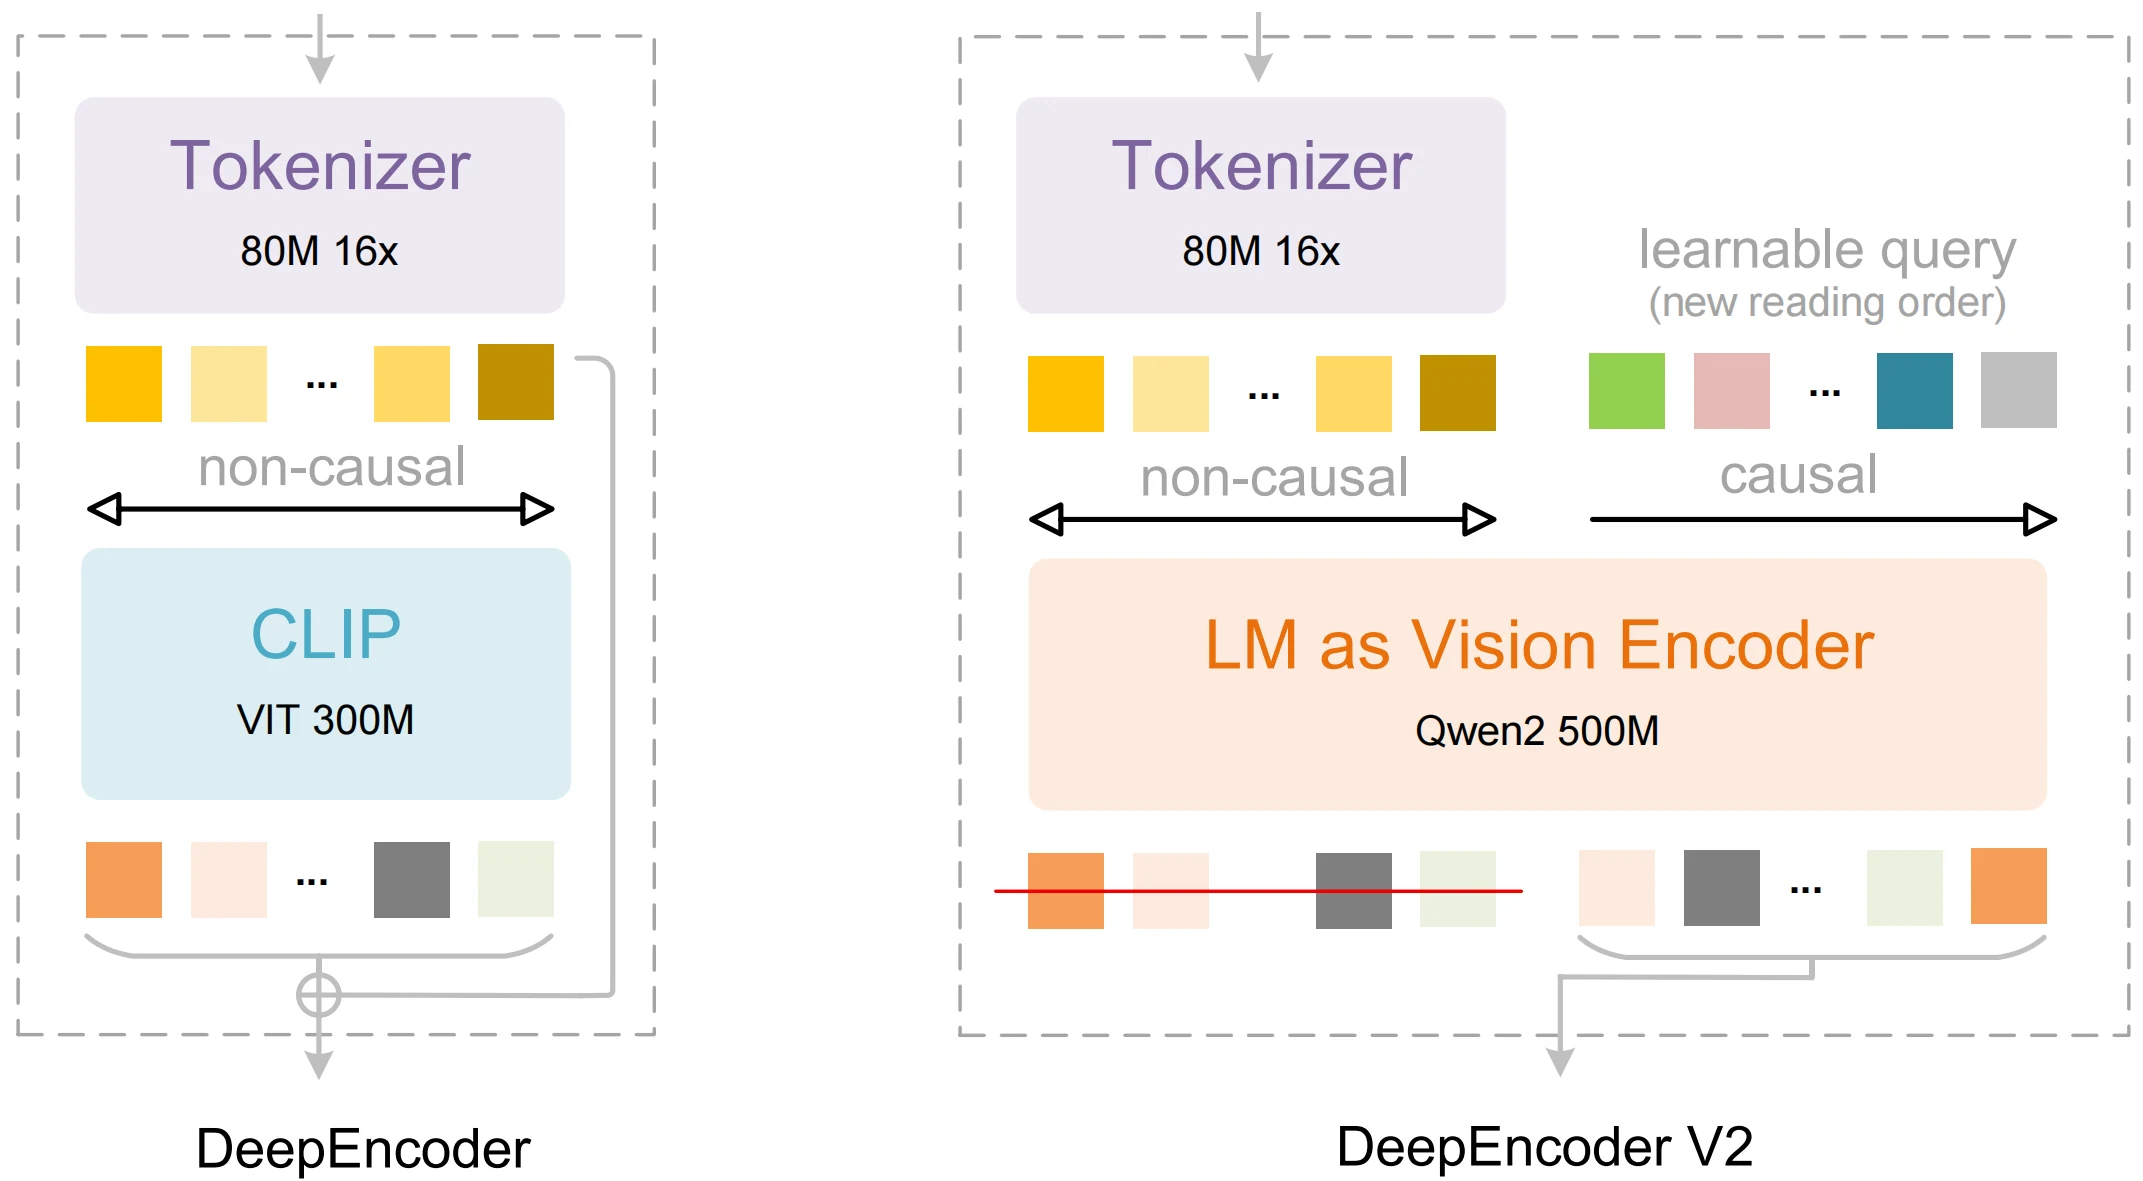
DeepSeek-OCR 2 : Flux causal visuel
🔍 En résumé :
- Côté encodeur : DeepEncoder V2 peut réorganiser les tokens visuels en fonction de la sémantique de l’image avant l’étape de décodage de type LLM.
- Conception du système : OCR2 est décrit comme conservant le décodeur DeepSeek-3B-MoE, tout en remplaçant l’encodeur CLIP original par un composant LLM léger (Qwen2-0.5B).
- Efficacité des tokens : OCR2 cible la couverture documentaire en utilisant un budget de tokens visuels contraint (signalé dans la plage 256–1120 selon la complexité).
Performances sur les benchmarks
Les améliorations d’OCR2 sont surtout visibles sur les benchmarks centrés sur les documents :
- Sur OmniDocBench v1.5, DeepSeek-OCR 2 atteint 91,09 % au global, soit un gain de +3,73 % par rapport à son prédécesseur, et réduit la distance d’édition d’ordre de lecture de 0,085 → 0,057.
- OmniDocBench est conçu pour évaluer l’analyse de PDF réels sur divers types de documents, mises en page et langues.
Si vous construisez des workflows documentaires (ingestion de factures, traitement de réclamations, PDF de conformité, RAG sur manuels), ces métriques sont plus importantes que la « précision OCR » générique, car elles mesurent la compréhension de la structure et de la mise en page, pas seulement la reconnaissance au niveau des caractères.
Comment évaluer les fournisseurs d’API IA : les 5 indicateurs clés
Choisir un modèle n’est que la moitié de la décision — le fournisseur détermine si vous pouvez passer à l’échelle de manière fiable.
| Indicateur | Focus principal | Impact métier | Contexte Novita AI / DeepSeek-OCR2 |
| Longueur du contexte | Limite de tokens | Moins de fragments → moins d’appels → pipelines plus simples | La fenêtre de 8 192 tokens aide à traiter plusieurs pages en une seule passe |
| Coût par token | Tarification API | Impact direct sur le ROI pour l’extraction à grande échelle | Tarification optimisée pour les charges de travail OCR volumineuses (détails ci-dessous) |
| Latence (TTFT/TPOT) | Vitesse de réponse | Améliore les expériences OCR utilisateur | Faible latence pour des aperçus rapides et des applications réactives |
| Débit | Requêtes par seconde / concurrence | Permet le traitement par lots et la gestion des pics de trafic | Capacité de concurrence élevée pour les tâches par lots et simultanées |
| Intégration | Compatibilité | Livrer plus vite en réutilisant les outils existants | Fonctionne avec les outils compatibles OpenAI ; prend également en charge l’intégration de type Anthropic |
Pourquoi choisir Novita AI ?
Remarque : En plus des API compatibles OpenAI, Novita AI propose également des interfaces compatibles Anthropic, permettant aux équipes de réutiliser les outils et prompts existants de style Claude avec des modifications minimes.
Efficacité du développement
Une intégration plus rapide = un délai de rentabilisation plus court. Novita propose une interface compatible OpenAI, donc la plupart des équipes peuvent intégrer OCR2 en ne modifiant que :
- base_url :
https://api.novita.ai/openai - api_key :
<Votre Clé API> - nom du modèle :
deepseek/deepseek-ocr-2
Avantage de coût
Novita présente OCR2 avec une tarification extrêmement simple : le même tarif bas pour les tokens d’entrée et de sortie, ce qui simplifie les prévisions pour les charges de travail OCR lourdes.
Et comme Novita utilise des points de terminaison serverless, vous évitez généralement la charge opérationnelle de :
- provisionner des GPU,
- mettre à l’échelle automatique les serveurs d’inférence,
- maintenir les piles CUDA + inférence.
Prix de l’API DeepSeek OCR2
Dans le catalogue de modèles de Novita, deepseek/deepseek-ocr-2 est listé (vérifié le 2026-08-24, les prix sont mis à jour en continu) :
- Entrée : 0,03 $ / 1M de tokens
- Sortie : 0,03 $ / 1M de tokens
- Fenêtre de contexte : 8 192 tokens
En savoir plus sur la tarification
Accès à l’API DeepSeek OCR2
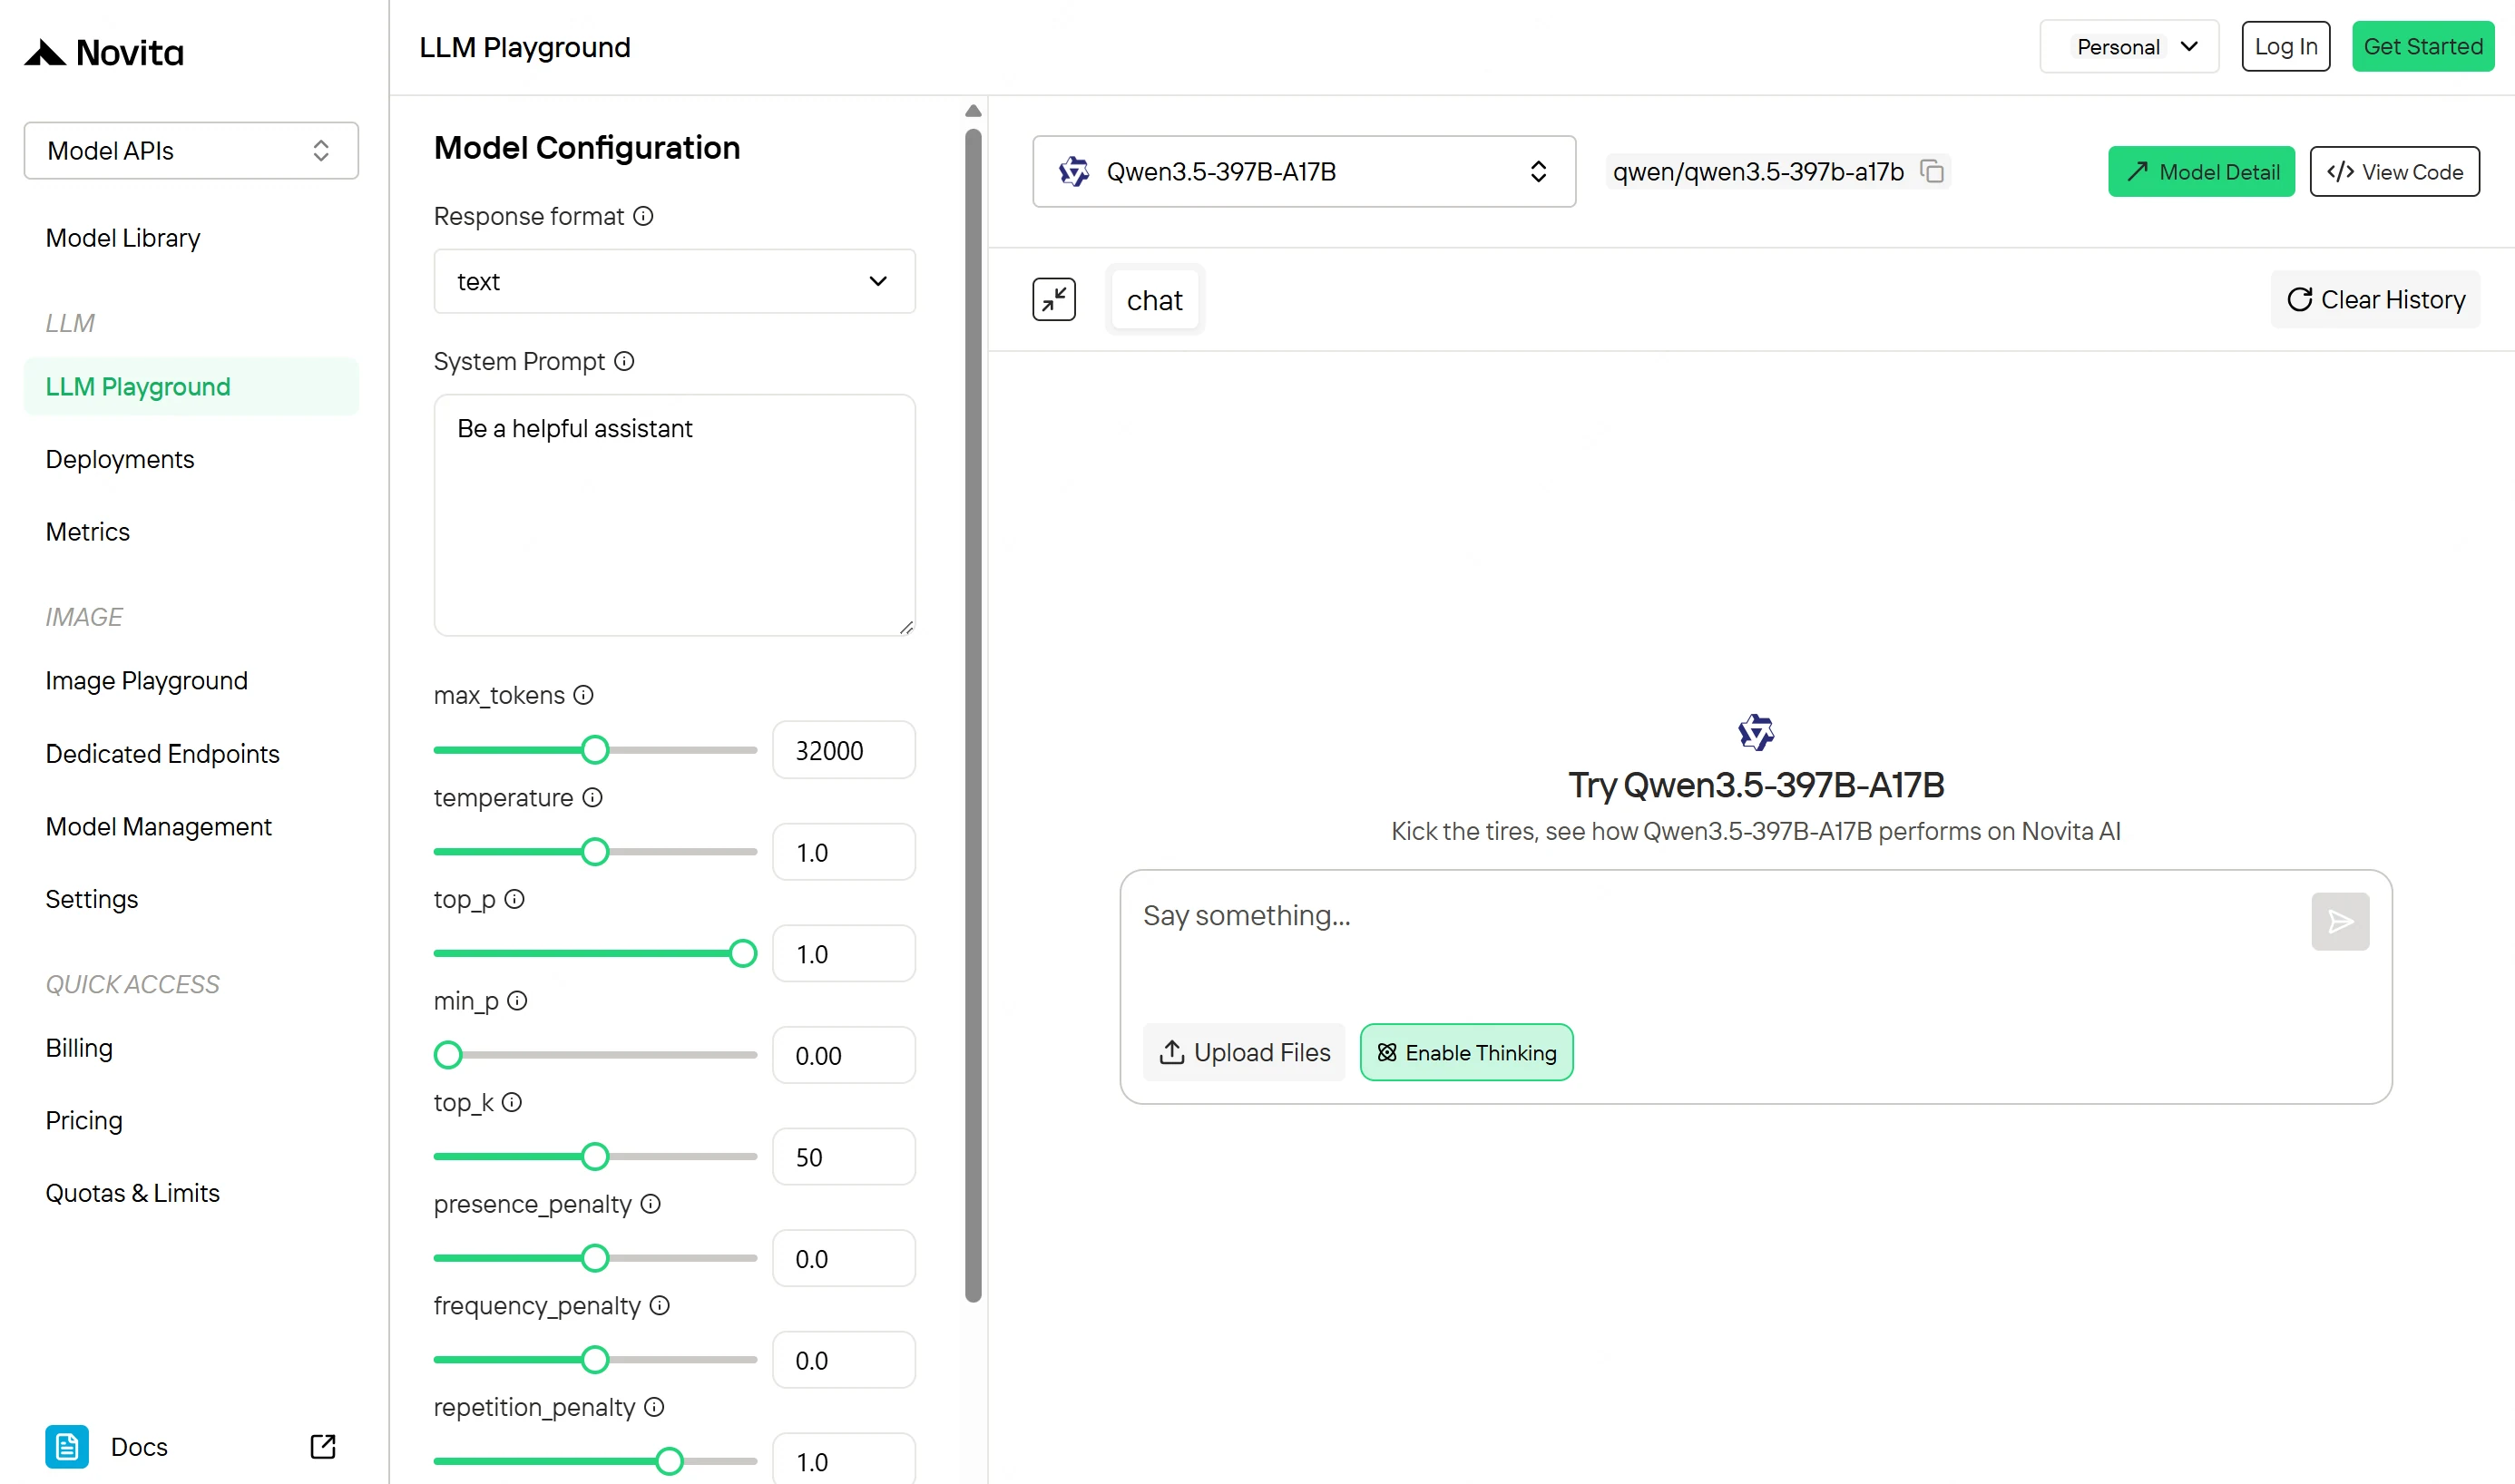
Démarrage rapide : Essayez DeepSeek OCR2 instantanément dans Novita Playground
Le moyen le plus rapide de valider OCR2 pour vos documents est d’exécuter quelques échantillons réels dans le Novita Playground — aucune configuration requise.
⚠ Remarque : Pour des sorties déterministes et stables, veuillez définir
temperatureettop_kà0. Cela désactive l’aléatoire et garantit que le modèle produit des résultats cohérents entre les exécutions.
Obtenir une clé API
- Étape 1 : Créez ou connectez-vous à votre compte
Rendez-vous sur novita.ai et inscrivez-vous ou connectez-vous à votre compte existant.
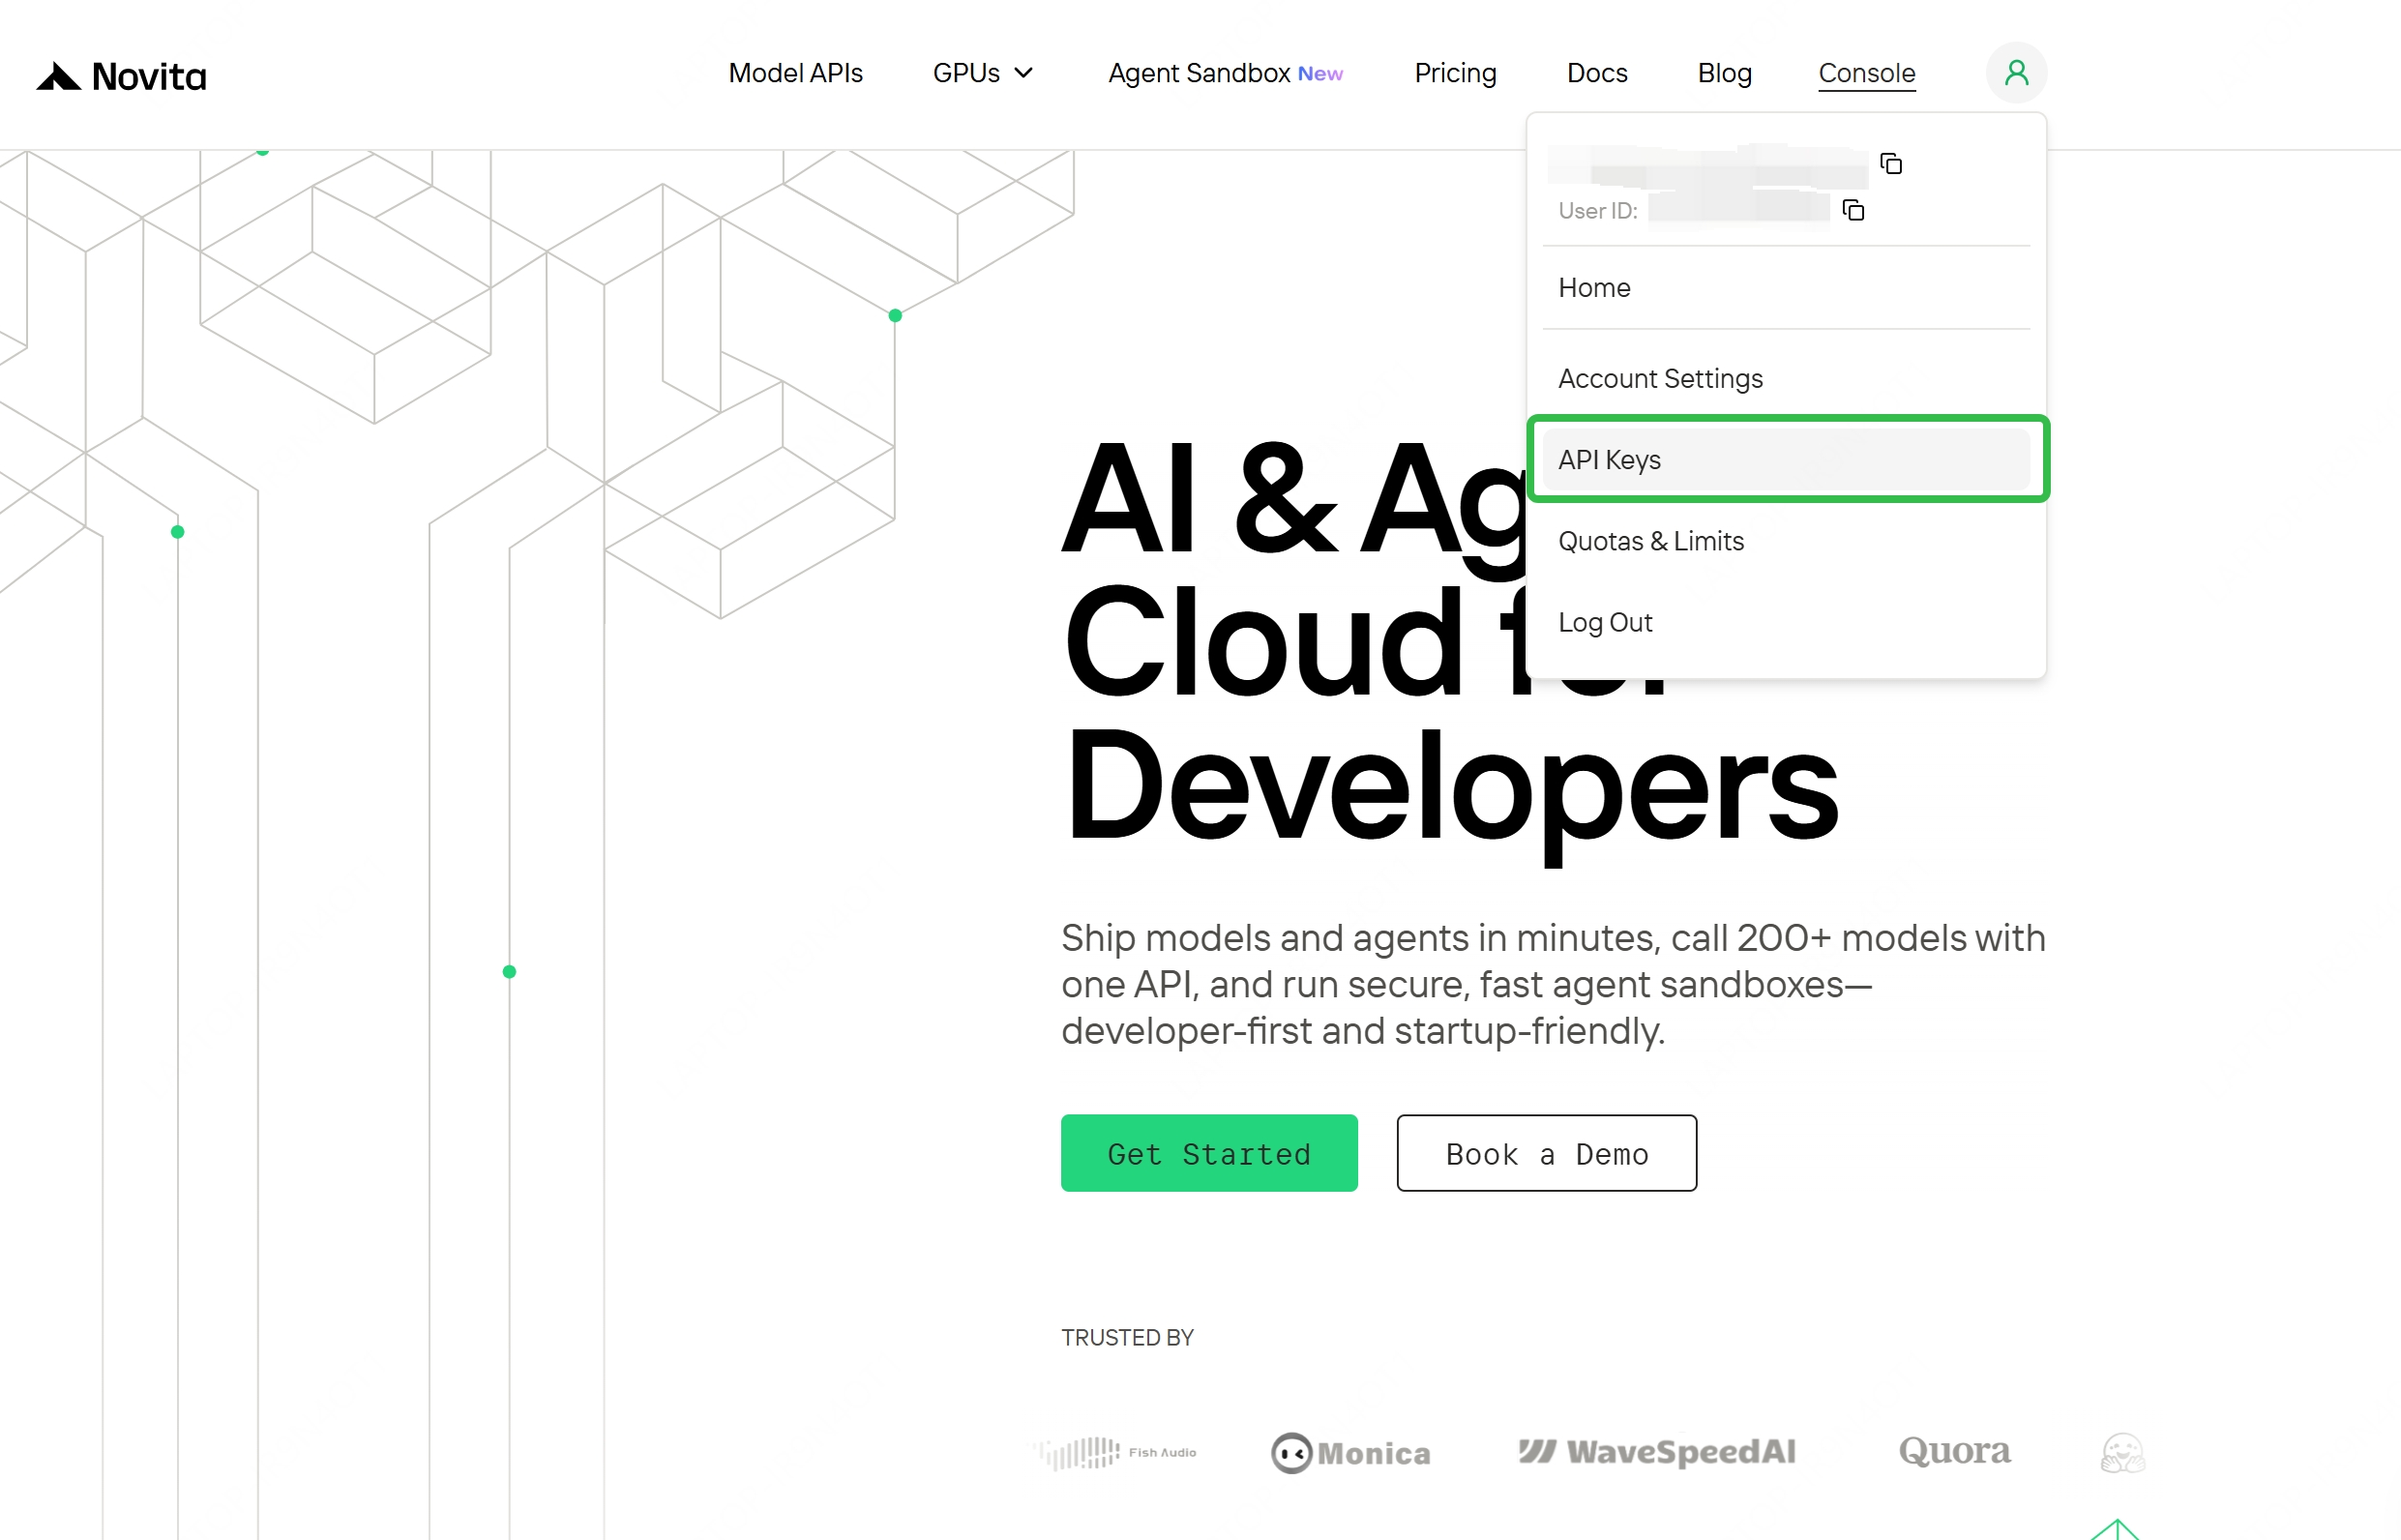
- Étape 2 : Accédez à la gestion des clés
Après connexion, trouvez « API Keys ».
- Étape 3 : Créez une nouvelle clé
Cliquez sur le bouton « Add New Key ».
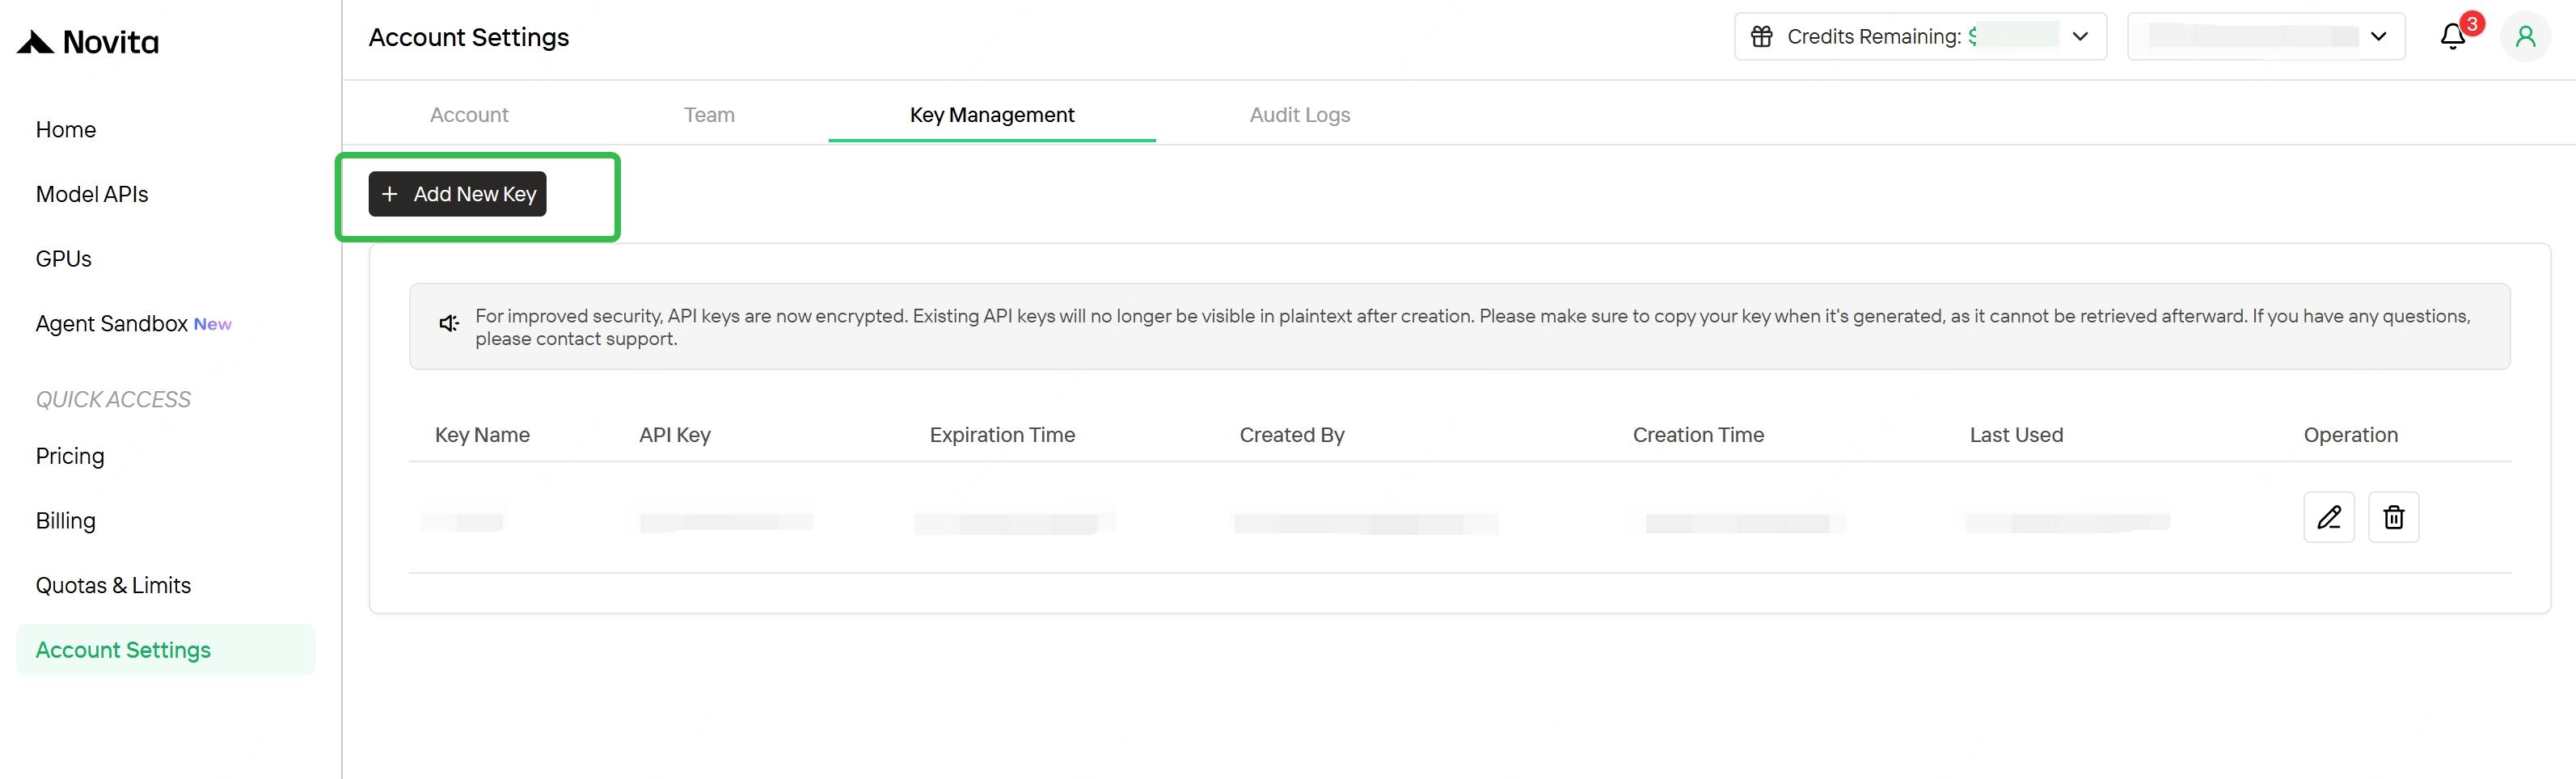
- Étape 4 : Sauvegardez immédiatement votre clé
Copiez et stockez la clé dès qu’elle est générée ; elle n’est généralement affichée qu’une seule fois et ne peut pas être récupérée ultérieurement. Conservez la clé dans un endroit sécurisé comme un gestionnaire de mots de passe ou des notes cryptées.
Utilisation de l’API (Python)
Utilisez les exemples de code suivants pour intégrer notre API :
from openai import OpenAI

client = OpenAI(
    api_key="<Votre Clé API>",
    base_url="https://api.novita.ai/openai"
)

response = client.chat.completions.create(
    model="deepseek/deepseek-ocr-2",
    messages=[
        {"role": "system", "content": "Vous êtes un assistant utile."},
        {"role": "user", "content": "Bonjour, comment allez-vous ?"}
    ],
    max_tokens=8192,
    temperature=0.7
)

print(response.choices[0].message.content)
Bien que l’exemple ci-dessus utilise Python, l’API de Novita fonctionne de la même manière dans d’autres langages comme TypeScript, Java, Go et Shell — seule la bibliothèque client change.
Conclusion
DeepSeek OCR2 améliore l’intelligence documentaire en faisant passer l’encodage visuel d’un balayage fixe à une lecture sémantique et causale — particulièrement précieux pour les mises en page complexes comme les tableaux, les PDF multi-colonnes et les formulaires denses. Avec Novita AI comme fournisseur d’API OCR2, vous bénéficiez d’une intégration compatible OpenAI, d’une mise en route rapide et d’une tarification transparente à 0,03 $ par million de tokens d’entrée et 0,03 $ par million de tokens de sortie. Si vous construisez des workflows OCR de production (PDF vers Markdown/JSON, extraction de factures, doc vers RAG), Novita est un chemin propre et évolutif du prototype au passage à l’échelle.
Novita AI est une plateforme cloud d’IA qui offre aux développeurs un moyen simple de déployer des modèles d’IA via notre API tout en fournissant un cloud GPU abordable et fiable pour construire et passer à l’échelle.
Foire aux questions
DeepSeek prend-il en charge l’OCR ?
Oui. DeepSeek fournit des capacités OCR via DeepSeek OCR2, son modèle OCR de deuxième génération conçu pour la reconnaissance de texte dans les documents et images avec une forte compréhension de la mise en page.
L’OCR de DeepSeek est-il gratuit ?
DeepSeek OCR2 est open source au niveau du modèle, mais l’utilisation de l’API n’est pas gratuite.
En utilisant Novita AI, vous bénéficiez d’une tarification à l’utilisation rentable, transparente sans frais d’infrastructure — ce qui le rend bien plus pratique et économique que l’auto-hébergement pour une utilisation en production.
Comment accéder à l’OCR de DeepSeek ?
Vous pouvez accéder à DeepSeek OCR2 soit en auto-hébergeant le modèle open source, soit en utilisant un fournisseur d’API cloud comme Novita AI, qui offre un accès API instantané, un playground et une intégration compatible SDK.
Y a-t-il une différence entre l’API DeepSeek OCR et l’API DeepSeek OCR2 ?
Oui. deepseek/deepseek-ocr (Gen 1) et deepseek/deepseek-ocr-2 sont deux ID de modèle distincts dans le catalogue de Novita, et seule la Gen 2 est la version actuelle activement prise en charge. Si votre intégration pointe toujours vers l’ID de modèle Gen 1, basculez vers deepseek/deepseek-ocr-2 — les étapes de configuration ci-dessus sont identiques à part cette chaîne.