Está com dificuldades para analisar documentos em vários idiomas? Precisa extrair texto, tabelas, fórmulas e gráficos de documentos complexos sem investir em infraestrutura cara?
O PaddleOCR-VL em uma instância GPU da Novita AI é a sua solução. Esta solução OCR de última geração oferece análise de documentos de nível empresarial em apenas 5 minutos de configuração — sem configurações complexas, sem investimento em hardware, sem complicações.
Com suporte a 109 idiomas, reconhecimento de elementos complexos incluindo texto manuscrito e documentos históricos, e velocidades de inferência rápidas, o PaddleOCR-VL alcança o que sistemas OCR tradicionais não conseguem: precisão, eficiência e versatilidade em um pacote compacto.
👉 Comece a implantar o PaddleOCR-VL agora com nosso modelo de GPU pré-configurado.
Este guia passo a passo mostra exatamente como implantar o PaddleOCR-VL em uma instância GPU da Novita AI, executar sua primeira inferência de OCR e começar a processar documentos imediatamente. Seja você digitalizando notas fiscais, analisando artigos de pesquisa ou extraindo dados de formulários, terá uma solução pronta para produção funcionando em minutos.
O que é o PaddleOCR-VL?
O PaddleOCR-VL é um modelo de visão e linguagem SOTA (state-of-the-art, ou seja, de última geração) e eficiente em recursos, projetado especificamente para análise de documentos. Ao contrário de sistemas OCR tradicionais que consomem muitos recursos computacionais ou têm dificuldade com layouts complexos, o PaddleOCR-VL oferece precisão excepcional mantendo o consumo mínimo de recursos.
A tecnologia por trás do PaddleOCR-VL
Em sua essência, o PaddleOCR-VL-0.9B combina:
- Codificador visual de resolução dinâmica no estilo NaViT para processamento de imagens preciso
- Modelo de linguagem ERNIE-4.5-0.3B para compreensão inteligente de texto
- Arquitetura compacta (0,9 bilhões de parâmetros) para inferência rápida e eficiente
Essa integração inovadora permite que o modelo reconheça elementos complexos de documentos — texto, tabelas, fórmulas, gráficos — em 109 idiomas, sem a necessidade de hardware GPU caro ou longos tempos de processamento.
Desempenho comprovado
Por meio de avaliações abrangentes em benchmarks públicos amplamente utilizados e testes internos, o PaddleOCR-VL alcança desempenho SOTA tanto na análise de documentos em nível de página quanto no reconhecimento em nível de elementos. O modelo supera significativamente as soluções baseadas em pipeline existentes e apresenta forte competitividade contra os principais modelos de visão e linguagem (VLMs), tornando-se a escolha preferida para ambientes de produção.
Por que escolher o PaddleOCR-VL para análise de documentos?
1. Arquitetura compacta, mas poderosa
Eficiência de recursos encontra alto desempenho. A arquitetura inovadora de visão e linguagem do PaddleOCR-VL é projetada especificamente para inferência eficiente em recursos, ao mesmo tempo que alcança resultados de reconhecimento de elementos excepcionais.
A integração de um codificador visual de alta resolução dinâmica no estilo NaViT com o leve modelo de linguagem ERNIE-4.5-0.3B aumenta significativamente as capacidades de reconhecimento e a eficiência de decodificação. Você obtém alta precisão com demandas computacionais reduzidas — perfeito para aplicações de processamento de documentos práticas e econômicas.
2. Desempenho SOTA em documentos complexos
Precisão de classe mundial onde mais importa. O PaddleOCR-VL alcança desempenho de última geração em:
- Análise de documentos em nível de página: compreensão completa do documento e reconhecimento de estrutura
- Reconhecimento em nível de elementos: extração precisa de componentes individuais
O modelo se destaca no reconhecimento de conteúdo desafiador que causa problemas em sistemas OCR tradicionais:
- ✅ Tabelas complexas com células mescladas e estruturas aninhadas
- ✅ Fórmulas e equações matemáticas
- ✅ Gráficos, diagramas e ilustrações
- ✅ Texto manuscrito com estilos variados
- ✅ Documentos históricos com qualidade degradada
- ✅ Documentos com múltiplos idiomas
Essa versatilidade torna o PaddleOCR-VL adequado para praticamente qualquer tipo de documento ou cenário que você encontrar.
3. Suporte multilíngue extenso (109 idiomas)
Alcance verdadeiramente global. O PaddleOCR-VL oferece suporte a 109 idiomas, abrangendo:
- Idiomas globais principais: chinês, inglês, japonês, coreano, latim
- Alfabetos diversos: russo (cirílico), árabe, hindi (devanágari), tailandês
- Idiomas regionais: e muitos outros
Essa ampla cobertura de idiomas aumenta substancialmente a aplicabilidade do sistema em cenários de processamento de documentos multilíngues e globalizados. Processe documentos de qualquer mercado, qualquer região, qualquer idioma — sem precisar trocar de ferramentas ou modelos.
4. Velocidades de inferência rápidas
Tempo é dinheiro. O PaddleOCR-VL oferece velocidades de inferência rápidas que o tornam altamente adequado para implantação prática em cenários do mundo real. O modelo compacto de 0,9 bilhões de parâmetros processa documentos rapidamente sem sacrificar a precisão, permitindo fluxos de trabalho de processamento de documentos de alto throughput.
Como implantar o PaddleOCR-VL na Novita AI (guia de 5 minutos)
Pronto para implantar o PaddleOCR-VL em uma instância GPU da Novita AI? Siga estes 8 passos simples para colocar seu serviço OCR SOTA funcionando em minutos.
Passo 1: Acesse o modelo do PaddleOCR-VL
Você pode acessar diretamente o Modelo GPU do PaddleOCR-VL .
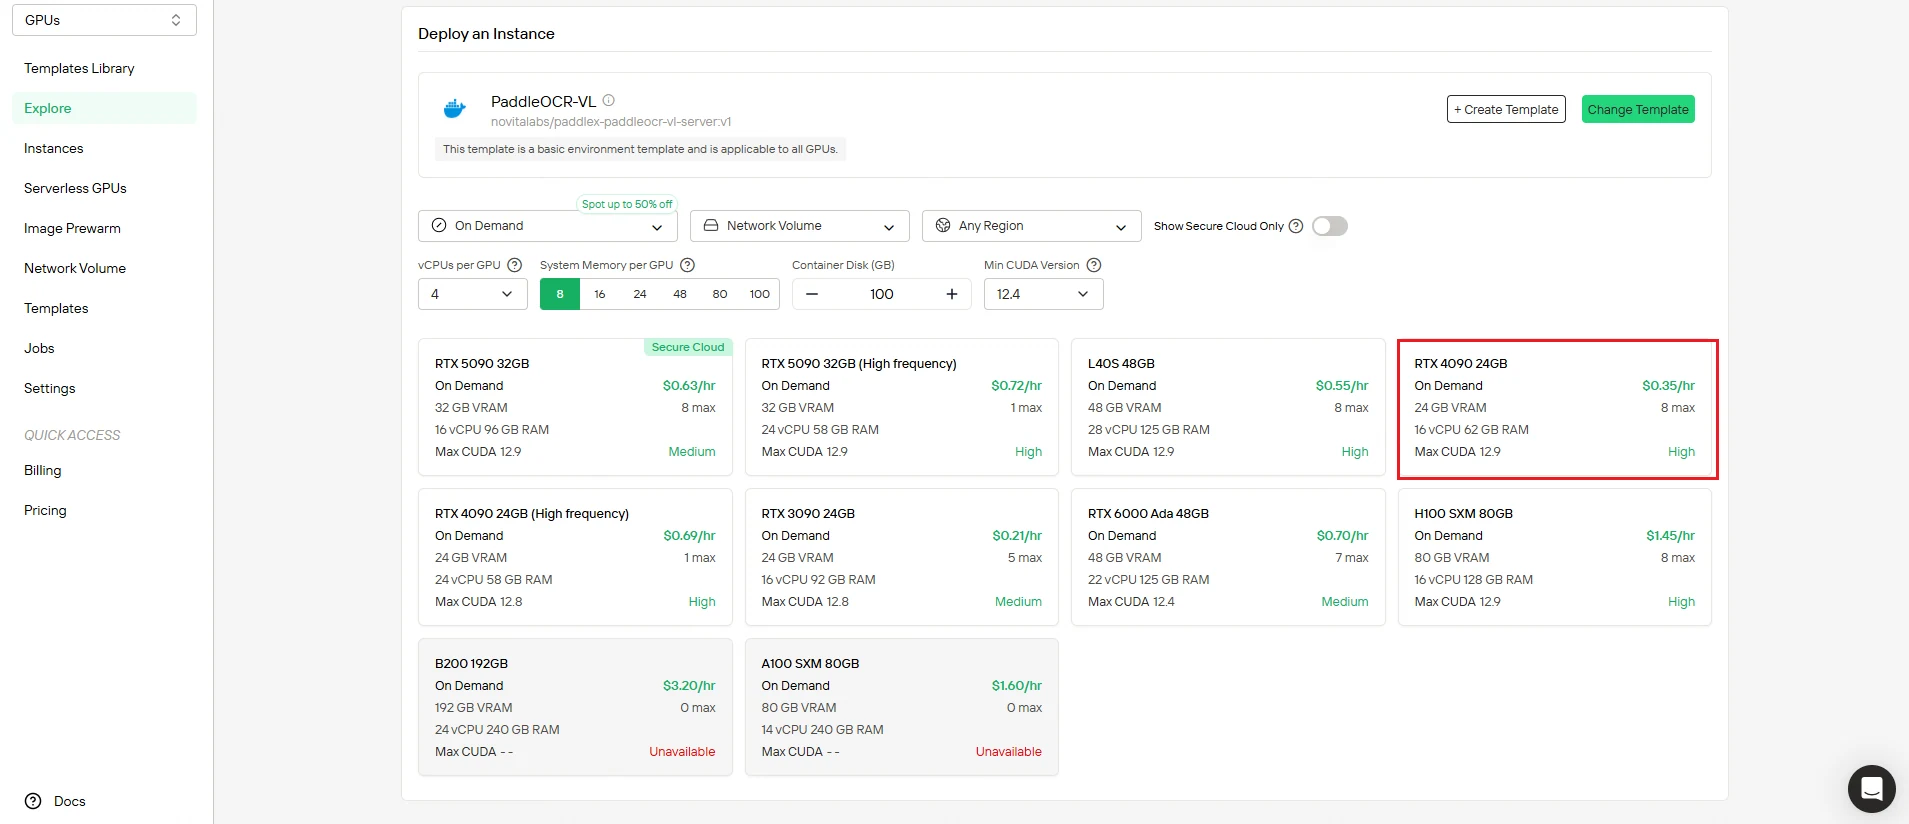
Passo 2: Configure sua instância GPU
Defina os parâmetros de infraestrutura para corresponder aos seus requisitos de processamento:
- Alocação de memória: escolha a capacidade de RAM com base na carga de trabalho
- Requisitos de armazenamento: aloque espaço em disco para arquivos de modelo e processamento
- Configurações de rede: configure a conectividade para acesso à API
Selecione Implantar para implementar sua configuração.
Dica profissional: Comece com as configurações recomendadas para cargas de trabalho típicas de processamento de documentos, depois escale conforme necessário.
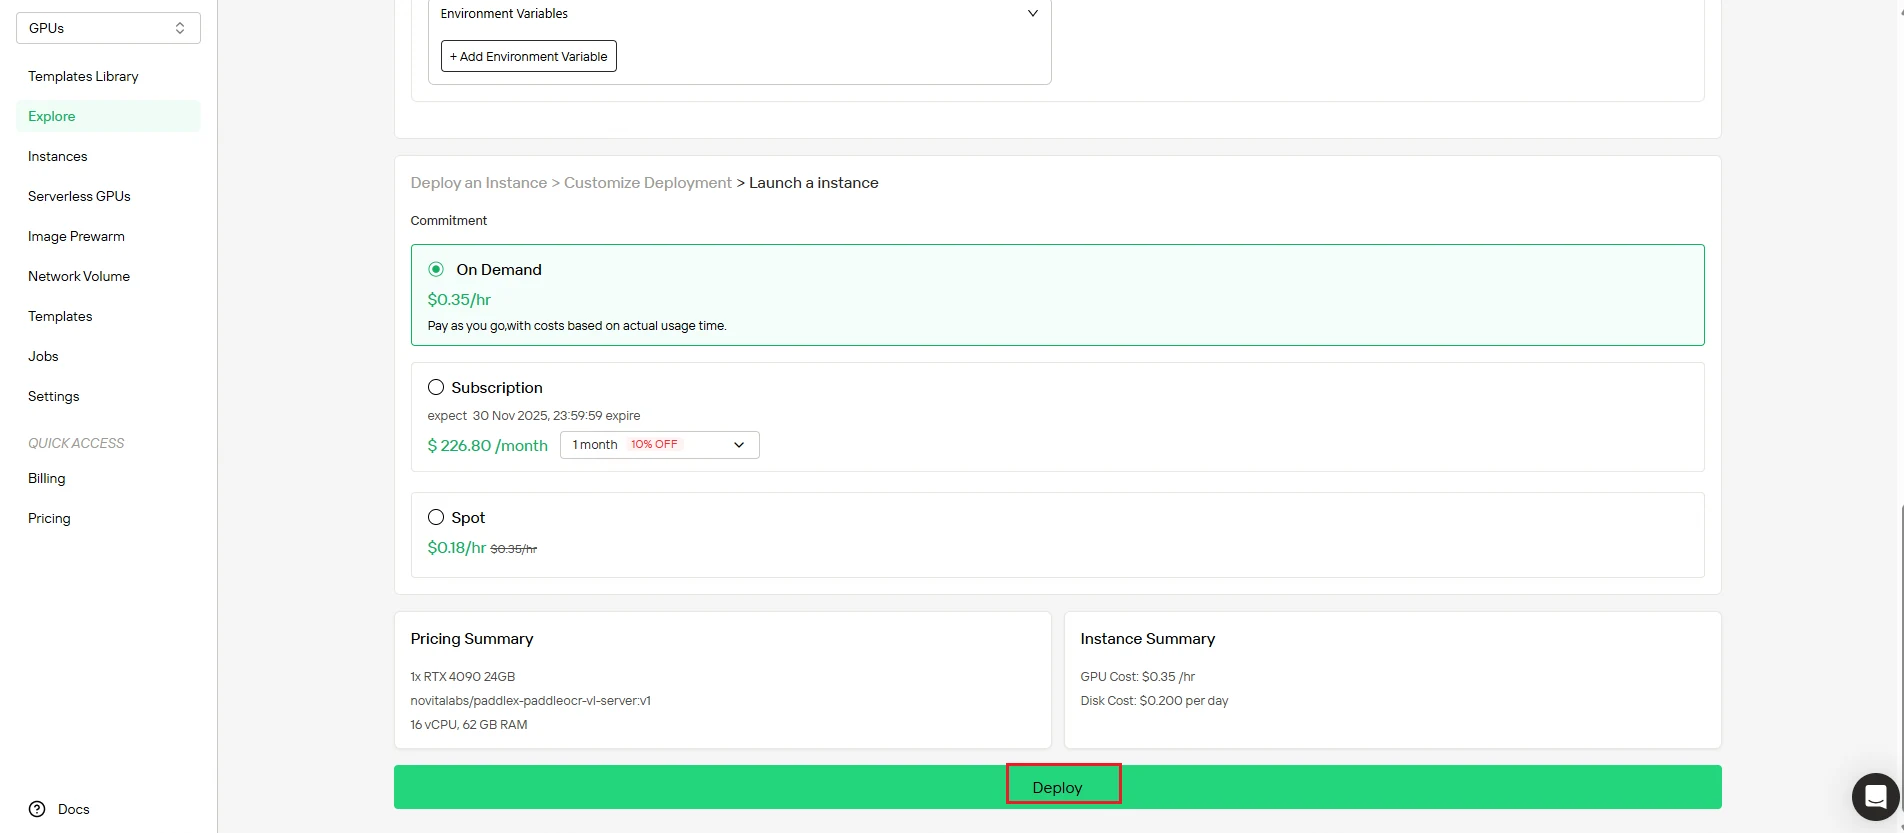
Passo 3: Revise a configuração e implante
Verifique novamente suas configurações antes da implantação:
- Verifique se os recursos de computação correspondem aos seus requisitos
- Revise o resumo de custos para garantir alinhamento com o orçamento
- Confirme as configurações de rede e armazenamento
Quando estiver satisfeito, clique em Implantar para iniciar o processo de criação. A Novita AI lida com toda a complexidade do backend automaticamente.
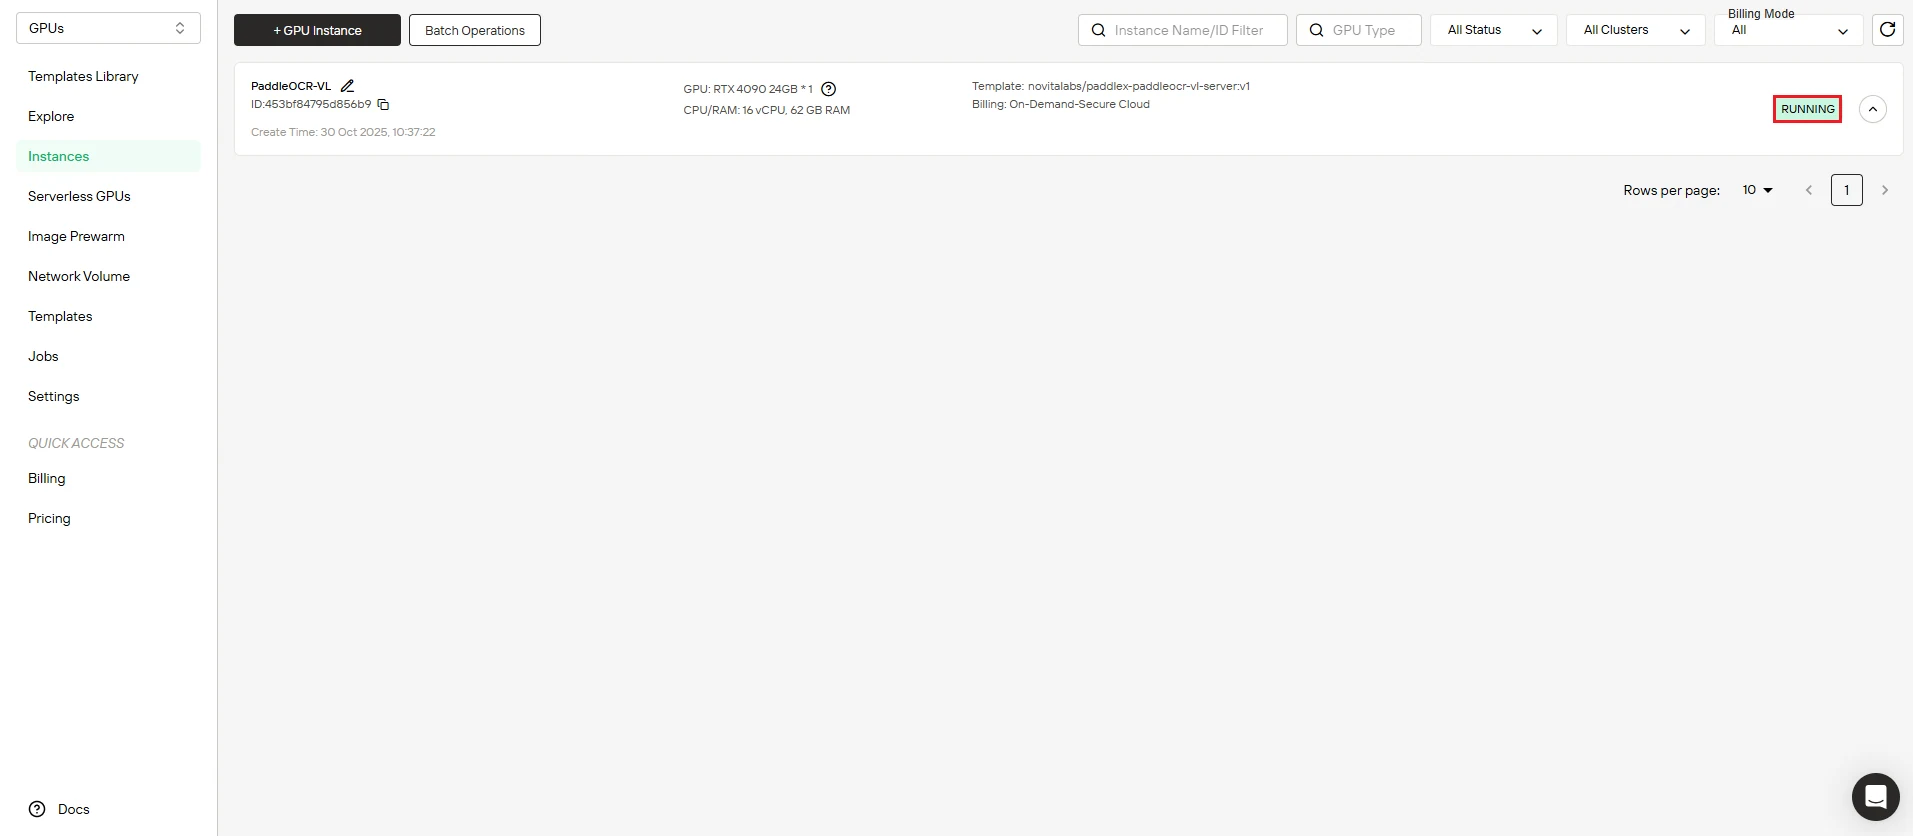
Passo 4: Monitore a criação da instância
Após iniciar a implantação, o sistema redireciona você automaticamente para a página de gerenciamento de instâncias. Sua instância é criada em segundo plano — nenhuma intervenção manual é necessária.
Acompanhe o progresso em tempo real no painel.
Passo 5: Acompanhe o progresso do download da imagem
Acompanhe sua instância ficar online. O painel exibe o progresso em tempo real do download da imagem do PaddleOCR-VL. O status da sua instância muda de “Puxando” para “Executando” assim que a implantação for concluída com sucesso.
Clique no ícone de seta ao lado do nome da sua instância para ver informações detalhadas de progresso e logs de implantação.
Passo 6: Verifique o status do serviço
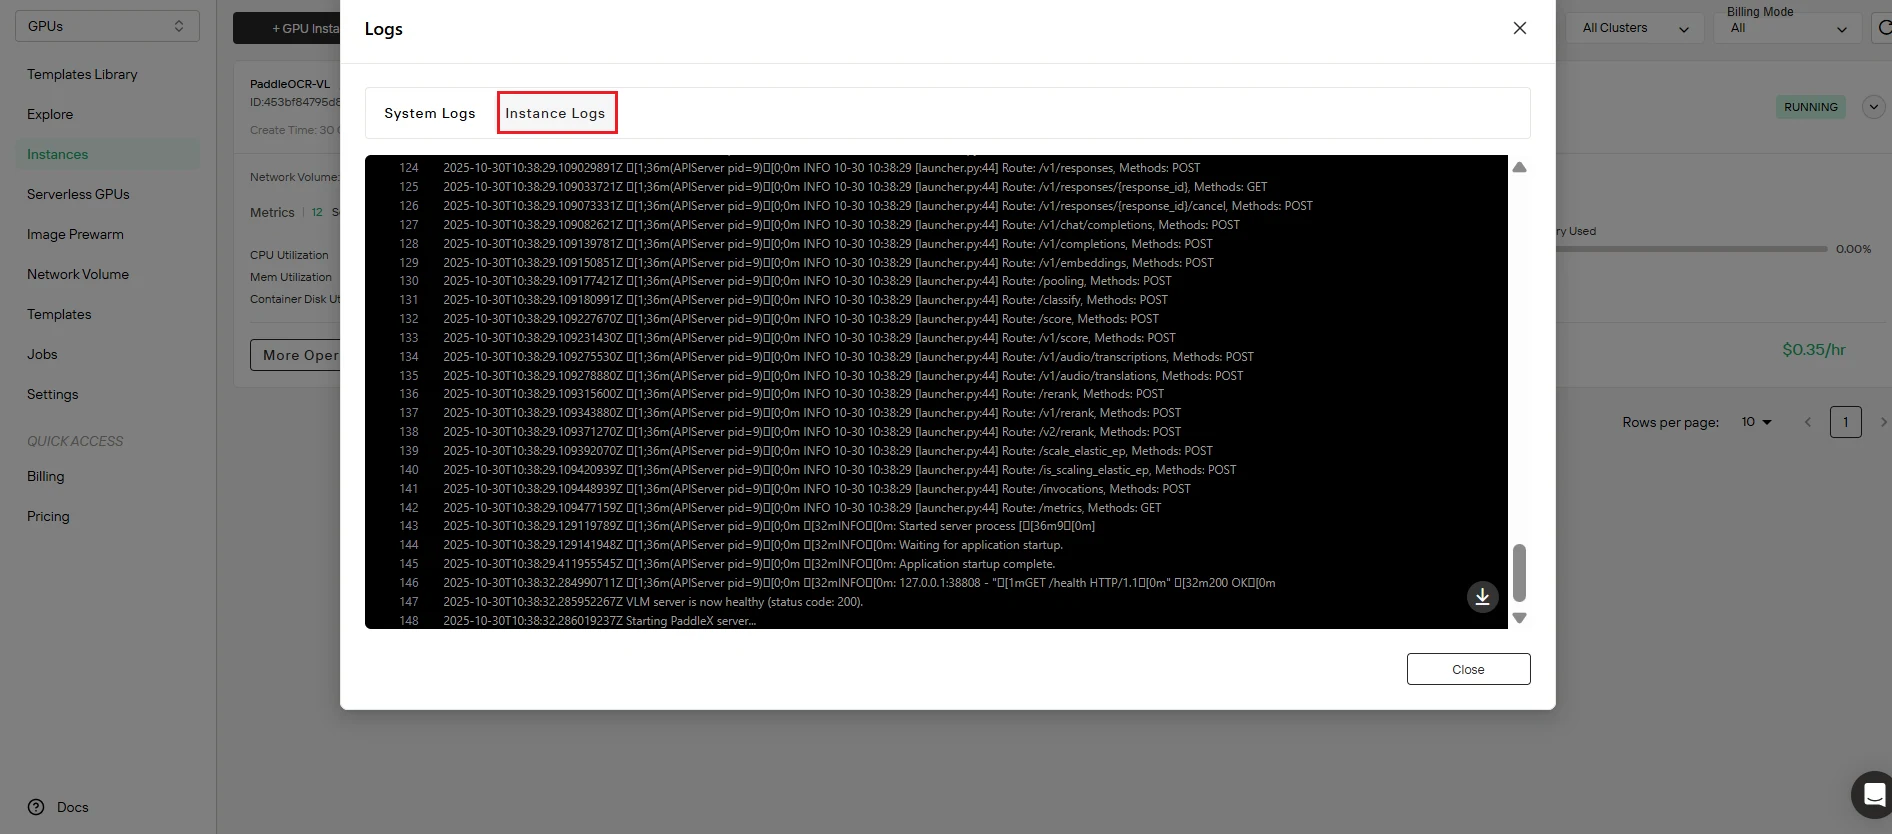
Confirme que a implantação foi bem-sucedida. Clique no botão Logs para acessar os logs da instância e verificar que o serviço PaddleOCR-VL foi iniciado corretamente. Procure por mensagens de inicialização que confirmem:
- Lançamento do serviço concluído
- Endpoint da API ativo e escutando
- Modelo carregado com sucesso
Passo 7: Acesse o ambiente de desenvolvimento
Inicie seu espaço de trabalho. Navegue até a interface Conectar e inicialize o Iniciar Terminal Web para obter acesso por linha de comando à sua instância.
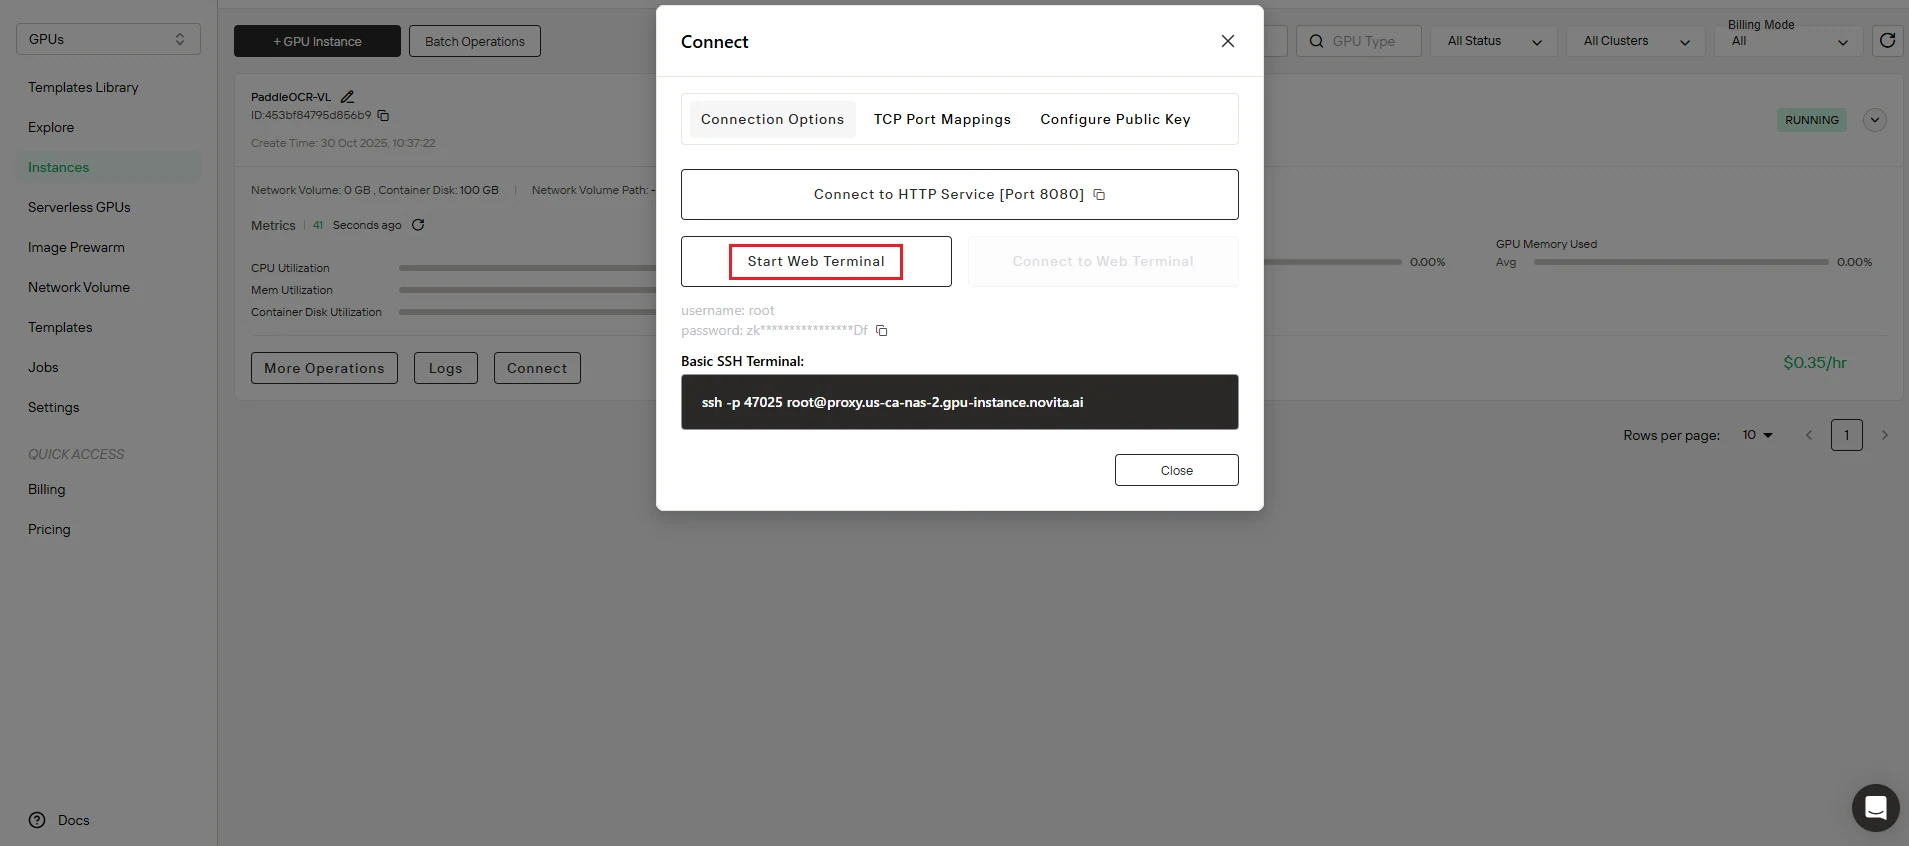
🎉 Parabéns! Seu serviço PaddleOCR-VL agora está totalmente operacional e pronto para processar solicitações de OCR. Tempo total: aproximadamente 5 minutos.
Executando sua primeira inferência de OCR
Agora que sua instância do PaddleOCR-VL está executando na GPU da Novita AI, vamos processar seu primeiro documento. Esta demonstração mostra o fluxo de trabalho completo, desde a preparação da imagem até a extração de resultados.
Passo 1: Crie o script de teste Python
Crie um arquivo chamado test.py com o seguinte código:
import base64
import requests
import pathlib

API_URL = "http://localhost:8080/layout-parsing"  # Service URL

image_path = "./demo.jpg"

# Encode local image to Base64
with open(image_path, "rb") as file:
    image_bytes = file.read()
    image_data = base64.b64encode(image_bytes).decode("ascii")

payload = {
    "file": image_data,  # Base64 encoded file content or file URL
    "fileType": 1,  # File type, 1 means image file
}

# Call the API
response = requests.post(API_URL, json=payload)

# Process the API response data
assert response.status_code == 200
result = response.json()["result"]
for i, res in enumerate(result["layoutParsingResults"]):
    print(res["prunedResult"])
    md_dir = pathlib.Path(f"markdown_{i}")
    md_dir.mkdir(exist_ok=True)
    (md_dir / "doc.md").write_text(res["markdown"]["text"])
    for img_path, img in res["markdown"]["images"].items():
        img_path = md_dir / img_path
        img_path.parent.mkdir(parents=True, exist_ok=True)
        img_path.write_bytes(base64.b64decode(img))
    print(f"Markdown document saved at {md_dir / 'doc.md'}")
    for img_name, img in res["outputImages"].items():
        img_path = f"{img_name}_{i}.jpg"
        pathlib.Path(img_path).parent.mkdir(exist_ok=True)
        with open(img_path, "wb") as f:
            f.write(base64.b64decode(img))
        print(f"Output image saved at {img_path}")
O que este script faz:
- Codifica sua imagem para o formato Base64
- Envia para o endpoint da API do PaddleOCR-VL
- Recebe resultados de análise estruturados
- Salva o conteúdo extraído como documentos markdown
- Exporta imagens incorporadas
Passo 2: Baixe a imagem de teste
Use o caso de teste oficial do PaddleOCR para sua primeira inferência:
bash
curl https://raw.githubusercontent.com/PaddlePaddle/PaddleOCR/main/tests/test_files/book.jpg -o demo.jpg
Isso baixa uma imagem de documento de exemplo (book.jpg) para testar sua configuração de OCR. O arquivo de teste oficial está disponível em: Repositório GitHub do PaddleOCR
Passo 3: Configure o endpoint da API
Atualize seu script com o endpoint correto:
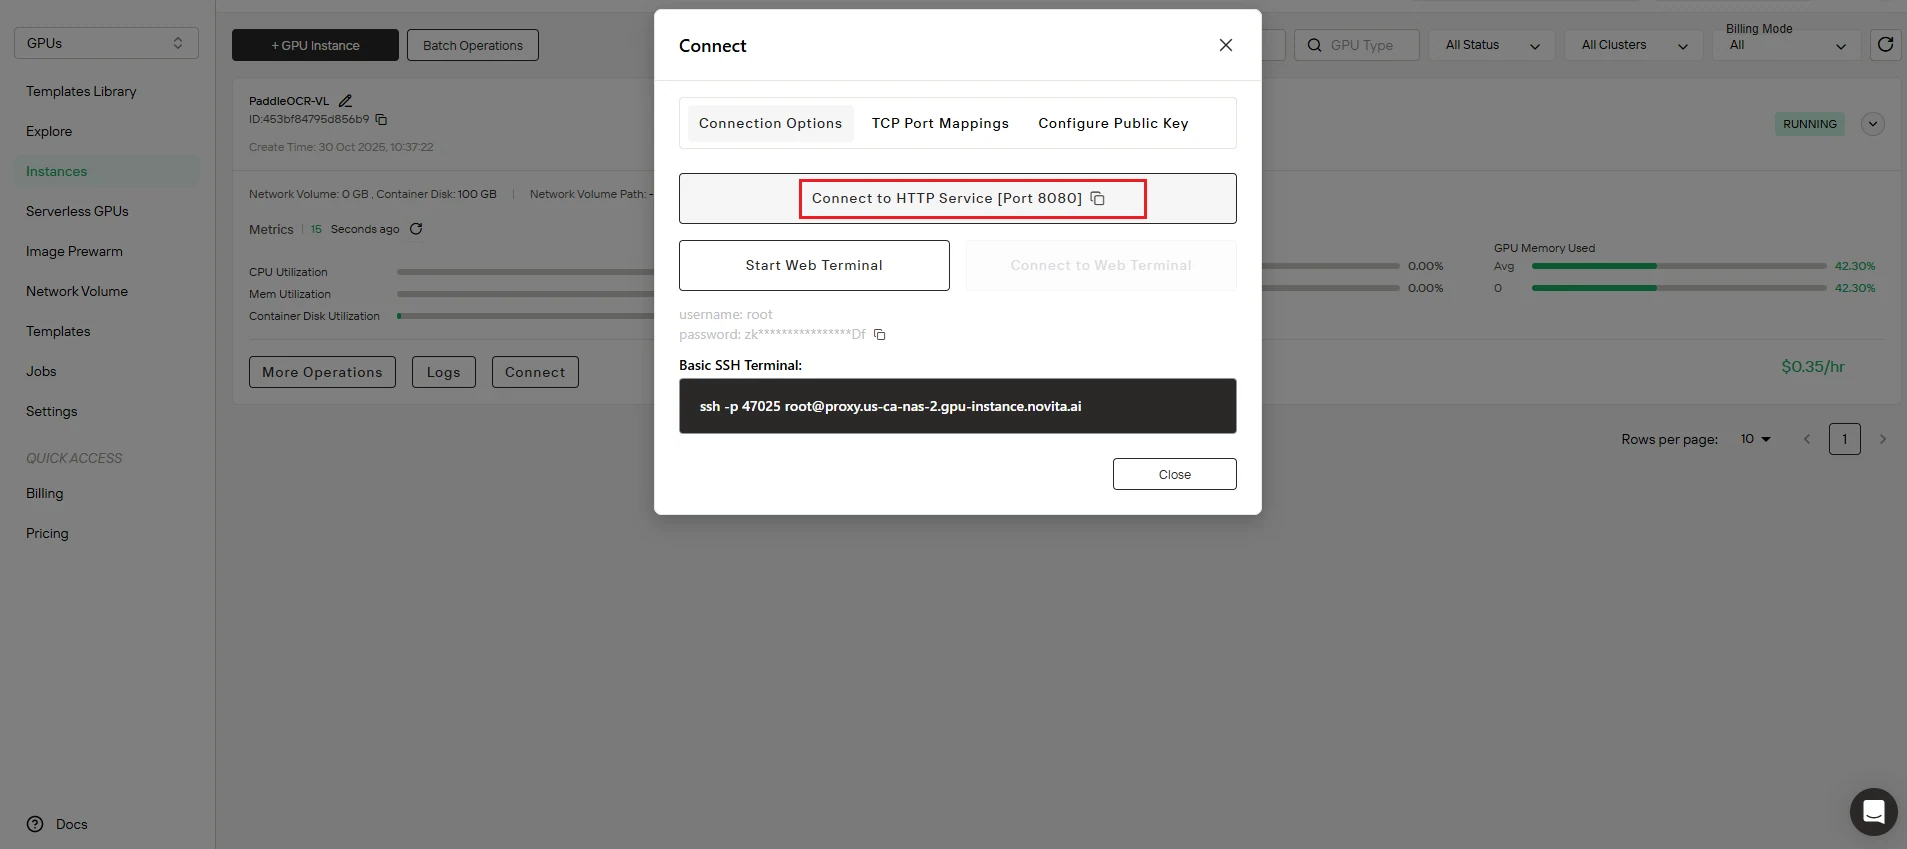
- Copie o endereço de mapeamento de porta do painel da sua instância da Novita AI
- Substitua
http://localhost:8080/layout-parsingnotest.pypelo URL do seu endpoint de API real
Exemplo: Seu endpoint pode ser parecido com http://your-instance-id.novita.ai:8080/layout-parsing
Passo 4: Execute o processamento de OCR
Execute seu script de teste:
bash
python test.py
Saída esperada:
- O console exibe a estrutura de texto extraída
- Documentos markdown salvos em
markdown_0/doc.md - Imagens incorporadas extraídas para arquivos separados
- Mensagens de confirmação mostrando os locais dos arquivos de saída
É isso! Você processou com sucesso seu primeiro documento com o PaddleOCR-VL em uma instância GPU da Novita AI.
Aplicações no mundo real
Implante o PaddleOCR-VL em uma instância GPU da Novita AI para alimentar diversos fluxos de trabalho de processamento de documentos:
Serviços financeiros
- Processamento de notas fiscais: extraia itens de linha, totais, informações de fornecedores
- Digitalização de recibos: automatize relatórios de despesas e reconciliação
- Análise de extratos bancários: converta extratos em dados estruturados
Acadêmico e pesquisa
- Análise de artigos de pesquisa: extraia texto, fórmulas, tabelas de publicações
- Digitalização de livros didáticos: converta materiais educacionais para formatos pesquisáveis
- Preservação de documentos históricos: digitalize arquivos com qualidade de texto degradada
Jurídico e conformidade
- Análise de contratos: extraia cláusulas, termos, assinaturas
- Processamento de documentos regulatórios: analise registros e relatórios de conformidade
- Descoberta jurídica: converta documentos de processos para texto pesquisável
Saúde
- Digitalização de prontuários médicos: converta gráficos de pacientes em dados estruturados
- Processamento de receitas: extraia informações de medicamentos de formulários
- Análise de sinistros de seguro: automatize o processamento de documentos de sinistro
E-commerce e varejo
- Extração de catálogos de produtos: analise fichas técnicas e especificações de fornecedores
- Descrições de produtos multilíngues: processe catálogos internacionais
- Processamento de documentos de inventário: digitalize listas de estoque e manifestos
Serviços públicos
- Processamento de formulários: automatize o manuseio de documentos de atendimento ao cidadão
- Verificação de identidade: extraia informações de documentos de identificação
- Processamento de permissões e licenças: analise documentos de solicitação
O suporte a 109 idiomas e o reconhecimento de elementos complexos tornam o PaddleOCR-VL ideal para organizações globais que lidam com tipos de documentos diversos.
Conclusão
Implante o PaddleOCR-VL em uma instância GPU da Novita AI em 5 minutos e desbloqueie recursos de análise de documentos de última geração sem complexidade de infraestrutura. Com desempenho SOTA, suporte a 109 idiomas e uso eficiente de recursos, você obtém um OCR de nível empresarial que é ao mesmo tempo poderoso e prático.
Principais conclusões:
✅ Implantação de 5 minutos com modelos pré-configurados
✅ Precisão SOTA para texto, tabelas, fórmulas e gráficos
✅ 109 idiomas para processamento de documentos global
✅ Reconhecimento de elementos complexos incluindo documentos manuscritos e históricos
✅ Velocidades de inferência rápidas para fluxos de trabalho de alto throughput
✅ Eficiente em recursos com modelo compacto de 0,9 bilhões de parâmetros
Seja você processando notas fiscais, digitalizando artigos de pesquisa, analisando documentos jurídicos ou lidando com conteúdo multilíngue, o PaddleOCR-VL na Novita AI entrega resultados prontos para produção desde o primeiro dia.
Pronto para transformar seu fluxo de trabalho de documentos?
Não deixe que uma configuração de OCR complexa te atrase. Implante o PaddleOCR-VL em uma instância GPU da Novita AI hoje e comece a processar documentos em minutos, não em horas.
👉 Implante o Modelo GPU do PaddleOCR-VL Agora
Obtenha acesso instantâneo ao modelo pré-configurado do PaddleOCR-VL com todas as dependências e otimizações incluídas. Basta clicar, configurar e implantar — seu serviço OCR SOTA estará funcionando em 5 minutos.
Por que milhares de desenvolvedores escolhem a Novita AI:
- Gerenciamento de infraestrutura zero
- Preços pagos conforme o uso, sem custos iniciais
- Modelos pré-configurados para implantação instantânea
- Recursos GPU escaláveis sob demanda
- Suporte 24/7 e documentação abrangente
Comece sua implantação agora — sua primeira inferência de OCR está a apenas 5 minutos de distância.
Perguntas frequentes
Quanto tempo leva para implantar o PaddleOCR-VL na Novita AI?
Aproximadamente 5 minutos, da seleção do modelo até a instância em execução.
Quais idiomas o PaddleOCR-VL suporta?
109 idiomas, incluindo chinês, inglês, japonês, coreano, russo, árabe, hindi, tailandês e muitos outros.
O PaddleOCR-VL consegue reconhecer texto manuscrito?
Sim, o PaddleOCR-VL se destaca no reconhecimento de texto manuscrito e documentos históricos com qualidade degradada.
Quais tipos de elementos de documento o PaddleOCR-VL pode extrair?
Texto, tabelas, fórmulas matemáticas, gráficos e outros elementos complexos de documentos.
Preciso ter experiência com GPU para implantar na Novita AI?
Não, o modelo pré-configurado lida com toda a configuração técnica automaticamente. Basta clicar no link do Modelo GPU do PaddleOCR-VL e seguir os passos simples.
Quanto custa executar o PaddleOCR-VL na Novita AI?
A Novita AI oferece preços pagos conforme o uso. Você paga apenas pelo tempo de GPU que realmente usa, sem custos iniciais ou compromissos de longo prazo.
A Novita AI é uma plataforma de nuvem de IA que oferece aos desenvolvedores uma maneira fácil de implantar modelos de IA usando nossa API simples, além de fornecer uma nuvem GPU acessível e confiável para construção e escalonamento.