DSpark — это метод спекулятивного декодирования, опубликованный компанией Novita. Мы обучили и выпустили производственные спекуляторы DSpark для Kimi-K2.6 и Kimi-K2.7-Code, интегрировали их с vLLM и оценили, как масштабируется их подход с параллельным формированием блоков при увеличении окна спекулятивного декодирования.
Контрольные точки предназначены для ускорения работы Kimi без изменения целевой модели. Лёгкая черновая модель предлагает блок кандидатных токенов, а полная модель Kimi проверяет эти кандидаты, прежде чем они будут приняты.
В наших оценках vLLM nightly с размером пакета 1, DSpark с num_speculative_tokens=7 достиг среднего ускорения пропускной способности в 2,55x для Kimi-K2.6 и 2,36x для Kimi-K2.7-Code. При увеличении окна спекулятивного декодирования с n=3 до n=7, DSpark преобразовывал дополнительные черновые токены в пропускную способность более последовательно, чем доступные базовые модели Eagle3-MLA.
Опубликованные контрольные точки:
- novita/kimi-k2.6-dspark для Kimi-K2.6
- novita/kimi-k2.7-code-dspark для Kimi-K2.7-Code
Результаты тестирования DSpark для Kimi-K2.6 и Kimi-K2.7-Code
При размере пакета 1 увеличение num_speculative_tokens с 3 до 7 повысило среднее ускорение DSpark с 2,17x до 2,55x для Kimi-K2.6 и с 2,12x до 2,36x для Kimi-K2.7-Code. Указанные базовые модели Eagle3-MLA в среднем остались почти неизменными.
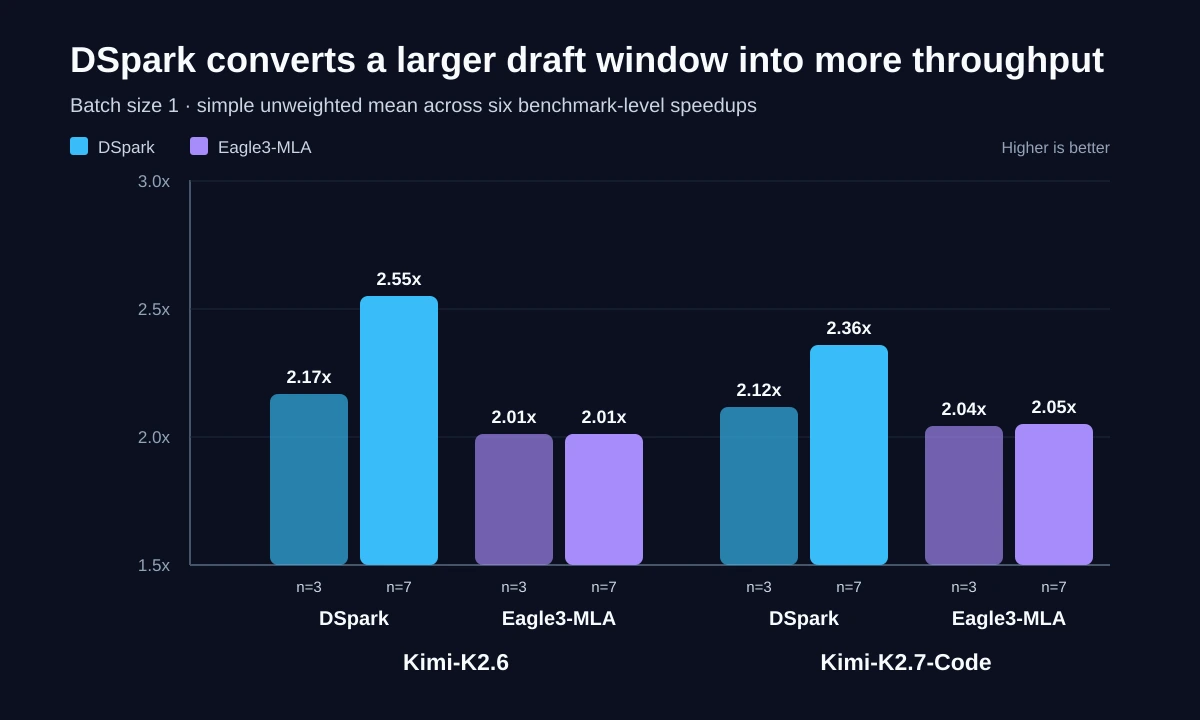
| Целевая модель | Черновая модель | Среднее ускорение при n=3 | Среднее ускорение при n=7 | Изменение относительно n=3 | |—|—:|—:|—:| | Kimi-K2.6 | DSpark | 2,17x | 2,55x | +17,8% | | Kimi-K2.6 | Eagle3-MLA | 2,01x | 2,01x | +0,2% | | Kimi-K2.7-Code | DSpark | 2,12x | 2,36x | +11,7% | | Kimi-K2.7-Code | Eagle3-MLA | 2,04x | 2,05x | +0,3% |
Эти значения представляют собой простые невзвешенные средние ускорений по тестам GSM8K, MATH500, AIME, HumanEval, LiveCodeBench и SPEED-Bench Coding; они не взвешены по количеству запросов. Увеличение окна черновика не гарантирует автоматического повышения пропускной способности: дополнительные предложения должны приниматься достаточно часто, чтобы компенсировать накладные расходы на черновое декодирование и проверку.
LiveCodeBench делает разницу наглядной. Для Kimi-K2.6 DSpark перешёл с 1,86x при n=3 до 1,87x при n=7, в то время как Eagle3-MLA упал с 1,67x до 1,48x. Для Kimi-K2.7-Code DSpark вырос с 1,75x до 1,78x, а Eagle3-MLA упал с 1,69x до 1,52x. На SPEED-Bench Coding DSpark увеличился с 2,19x до 2,41x для Kimi-K2.6 и с 2,15x до 2,31x для Kimi-K2.7-Code.
Настройки оценки: размер пакета 1, онлайн-спекулятивное декодирование vLLM nightly, жадное декодирование, TP=8, max_model_len=20000, включены CUDA graphs, fuse_allreduce_rms=false. Более высокие значения токенов/сек и ускорения лучше. Размер пакета 1 изолирует поведение декодирования одного запроса; результаты могут отличаться при непрерывной пакетной обработке или производственных нагрузках с более высокой степенью параллелизма. Полные результаты доступны на страницах Hugging Face для Kimi-K2.6 DSpark и Kimi-K2.7-Code DSpark.
Почему DSpark улучшает спекулятивное декодирование Kimi
Наши контрольные точки применяют DSpark к Kimi-K2.6 и Kimi-K2.7-Code в качестве черновых моделей для обслуживания vLLM.
По сравнению с базовым параллельным формированием черновиков DFlash, DSpark добавляет две лёгкие головки: головку смещения логитов Маркова для низкоранговой зависимости токенов внутри блока и головку уверенности для каждой позиции для прогнозирования принятия. DSpark предлагает весь блок черновика параллельно, а затем использует эти головки для улучшения качества блока черновика и оценки того, какие позиции, вероятно, будут приняты верификатором.
Мы обучили черновые модели с помощью форка фреймворка Speculators от vLLM. Во время обучения черновик использует скрытые состояния, передаваемые от работающего верификатора Kimi в vLLM, что согласует спекулятор с поведением верификатора, с которым он столкнётся во время обслуживания.
В наших опубликованных таблицах в качестве базовых черновых моделей используются доступные открытые контрольные точки Eagle3-MLA с тем же верификатором и конфигурацией обслуживания. Ключевой результат — как методы масштабируются с увеличением окна спекулятивного декодирования: при переходе от n=3 к n=7 среднее ускорение DSpark увеличилось на 17,8% для Kimi-K2.6 и на 11,7% для Kimi-K2.7-Code, в то время как указанные базовые модели Eagle3-MLA в среднем остались почти неизменными и замедлились на обеих оценках LiveCodeBench. Это позволяет предположить, что DSpark более эффективно сохраняет полезное качество черновика по мере роста окна. Сравнение относится к конкретным контрольным точкам, рабочей нагрузке с размером пакета 1 и проверенной конфигурации обслуживания.
Как обслуживать Kimi-K2.7-Code с DSpark в vLLM
Поддержка DSpark в настоящее время требует сборки vLLM nightly. Для Kimi-K2.7-Code используйте следующую конфигурацию спекулятивного декодирования:
uv pip install vllm --extra-index-url https://wheels.vllm.ai/nightly

vllm serve moonshotai/Kimi-K2.7-Code \
  --tensor-parallel-size 8 \
  --max-model-len 20000 \
  --trust-remote-code \
  --compilation-config='{"pass_config": {"fuse_allreduce_rms": false}}' \
  --speculative-config '{
    "model": "novita/kimi-k2.7-code-dspark",
    "num_speculative_tokens": 7,
    "method": "dspark"
  }'
Для Kimi-K2.6 используйте ту же конфигурацию и укажите speculative_config.model на novita/kimi-k2.6-dspark.
Известные ограничения nightly-сборки: планирование AOT FA3 на стороне черновика может потребовать передачи fast_build=True при построении метаданных внимания черновика, а захват графа CUDA может привести к ошибке размера рабочего пространства FlashInfer all-reduce. Проверенная конфигурация отключает fuse_allreduce_rms; актуальные обходные пути см. на связанных страницах Hugging Face.
DSpark изменяет путь декодирования, не изменяя целевую модель Kimi. Мы рекомендуем начинать с num_speculative_tokens=7, а затем проверять пропускную способность, принятую длину, задержку между токенами и сквозную задержку на репрезентативном производственном трафике. Наилучшая конфигурация будет зависеть от формы рабочей нагрузки, пакетирования и аппаратного обеспечения обслуживания.