DSpark هي طريقة فك تشفير تخميني نشرتها Novita. قمنا بتدريب وإصدار مخمنات DSpark موجهة للإنتاج لـ Kimi-K2.6 وKimi-K2.7-Code، ودمجناها مع vLLM، وقمنا بتقييم كيفية توسع نهج الصياغة المتوازية للكتل مع نمو النافذة التخمينية.
صُممت نقاط التحقق هذه لجعل خدمة Kimi أسرع دون تغيير النموذج المستهدف. يقترح نموذج مسودة خفيف كتلة من الرموز المرشحة، ويتحقق نموذج Kimi الكامل من هذه المرشحات قبل قبولها.
في تقييماتنا الليلية vLLM بحجم دُفعة 1، حقق DSpark مع num_speculative_tokens=7 تسريعًا متوسطًا للإنتاجية بلغ 2.55x لـ Kimi-K2.6 و2.36x لـ Kimi-K2.7-Code. مع زيادة النافذة التخمينية من n=3 إلى n=7، حوّل DSpark الرموز المسودة الإضافية إلى إنتاجية بشكل أكثر اتساقًا من خطوط الأساس Eagle3-MLA المتاحة.
نقاط التحقق المُصدرة هي:
- novita/kimi-k2.6-dspark لـ Kimi-K2.6
- novita/kimi-k2.7-code-dspark لـ Kimi-K2.7-Code
نتائج تقييم DSpark لـ Kimi-K2.6 وKimi-K2.7-Code
عند حجم دُفعة 1، أدى زيادة num_speculative_tokens من 3 إلى 7 إلى رفع متوسط تسريع DSpark من 2.17x إلى 2.55x لـ Kimi-K2.6 ومن 2.12x إلى 2.36x لـ Kimi-K2.7-Code. ظلت خطوط الأساس Eagle3-MLA المذكورة ثابتة تقريبًا في المتوسط.
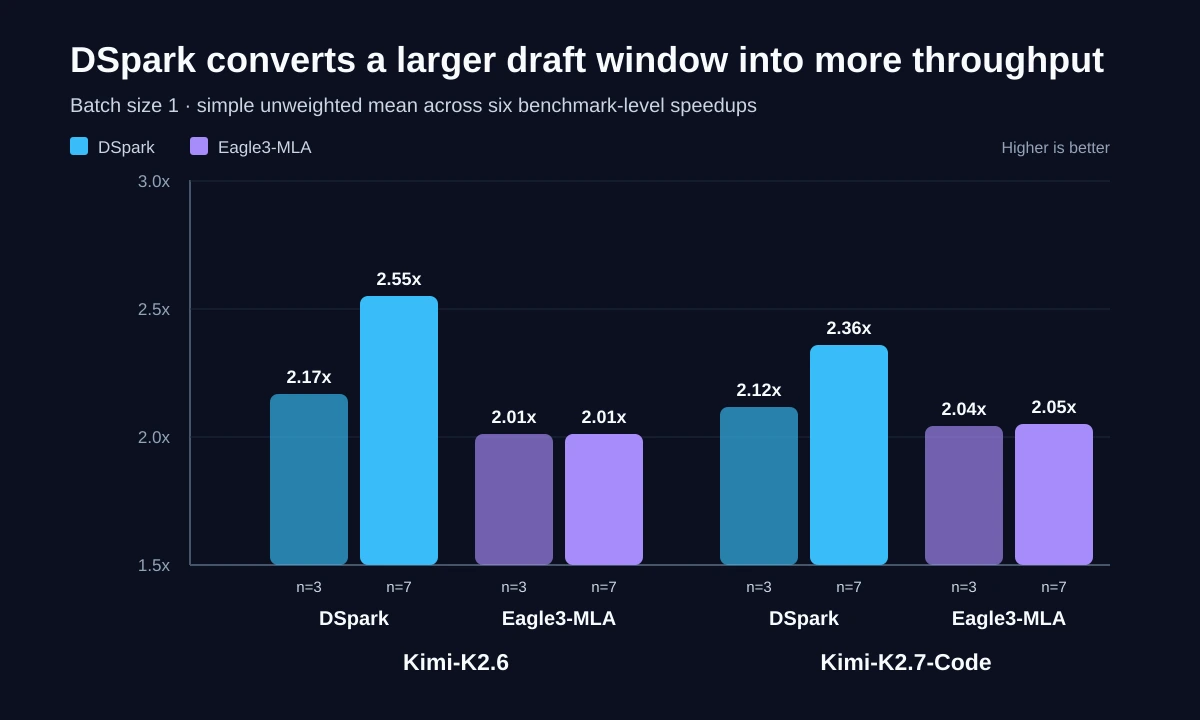
| النموذج المستهدف | نموذج المسودة | متوسط التسريع n=3 | متوسط التسريع n=7 | التغيير من n=3 | |—|—:|—:|—:| | Kimi-K2.6 | DSpark | 2.17x | 2.55x | +17.8% | | Kimi-K2.6 | Eagle3-MLA | 2.01x | 2.01x | +0.2% | | Kimi-K2.7-Code | DSpark | 2.12x | 2.36x | +11.7% | | Kimi-K2.7-Code | Eagle3-MLA | 2.04x | 2.05x | +0.3% |
هذه القيم هي متوسطات بسيطة غير مرجحة لتسريعات مستوى التقييم عبر GSM8K وMATH500 وAIME وHumanEval وLiveCodeBench وSPEED-Bench Coding؛ وهي غير مرجحة بعدد المطالبات. لا تؤدي النافذة التخمينية الأكبر تلقائيًا إلى تحسين الإنتاجية: يجب أن تكون المقترحات الإضافية مقبولة بشكل كافٍ لتعويض عبء الصياغة والتحقق.
يجعل LiveCodeBench الفرق ملموسًا. بالنسبة لـ Kimi-K2.6، انتقل DSpark من 1.86x عند n=3 إلى 1.87x عند n=7، بينما انخفض Eagle3-MLA من 1.67x إلى 1.48x. بالنسبة لـ Kimi-K2.7-Code، زاد DSpark من 1.75x إلى 1.78x، بينما انخفض Eagle3-MLA من 1.69x إلى 1.52x. في SPEED-Bench Coding، زاد DSpark من 2.19x إلى 2.41x لـ Kimi-K2.6 ومن 2.15x إلى 2.31x لـ Kimi-K2.7-Code.
إعداد التقييم: حجم دُفعة 1، فك التشفير التخميني الليلي عبر الإنترنت لـ vLLM، فك تشفير جشع، TP=8، max_model_len=20000، تمكين رسومات CUDA، وfuse_allreduce_rms=false. كلما زادت الرموز/الثانية والتسريع كان أفضل. يحدد حجم الدُفعة 1 سلوك فك التشفير لطلب فردي؛ قد تختلف النتائج في ظل التجميع المستمر أو أعباء العمل الإنتاجية عالية التزامن. النتائج الكاملة متاحة على صفحات Hugging Face لـ Kimi-K2.6 DSpark وKimi-K2.7-Code DSpark.
لماذا يُحسّن DSpark فك التشفير التخميني لـ Kimi
تطبق نقاط التحقق الخاصة بنا DSpark على Kimi-K2.6 وKimi-K2.7-Code كنماذج مسودة لخدمة vLLM.
بالمقارنة مع العمود الفقري للصياغة المتوازية DFlash، يضيف DSpark رأسين خفيفين: رأس انحياز السجل Markov للاعتماد على الرموز داخل الكتلة منخفض الرتبة، ورأس ثقة لكل موضع للتنبؤ بالقبول. يقترح DSpark كتلة المسودة الكاملة بالتوازي، ثم يستخدم هذه الرؤوس لتحسين جودة المسودة على مستوى الكتلة وتقدير المواضع التي من المحتمل أن يقبلها المدقق.
قمنا بتدريب نماذج المسودة باستخدام فرع مخصص من إطار عمل Speculators الخاص بـ vLLM. أثناء التدريب، تستهلك المسودة الحالات المخفية المنقولة من مدقق Kimi المباشر الذي يعمل في vLLM، مما يوائم المخمن مع سلوك المدقق الذي سيواجهه في وقت الخدمة.
تستخدم جداولنا المنشورة نقاط التحقق المفتوحة المصدر المتاحة لـ Eagle3-MLA كخطوط أساس لنماذج المسودة تحت نفس المدقق وتكوين الخدمة. النتيجة المركزية هي كيفية توسع الأساليب مع نافذة تخمينية أكبر: من n=3 إلى n=7، زاد متوسط تسريع DSpark بنسبة 17.8% لـ Kimi-K2.6 و11.7% لـ Kimi-K2.7-Code، بينما ظلت خطوط الأساس Eagle3-MLA المذكورة ثابتة تقريبًا في المتوسط وتباطأت في كلا تقييمي LiveCodeBench. يشير هذا إلى أن DSpark يحافظ على جودة مسودة مفيدة بشكل أكثر فعالية مع نمو النافذة. المقارنة خاصة بنقاط التحقق، وحجم الدُفعة 1، وتكوين الخدمة المختبر هنا.
كيفية خدمة Kimi-K2.7-Code باستخدام DSpark في vLLM
يتطلب دعم DSpark حاليًا إصدارًا ليليًا من vLLM. بالنسبة لـ Kimi-K2.7-Code، استخدم تكوين فك التشفير التخميني التالي:
uv pip install vllm --extra-index-url https://wheels.vllm.ai/nightly

vllm serve moonshotai/Kimi-K2.7-Code \
  --tensor-parallel-size 8 \
  --max-model-len 20000 \
  --trust-remote-code \
  --compilation-config='{"pass_config": {"fuse_allreduce_rms": false}}' \
  --speculative-config '{
    "model": "novita/kimi-k2.7-code-dspark",
    "num_speculative_tokens": 7,
    "method": "dspark"
  }'
بالنسبة لـ Kimi-K2.6، استخدم نفس التكوين ووجّه speculative_config.model إلى novita/kimi-k2.6-dspark.
تحذيرات معروفة للإصدار الليلي: قد يتطلب جدولة FA3 AOT من جانب المسودة تمرير fast_build=True عند بناء بيانات وصفية لانتباه المسودة، وقد يواجه التقاط رسم CUDA خطأ في حجم مساحة عمل الاختزال الكلي FlashInfer. التكوين المختبر يُعطل fuse_allreduce_rms؛ راجع صفحات Hugging Face المرتبطة للحصول على الحلول البديلة الحالية.
يغير DSpark مسار فك التشفير دون تغيير نموذج Kimi المستهدف. نوصي بالبدء بـ num_speculative_tokens=7، ثم التحقق من الإنتاجية، والطول المقبول، وزمن الوصول بين الرموز، وزمن الوصول الشامل مقابل حركة المرور الإنتاجية التمثيلية. سيعتمد أفضل تكوين على شكل عبء العمل، والتجميع، وأجهزة الخدمة.