DSpark는 Novita가 발표한 추측 디코딩 방법입니다. 우리는 Kimi-K2.6 및 Kimi-K2.7-Code를 위한 프로덕션 지향 DSpark 추측기를 훈련 및 배포하고, 이를 vLLM과 통합하여 추측 윈도우가 커짐에 따라 병렬 블록 초안 작성 접근 방식이 어떻게 확장되는지 평가했습니다.
체크포인트는 대상 모델을 변경하지 않고 Kimi 서빙을 더 빠르게 만들도록 설계되었습니다. 가벼운 초안 모델이 후보 토큰 블록을 제안하면, 전체 Kimi 모델이 해당 후보를 수락하기 전에 검증합니다.
배치 크기 1의 vLLM nightly 평가에서, num_speculative_tokens=7인 DSpark는 Kimi-K2.6에서 평균 처리량 속도 향상 2.55배, Kimi-K2.7-Code에서 2.36배를 달성했습니다. 추측 윈도우가 n=3에서 n=7로 증가함에 따라 DSpark는 사용 가능한 Eagle3-MLA 기준선보다 더 일관되게 추가 초안 토큰을 처리량으로 전환했습니다.
공개된 체크포인트는 다음과 같습니다:
- novita/kimi-k2.6-dspark (Kimi-K2.6용)
- novita/kimi-k2.7-code-dspark (Kimi-K2.7-Code용)
Kimi-K2.6 및 Kimi-K2.7-Code에 대한 DSpark 벤치마크 결과
배치 크기 1에서 num_speculative_tokens를 3에서 7로 증가시키면 DSpark의 평균 속도 향상은 Kimi-K2.6의 경우 2.17배에서 2.55배로, Kimi-K2.7-Code의 경우 2.12배에서 2.36배로 증가했습니다. 나열된 Eagle3-MLA 기준선은 평균적으로 거의 변화가 없었습니다.
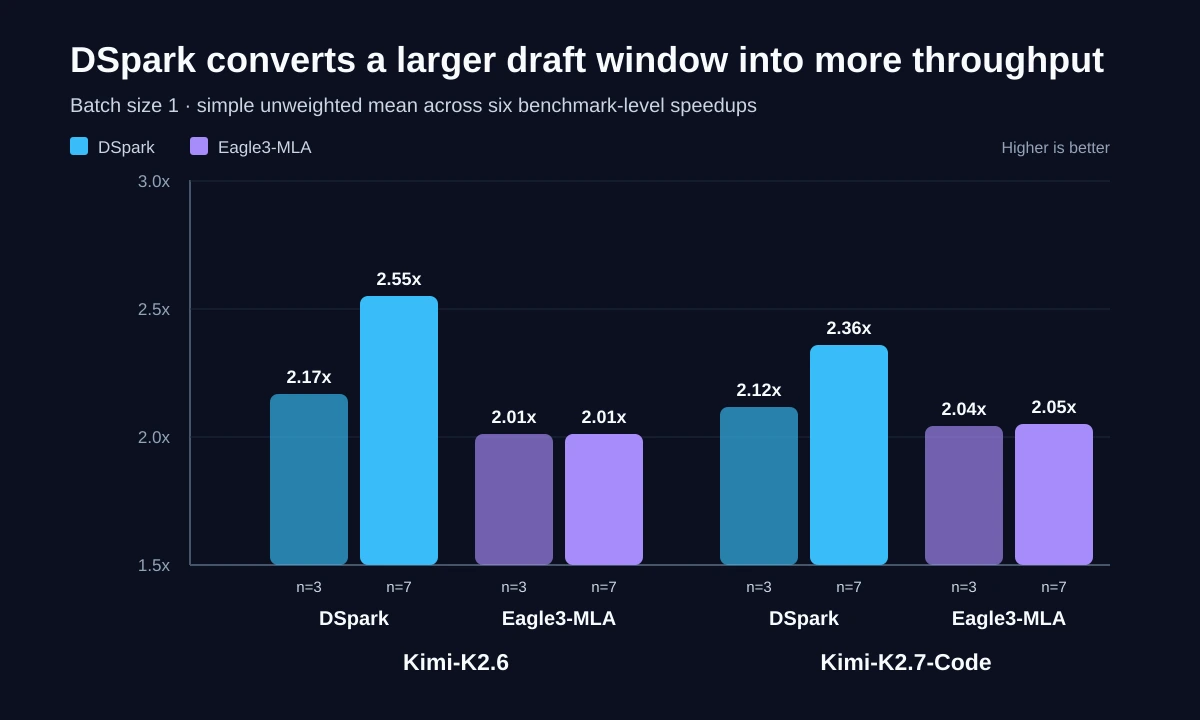
| 대상 모델 | 초안 모델 | n=3 평균 속도 향상 | n=7 평균 속도 향상 | n=3 대비 변화 | |—|—:|—:|—:| | Kimi-K2.6 | DSpark | 2.17x | 2.55x | +17.8% | | Kimi-K2.6 | Eagle3-MLA | 2.01x | 2.01x | +0.2% | | Kimi-K2.7-Code | DSpark | 2.12x | 2.36x | +11.7% | | Kimi-K2.7-Code | Eagle3-MLA | 2.04x | 2.05x | +0.3% |
이 값들은 GSM8K, MATH500, AIME, HumanEval, LiveCodeBench, SPEED-Bench Coding 전반에 걸친 벤치마크 수준 속도 향상의 단순하고 가중치가 없는 평균입니다. 프롬프트 수로 가중치가 부여되지 않았습니다. 초안 윈도우가 크다고 해서 자동으로 처리량이 향상되는 것은 아닙니다. 추가 제안이 초안 작성 및 검증 오버헤드를 상쇄할 만큼 자주 수락되어야 합니다.
LiveCodeBench는 그 차이를 구체적으로 보여줍니다. Kimi-K2.6의 경우 DSpark는 n=3에서 1.86x에서 n=7에서 1.87x로 이동한 반면, Eagle3-MLA는 1.67x에서 1.48x로 떨어졌습니다. Kimi-K2.7-Code의 경우 DSpark는 1.75x에서 1.78x로 증가한 반면, Eagle3-MLA는 1.69x에서 1.52x로 떨어졌습니다. SPEED-Bench Coding에서 DSpark는 Kimi-K2.6의 경우 2.19x에서 2.41x로, Kimi-K2.7-Code의 경우 2.15x에서 2.31x로 증가했습니다.
평가 설정: 배치 크기 1, 온라인 vLLM nightly 추측 디코딩, 그리디 디코딩, TP=8, max_model_len=20000, CUDA 그래프 활성화, fuse_allreduce_rms=false. 더 높은 토큰/초 및 속도 향상이 더 좋습니다. 배치 크기 1은 단일 요청 디코드 동작을 분리합니다. 연속 배치 또는 더 높은 동시성의 프로덕션 워크로드에서는 결과가 다를 수 있습니다. 전체 결과는 Kimi-K2.6 DSpark 및 Kimi-K2.7-Code DSpark의 Hugging Face 페이지에서 확인할 수 있습니다.
DSpark가 Kimi 추측 디코딩을 개선하는 이유
우리의 체크포인트는 DSpark를 Kimi-K2.6 및 Kimi-K2.7-Code에 적용하여 vLLM 서빙을 위한 초안 모델로 사용합니다.
DFlash 병렬 초안 작성 백본과 비교하여 DSpark는 두 개의 경량 헤드를 추가합니다: 저순위 intra-block 토큰 종속성을 위한 Markov 로짓 편향 헤드와 수락 예측을 위한 위치별 신뢰도 헤드입니다. DSpark는 전체 초안 블록을 병렬로 제안한 다음, 이러한 헤드를 사용하여 블록 수준 초안 품질을 개선하고 검증기가 수락할 가능성이 있는 위치를 추정합니다.
우리는 vLLM의 Speculators 프레임워크의 벤더 포크를 사용하여 초안 모델을 훈련했습니다. 훈련 중에 초안은 vLLM에서 실행 중인 라이브 Kimi 검증기에서 스트리밍된 hidden states를 소비하여, 추측기를 서빙 시간에 만날 검증기 동작에 맞춥니다.
우리가 게시한 표는 동일한 검증기 및 서빙 구성 하에서 사용 가능한 오픈 소스 Eagle3-MLA 체크포인트를 초안 모델 기준선으로 사용합니다. 핵심 결과는 더 큰 추측 윈도우( n=3에서 n=7로)에서 방법이 어떻게 확장되는지입니다. DSpark의 평균 속도 향상은 Kimi-K2.6에서 17.8%, Kimi-K2.7-Code에서 11.7% 증가한 반면, 나열된 Eagle3-MLA 기준선은 평균적으로 거의 변화가 없었고 두 LiveCodeBench 평가 모두에서 느려졌습니다. 이는 윈도우가 커짐에 따라 DSpark가 유용한 초안 품질을 더 효과적으로 유지함을 시사합니다. 비교는 여기에서 테스트된 체크포인트, 배치 크기 1 워크로드 및 서빙 구성에 한정됩니다.
vLLM에서 DSpark로 Kimi-K2.7-Code 서빙하는 방법
DSpark 지원은 현재 vLLM nightly 빌드가 필요합니다. Kimi-K2.7-Code의 경우 다음 추측 디코딩 구성을 사용하세요:
uv pip install vllm --extra-index-url https://wheels.vllm.ai/nightly

vllm serve moonshotai/Kimi-K2.7-Code \
  --tensor-parallel-size 8 \
  --max-model-len 20000 \
  --trust-remote-code \
  --compilation-config='{"pass_config": {"fuse_allreduce_rms": false}}' \
  --speculative-config '{
    "model": "novita/kimi-k2.7-code-dspark",
    "num_speculative_tokens": 7,
    "method": "dspark"
  }'
Kimi-K2.6의 경우 동일한 구성을 사용하고 speculative_config.model을 novita/kimi-k2.6-dspark로 지정하세요.
알려진 nightly 빌드 주의사항: 초안 측 FA3 AOT 스케줄링은 초안 어텐션 메타데이터를 빌드할 때 fast_build=True를 전달해야 할 수 있으며, CUDA 그래프 캡처는 FlashInfer all-reduce 워크스페이스 크기 오류가 발생할 수 있습니다. 테스트된 구성은 fuse_allreduce_rms를 비활성화합니다. 현재 해결 방법은 링크된 Hugging Face 페이지를 참조하세요.
DSpark는 대상 Kimi 모델을 변경하지 않고 디코딩 경로를 변경합니다. num_speculative_tokens=7로 시작한 다음, 대표적인 프로덕션 트래픽에 대해 처리량, 수락된 길이, 토큰 간 지연 시간 및 종단 간 지연 시간을 검증하는 것이 좋습니다. 최상의 구성은 워크로드 형태, 배치 및 서빙 하드웨어에 따라 달라집니다.