TL;DR
Novita AI는 고성능 W4A16 MoE CUDA 연산자인 Chord를 오픈소스로 공개했습니다. BF16 활성화, INT4 가중치, 그룹-32 스케일을 지원합니다. Kimi K2.x 서빙 형태에 맞춰 제작되었으며, 인덱스 경로는 Humming 호환 humming 임포트 루트를 노출하고, 호환되는 vLLM 리비전에서는 --quantization humming으로 선택됩니다. 그룹 연산자를 vLLM의 Humming 백엔드와 통합하는 작업은 아직 진행 중입니다.
짧은 답변: Chord는 NVIDIA H200 및 Blackwell GPU에서 Kimi K2.x의 INT4 (W4A16) Mixture-of-Experts 추론을 가속화하는 오픈소스 CUDA 커널 패키지입니다. vLLM 배포는 기존 Humming 백엔드를 통해 Chord의 인덱스 경로를 사용할 수 있습니다. 그룹 SM90 연산자는 프레임워크 통합이 계속되는 동안 독립형 API로 제공됩니다.
공개 Humming의 일치 경로 대비 레이어당 측정 결과:
- **H200 EP8 프리필에서 1.11–1.20배 **, H200 TP8 단일 인스턴스 서빙에서 1.17–1.33배.
- H200 EP8 디코드에서 1.16–1.24배, 다운 스테이지는 1.31배까지 도달.
- B300 EP8 디코드에서 1.81–2.15배 (튜닝되지 않은 기본 구성 전략 대비).
- 그룹 H200 EP8 프리필 디코드 경로에서 1.00–1.31배 및 1.16–1.35배; 같은 표에서 EP16은 1.18–1.34배, EP32는 1.13–1.30배.

그림 1. 측정된 6개 시나리오에서 공개 Humming 대비 호출 지연 시간, 낮을수록 좋음. 각 패널은 독립적으로 해석: B300 디코드 패들은 튜닝되지 않은 Humming 기본값과 비굔하는데, 공개 Humming에는 SM100/SM103 튜닝 테이블이 없기 때문이고, 모든 H200 패들은 튜닝된 것끼리 비교합니다. Chord 리포지토리의 차트; 전체 표는 docs/performance.md에 있음.
이 수치들의 기본 아이디어는 하나의 W4A16 MoE 커널이 모든 요청에 적합할 수 없다는 것입니다. 전문가당 라우팅된 토큰 수는 프리필과 디코드 사이에 수 배 차이가 나며, 총 토큰 수가 아니라 이 양이 어떤 스케줄이 승리할지를 결정합니다. Chord는 실제로 주어진 형태에서 스케줄을 선택합니다.
이는 커널 수준의 측정치이며, 모든 작업 부하에 대해 동일한 종단 간 이득을 약속하는 것은 아닙니다. 전체 표, 형태 정의 및 타이밍 방법로기는 docs/performance.md 및 docs/benchmarking.md에 있습니다. 이 포스트의 코드 및 커널 테이블은 7ca91d8 (2026년 9월 14일)을 참조합니다.
두 가지 커널 패밀리
Chord는 W4A16 INT4 MoE 커널 패밀리 두 개를 가지며, 각각 다룬 루팅 배치 및 서빙 단계에 최적화되었습니다.
현재 main 브랜치는 두 개의 독릭된 패밀리를 제공합니다:
indexed는 Humming에서 파생된 경로입니다. vLLM의sortted_ids/expert_ids/num_tokens_padded�팅을 사룡하며, H200 EP8 프리필, H200 TP8 단일 인스턴스 서빙, H200 EP8 디코드, B200/B300 EP8 디코드를 커버합니다.grouped_contiguous(프리필) 및grouped_masked(디코드)는 DeepGEMM에서 파생된 두 번째 SM90 패밀리입니다. 그룹 �팅 (m_indices또는expert_ayout)을 사룡하고 다른 패킹된 가중치 배치를 사용합니다.
vLLM 통합
패키지를 설치하고 기존 Humming 백엔드를 선택하세여:
pip install git+https://github.com/novitalabs/chord.git
# inclusionAI/humming과 함께 설치하지 마세여: Chord는 해당 임포트 이름을 의도적으로 소유합니다 (인덱스 경로용, 그룹 통합은 진행 중).

vllm serve <kimi-k2.x-int4-model> --quantiation humming
# 또는 vLLM 구성에서 moe_backend="humming" 선택
배포는 chord 및 humming 모듈 루트를 모두 제곧합니다. vLLM의 지연 파사드는 humming.{dtypes,config,layer, schema, utils.weight}를 해결합니다. 기본 인덱스 경로는 아래 언급된 WNA16 그룹-스케일 지원이 있는 브랜치에서 Chord 특정 프레임워크 패치 없이 이 기존 통합을 사용할 수 있습니다. 제공된 스키마는 uint4, 그룹-32, BF16 스케일 및 Kimi K2.x에서 사용되는 compressed-tensors pack-양자화 INT4 그룹-32 체크포인트 포멋을 지원합니다. 지원되지 않는 양자화 방식은 잘못된 커널을 조용히 선택하는 대신 로드 시 실패합니다.
vLLM의 Humming 백엔드와 그룹 연산자 통합은 진행 중입니다. 아래에 독립형 그룹 연산자 API가 나와 있습니다.
TP8은 h200_tp8 프로파일이 인덱스로 계속 유지됩니다. 하나의 TP8 가중치가 단계를 모두 제공해야 하기 때문입니다.
기타 배포 세부사항:
- 프로파일 선택은 프레임워크에서 이미 전달된 프조젝션 형태에서 EP8 대 TP8을 복구합니다. 인덱스 프로파일에는 Chord 특정 샤드 인수가 필요하지 않습니다. 그룹 프로파일은 EP 전용이며 SM90에서 EP8/EP16/EP32를 지원합니다.
- 인덱스 고속 경로는 vLLM의 초과 할당된
moe_align_blook_size버퍼를 사룡하여 신뢰된 루팅 유효성 검사가 비활성화되 경우 라우팅 개수를 호스트로 다시 읽지 않으므로 CUDA Graph 캡처 가능 상태를 유지합니다. 그룹 경로도 CUDA 루팅 텐서를 사룡하며,valid_shape_m/expected_m은 Python 측 휴리스틱 입력입니다. - 명시적으로 Humming을 선택하세여 (
moe_backend="humming"또는--quantization humming); vLLM의 자동 WNA16 우선순위는 다른 백엔드를 먼저 선택할 수 있습니다.VLLM_HUMMING_USE_F16_ACCUM및VLLM_BATCH_INVARIANT는 꺼 두세여. 두 백엔드 모두 이 컴퓨트 옵션을 구현하지 않습니다. VLLM_HUMMING_MOE_GEMM_TYPE은 기본 통합을 위해 인덱스 동작으로 유지하세여. #48918의 일반 WNA16 그룹-스케일 지원보다 오래된 vLLM 브랜치는 그룹-32 키를_upports_quant_scheme에 추가해야 할 수 있습니 다.
커널 최적화
인덱스 커널
인탁스 패밀리는 공개 inclusionAI/humming 커밋 4351af3에서 파생되었습니다. 아래 작업 부하 영역은 가중치가 팩킹되기 전에 선택되는 다른 커널 프로화일을 유기합니다.
< p align=“center”>
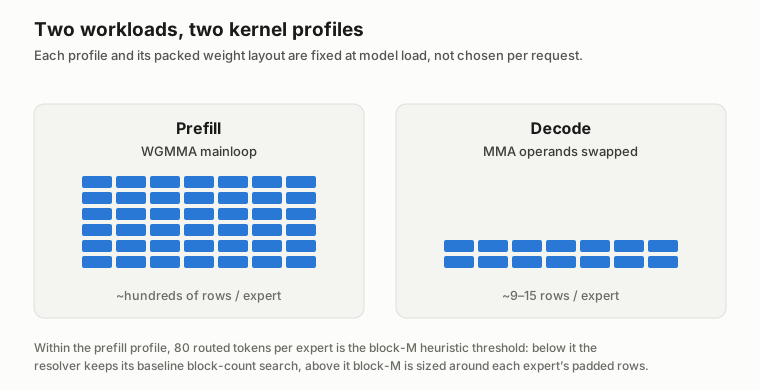
그림 2. 전형적인 프리필 및 디코드 작업 부하. 9–15 행/전문가 라벨은 디코드 테스트 �이스를 나태내고, 80 토큰/전문가는 프리필 블록-M �우리스틱 임곗값입니다. 둘 다 프리필과 디코드 사잇의 런타임 스위치를 정이하지 않습니가: 프로화일과 가중치 배치는 모델 로드 시 고정되며, 토큰 수가 각 프로화일 내에서 스케줄을 조정합니다.
H200 프리필 및 TP8
- 배치된
wait<1>WGMMA 파이프라닝. 하나의 WGMMA 그룹이 비행하는 동안 다음 로드 및 역양자화가 진행되며, 게이트/업에서 약 3–6%, 다운에서 1–5%의 효율을 냅니 다 (발행된 스윕 기준). 출력은 비트 동일. 메커니즘은 아래 설 명합니다. - 토큰-퍼-전문가 블록-M 선택. 인덱스 MoE 패딩 및 레지스터 압력은 총 라우팅된 M뿐만 아니라 전문가당 라우팅된 토큰(
tok_e)에 의해 결정됩니다. H200 EP8 해석기는 이 양을 모델링하고 TP8에 대해 별도의 더 평탄한 윈도우 세트를 유지합니다. - 제한된 2-CTA/SM 윈도우. 중간 크기 타일에서 하나의 CTA가지연 시간에 바운드된 경우, 128-레지스터 발사 한계가 상주 와프를 높이고
cp.async개더 및 역양자화를 숨깁니다. 이 정책은 측정된 블록-M/블록-N 윈도우 내에서만 적용되며, 외부에서는 원래 점유율 선택이 유지됩니다. - 형태 인식 스트림-K 게이팅. 중간-K 다운 프조젝션은 일반 M×N 그리드가 가득 차면 스트림-K를 비활성화하여 분할/축소 오버헤드를 피합니다. 딥-K 게이트/업 및 TP8 프로젝션 특화 교차점에서는 여전히 도움이 되는 곳에 사용됩니다.
tok_e 규칙은 의도적으로 설명하기 쉽지만 MoE 형태에 특화되어 있습니다. 전문가당 라우팅된 토큰이 약 80 미만이면 해석기는 베이스 라인 블록-카운트 검색을 유지하고, 그 이상이면 각 전문가의 패딩된 행과 레지스터 한계를 기준으로 block_m 크기를 조정합니다. TP8은 중간 차원이 좁아 SM을 채울 N 타일이 적기 때문에 더 평탄한 윈도우를 사용합니다.
# H200 EP8 인덱스 프리필 히리스틱의 개념적 형태.
tok_e = routed_m / num_experts
if tok_e < 80:
    block_m = argmin_total_blocks(sampled_outing)
else:
    block_m = fit_padded_expert_rows(tok_e, max_block_m=176)
WGMMA 메인루프는 또한 비동기 의존성 관리를 배치합니다. 각 명령어 그룹을 기다리는 대신, 와프-K 반복 후에 커밋을 하고, 다움 쉐어드 메모리 로드 및 INT4 역양자화가 시작되는 동안 한 그룹을 비행 상태로 유지합니다.
# 단순화퇸 정상 상태; 프롤로그 및 스테이지 관리는 생략.
for warp_k in K_tiles:
    load_next_packed_weghts_and_scales()  # 쉐어드 메모리 -> 레지스터
    issue_wgmma_for_teration(warp_k)
    commit_group()
    wait_group<1>()     # 한 그룹은 비행 상태로 유지 가능
    dequantze_next_n_alternate_buffer()  # 디퀀타이즈 + 그룹 스케일
epilogue:
    wait_group<0>()
더블 버퍼링된 가중치 레지스터를 사용하면 다움 로드 및 역양자화가 미해결 WGMMA 그룹과 중첩될 수 있습니가. 누계기는 에필로그까지 소모되지 않으며, 최종 드레인은 여전히 미해결된 모든 WGMMA 작업을 기다립니가.
H200 및 BlackWel 인덱스 디코드
전문가당 몇 개의 라우팅된 행에서 WGMMA 경로는 배리어에 의해 바운드됩니다. 디코드 프로파일은 MMA 피연산자를 스왑하여 역양자화된 가중치가 MMA-M 피연산자를 차지하도록 하고, m16n8k16을 사용하며, 블록-M 8인 4 CTA/SM을 지원합니다. 반-정적 토큰-타일 스케줄은 9–15 토큰/전문가에서 완전 동적 스케줄의 216 µs에 비해 186 µs를 측정했습니다. 역양자화를 니블 추출에 융합시키는 빼기-그리고-스케일(subtract-then-scale)은 융합되지 않은 BF16 반올림 순서를 보존합니다. 동일한 MMA 명령어 패밀리가 SM100/SM103용으로 컴파일됩니다. 더 큰 BlackWel 디코드 형태는 더 넓은 비-스왑 MMA 타일을 사용합니다. 이 토큰 수에는 tcen05 커넘이 필요하지 않습니다.
그룹 SM90 커넘
그룹 백엔드는 인덱스 커널의 두 번째 이름이 아닌 다른 커널 패밀리입니다. DeepGEMM의 Hopper GEMM 인프라를 W4A16에 특화하고 Chord의 JIT 및 런처에 적응시킵니가. 두 모드 모_TMA, 워프-스페셜라이즈드 WGMMA 및 그룹-32 역양자화를 사용하지만, 라우팅 및 물리적 가중치 배치가 다릅니다.
< p align=“center”>

그림 3. 패딩이 있는 위치. 인덱스는 활성화를 패딩되지 않은 상태로 둠. 그 인덱스는 패딩 세위널을 전달 함. Contiguous는 각 전문가를 128-행 경계로 패딩. Masked는 전문가당 고정 행 예산을 예약.
- Contiguous 프리필: 행이 전문가별로 연결되고, 128-행 경계로 패딩되며,
m_indices(int32, 패딩은-1)가 동반됩니다. 입력은[m, K]; 패커는BLOCK_K=64인 비트-퍼뮤트된 INT4 버퍼를 사용하고 스케일을[G, K/32, N](N 연속)으로 전치합니다. - Masked 디코드: 활성화는 전문가당 고정 행 예산 (
[G*max_m, K]또는[G, max_m, K])을 가지며masked_m/expert_layout이 유효 개수를 나릅니다. 패커는BLOCK_K=128을 사용; 히리스틱은 예상 토큰/전문가에서BLOCK_M을 선택하고, 웨이브 점우율로BLOCK_N을 게이팅하며, 버퍼링된-K 스테이지 깊이를 조정합니다.
그룹 연산자 진입점 (Chord API 전용):
from chord_kernels import contiguous, masked
from chord_kernels.operator import pack_w4a16_grouped

# weight: unsigned INT4 codes [G, N, K]; scale: BF16 [G, N, K/32]
prefill_weight = pack_w4a16_grouped(weight, scale, mode="contiguous")
prefill_out = contiguous(a2, prefill_weight, m_indices)  # [m, N]

decode_weight = pack_w4a16_grouped(weight, scale, mode="masked")
decoded_out = masked(a3, decode_weight, masked_m, expected_m)  # [G*max_m, N]
여기서 expected_m은 발사 선택에 사용되는 양의 Python 정수입니다. masked_m은 전문가당 권위 있는 유효 개수를 저정합니다. 마스크된 출력은 a3이 3차원이더라도 평편화되며, 소비자는 각 전문가의 유효 개수를 초가하는 행을 무시해야 합니다.
모드는 준비된 가중치에 기록되며 디스패치 시 확인되므로, 실수로 프리필 패킹된 가중치를 디코드 커널에 공급하면 큰 소리가 나며 실패합니다. 그룹 디스패치는 SM90 배치 검색을 소유하며 인덱스 block_m 또는 tuning_config 재정의를 수락하지 않습니다. 커널 해상 및 cubin 로딩은 디스크립터(및 CHORD_W4A16_* 튜닝 오버라이드)에 의해 메모이제이션되어, 작은 디코드 발사에서 약 30 µs로 측정된 반복된 호스트 측 검색을 제거합니다.
그룹 메인루프는 지속적이며 워프-스페셜라이즈드: 프로듀서 워프그룹은 TMA를 사용하여 활성화, 패킹된 가중치 및 스케일 타일을 스테이징하고, 소비자 워프그룹은 WGMMA를 실팿하고 BF16 곃과를 �씁니다. 포워드 경로는 이미 펄�트된 INT4 바이트 및 MN-메이저 스케일을 보며, 캐싱된 디스크립터는 각 (mode, M, N, K, expert_count) 형태를 cubin에 매핑하여 디코드 호출 시마다 배치 검색을 반복하지 않습니다.
그룹 히리스틱은 W4A16 작업 부하에 특화된 몇 가지 선태이 있습니가:
- Contiguous 프리필은 그리드가 충분히 클 때 BM128/BK64를 사용합니다. BM128은 INT4 역양자화 및 스케일 프모션을 더 많은 행에 분산시키고, BK64는 각 파이프라인 스테이지를 �게 유지하여 쉐어드 메모리에 여러 스테이지를 위할 공간을 남깁니가. 작은 연곃된 문제는 BM64로 폴백되므로 M 타일이 여전히 SM을 채울 수 있습니가. BM128/BK128은 너무 많은 쉐어드 메모리를 소모하고 파이프라인을 붕괴시킵니가.
- Masked 디코드는 K와 예상 라우팅 테일에서 BM을 결정합니다. 마스크된 그룹은 두 번째 M 타일로 넘칠 수 있으며, 이는 전체 K 차원을 다시 읽습니다. 딥-K 게이트/업의 경우, 히리스틱은 약
1.3 * expected_m행을 커버하여 재읽기를 피합니다. 숏은-K 다운의 경우, 추가 패스가 더 싸기 때문에 더 작은ceil(1.25 * expected_m, 8)타일은 파이프라인 스테이지를 위한 더 많은 공간을 남깁니가. - Masked BN은 웨이브 인식입니다. BN256은 디�안타이즈 모티제이션을 개션하지만, 기계를 바쁘게 유지할 충분한 N 타일이 있을 때만 도움이 됩니다. 해석기는 좁은 EP32 게이트/업의 경우 충만되지 않은 웨이브에 대해 BN128을 유지하고, 숏은-K 다운의 큰 BM에서도 BN128을 유지합니다. 딥-K 게이트/업은 충분한 타일이 기계를 채울 때 여전히 BN256을 사용할 수 있습니다.
- 버퍼링된-K 깊이는 최대화보다 지연 시간에 맞춰 조정됩니다. 디코드는 일반적으로 약 512 버퍼링된 K 요소 (
512 / BLOCK_K스테이지)를 목표로 합니다. 큰 마스크된 타일은 쉐어드 메모리 제한에 따라 약 768을 목표로 합니다. 모든 가용 쉐어드 메모리를 채우면 블록당 하나의 디코드 발사에서 배리어 리사이클링이 더 비싸지며 개선되지 않습니다.
이러한 규칙이 그룹이 인덱스 튜닝 테이블을 재사용하지 않는 이유입니다. 그룹 백엔드는 디스패치 시 실제 모드와 형태에서 (BM, BN, BK, cluster, stages)를 선택합니다. 위에서 인용된 H200 EP8 범위 내에서, 프리필 이점은 512 행/전문가에서 좁아집니다. 두 구현 모두 동일한 처리량 한계에 접근하기 때문입니다. 타일 및 파이프라인 선택은 작은 및 중간 크기 청크에서 가장 중요합니다.
측정
Chord가 Humming보다 얼마나 빠른가?
아래 측정은 실제 비교를 직접 설명합니다. Chord는 게시된 H200 및 B300 커널 수준 시나리오에서 일치하는 공개 Humming 경로보다 빠르며, 가장 큰 이득은 B300 EP8 디코드에서 2.15배에 달합니다. 이는 레이어당 결과이므로, 라우팅, 활성화, 통신 및 기타 서빙 오버헤드는 종단 간 테이블에서 명시하지 않는 한 제외됩니다.
커널 테이블은 triton.testing.do_bench를 사용하며, 각 Chord 경로를 동일한 GPU의 일치하는 공개 Humming 백엔드와 비교합니다. 인덱스 비교는 동일한 형태 및 라우팅 추첨을 사용합니다. 그룹 비교는 전문가당 행 수를 일치시킵니다. 지원되는 GPU에서 Chord의 출력을 일반 PyTorch 참조와 비교하고 타이밍 테이블을 출력하려면 다음 두 스위트를 실행하세요.
python tests/test_w4a16_indexed.py
python tests/test_w4a16_grouped.py
아래 요약은 전체 테이블에서 게이트/업 및 다운 호출 시간을 더한 것입니다. 속도 향상은 Humming (gate_up + down) / Chord (gate_up + down)이며, 라우팅, 활성화 및 통신은 제외됩니다.
| 시나리오 | 형태 지점 | Humming gate_up + down | Chord gate_up + down | 레이어 속도 향상 |
|---|---|---|---|---|
| H200 EP8 인덱스 프리필 | 2048 토큰 | 701.4 µs | 587.9 µs | 1.19x |
| H200 TP8 인덱스 혼합 | 8192 토큰 | 2483.4 µs | 1862.3 µs | 1.33x |
| H200 EP8 인덱스 디코드 | 20 tok/GPU | 413.8 µs | 333.8 µs | 1.24x |
| B300 EP8 인덱스 디코드 | 20 tok/GPU | 493.9 µs | 229.8 µs | 2.15x |
| H200 EP8 그룹 프리필 | 128 행/전문가 | 1204.0 µs | 917.5 µs | 1.31x |
| H200 EP8 그룹 디코드 | 32 토큰/전문가 | 666.3 µs | 493.4 µs | 1.35x |
B300 비교는 의도적으로 한정적입니다. 공개 Humming에는 SM100/SM103 튜닝 테이블이 없으므로, 기본 시간은 튜닝되지 않은 참조입니다. H200 인덱스 비율은 튜닝된 대 튜닝된 비교입니다.
두 패밀리 모두 동일한 공개 Humming 리비전 4351af3에 대해 측정됩니다. 그룹 행은 Humming 자체의 grouped_contiguous/grouped_masked 경로와 비교됩니다. 이 백엔드가 대체하는 계약이기 때문입니다. Humming은 둘 다 GemmType 값으로 노출하며, 일반 커널을 통해 디스패치합니다 (별도 CUDA 파일이 아님). benchmarks/bench_humming.py는 --gemm_type grouped_contiguous 또는 --gemm_type grouped_masked로 선택합니다. 전문가당 행 수는 128-행 타일 경계의 배수에서 양쪽에서 일치됩니다. — Humming 쪽은 --balanced, tests/test_w4a16_grouped.py의 정렬된 경우는 — 각 행이 두 구현에 대해 동일한 GEMM 형태이며, 타일이 패딩에 사용되지 않습니다.
종단 간 서빙
이전 서빙 보고서는 Kimi-K2.6에서 8×H200, TP8 + DCP8, FP8 KV 캐시 및 ShareGPT 요청으로 인덱스 TP8 경로를 측정했습니다. 두 공급자 모두 동일한 --quantization humming 명령을 사용했습니다.
| 메트릭 | Humming | Chord | 변화 |
|---|---|---|---|
| 평균 TTFT | 2022 ms | 1849 ms | −8.6% |
| 프리필 입룍 + 출룍 처리량 | 20,716 tok/s | 22,712 tok/s | +9.6% |
| 디코드 출룍 처리량, 배치 8 | 483 tok/s | 503 tok/s | +4.1% |
| 디코드 출룍 처리량량, 배치 64 | 1650 tok/s | 1740 tok/s | +5.5% |
| 디코드 출룍 처리량량, 배치 128 | 2514 tok/s | 2715 tok/s | +8.0% |
프리필은 프리�스 �싱가 비활성화된 상태에서 출룍 토큔 한 개를 사용했습니가. 디코드는 완전히 워밈된 프리�스 �싱와 함께 두 번재 패스에서 동일한 프롬프트를 재사용했습니다. 보고서는 또한 OCRBench 및 GSM8K에서 Humming 대비 정확도 회귀를 찾지 못했습니다.
다움 단계
- vLLM의 Humming 백엔드와 그룹 통함 완료, 기존 프레임워크 통함을 통해 연속 및 마스크된 연산자를 사용할 수 있게 합니가.
- B200/B300용 EP8 프리필 커널 출시. 내부 테스트에서 유망한 성능을 보인 작동 구현이 있으며, 후속 릴리즈에서 커널과 벤치마크를 공유할 계획입니다.
Chord 시도하기
Chord는 GitHub에서 사용할 수 있습니다: novitalabs/chord. 문서는 시작하기, 최적화, 성능, 튜닝 내부 및 벤치마크 방법론을 다룹니다. 피드백, 이슈 및 다른 배포에서의 벤치마크 보고서를 환영합니다.
자주 묻는 질문
vLLM에서 Chord란 무엇인가요?
Chord는 Novita AI의 W4A16 INT4 Mixture-of-Experts CUDA 커널 패키지입니다. 그 인덱스 경로는 필요한 WNA16 그룹-스케일 포멧을 지원하는 vLLM 리비전을 위해 Humming 호환 임포트 �트를 제곧합니가.
Chord는 어떤 GPU와 모델을 대상으로 하나요?
게시된 프로파일은 NVIDIA H200 및 Blackwell GPU에서 Kimi K2.x 서빙 형태를 대상으로 하며, H200 EP8/TP8 및 B300 EP8 디코드 시나리오를 포합합니가. 그룹 SM90 패밀리는 현대로 Hopper-클래스 GPU를 대상으로 합니가.
Chord가 vLLM과 통함되었나요?
인덱스 경로는 --quantization humming 또는 moe_backend="humming"으로 vLLM의 기존 Humming 백엔드를 사용할 수 있습니가. 그룹 Contiguous 및 Masked 연산자는 현대 독립형 Chord API를 통해 노출되며, vLLM과의 그룹 통함은 아직 진행 중입니가.
Chord 벤치마크 및 설정 지침은 어디에서 찾을 수 있나요?
Chord 리포지토리, 특히 시작하기, 성능 및 벤치마킹 문서를 사용하세요.
감사의 말
Chord의 인덱스 경로는 inclusionAI/Humming을 기반으로 하며, 그룹 SM90 백엔드는 W4A16에 맞게 DeepGEMM의 Hopper GEMM 인프라를 특화합니다. Chord는 Apache-2.0 라이선스로 출시됩니다. 리포지토리의 소스 노트는 유지된 업스트림 구정 요소 및 고지 사항을 기록합니가.
Chord를 구축하고 오�소스로 공개한 Novita AI 팀, 그리고 이 통함을 가능하게 한 논의, 리�, 및 양자화와 MoE 백엔드 인프라에 기여한 vLLM 메인테이너와 넓은 vLLM 커�니티에 감사드립니가.