TL;DR
Novita AI a open-sourcé Chord, un opérateur CUDA MoE W4A16 haute performance pour activations BF16, poids INT4 et échelles groupe-32. Conçu pour les formes de déploiement de Kimi K2.x, son chemin indexé expose la racine d’import humming compatible Humming, sélectionnée avec --quantization humming sur les révisions vLLM compatibles. L’intégration des opérateurs groupés avec le backend Humming de vLLM est encore en cours de développement.
Réponse courte : Chord est un package de noyaux CUDA open-source qui accélère l’inférence Mixture-of-Experts INT4 (W4A16) pour Kimi K2.x sur les GPU NVIDIA H200 et Blackwell. Les déploiements vLLM peuvent utiliser le chemin indexé de Chord via le backend Humming existant ; les opérateurs SM90 groupés sont disponibles en tant qu’API autonome pendant que l’intégration au framework se poursuit.
Mesuré couche par couche par rapport au chemin correspondant du Humming public :
- 1,11–1,20x sur H200 EP8 prefill, et 1,17–1,33x sur H200 TP8 en service mono-instance.
- 1,16–1,24x sur H200 EP8 decode, l’étape down atteignant 1,31x.
- 1,81–2,15x sur B300 EP8 decode, par rapport à la stratégie de configuration par défaut non optimisée du Humming public.
- 1,00–1,31x et 1,16–1,35x pour les chemins groupés H200 EP8 prefill et decode ; les mêmes tableaux mesurent 1,18–1,34x sur EP16 et 1,13–1,30x sur EP32.

Figure 1. Latence par appel par rapport à Humming public dans les six scénarios mesurés, plus bas est meilleur. Lisez chaque panneau indépendamment : le panneau B300 decode compare avec une valeur par défaut non optimisée de Humming car le Humming public ne fournit pas de table de réglage SM100/SM103, tandis que chaque panneau H200 est un comparatif optimisé-à-optimisé. Graphique du dépôt Chord ; tableaux complets dans docs/performance.md.
L’idée derrière ces chiffres est qu’un seul noyau MoE W4A16 ne peut pas convenir à toutes les requêtes. Le nombre de jetons routés par expert varie de plusieurs ordres de grandeur entre le prefill et le decode, et c’est cette quantité, et non le nombre total de jetons, qui détermine le meilleur ordonnancement. Chord choisit l’ordonnancement en fonction de la forme qui lui est effectivement donnée.
Ce sont des mesures au niveau du noyau, pas une promesse d’un gain de bout en bout identique pour chaque charge de travail. Les tableaux complets, définitions de formes et méthodologie de mesure se trouvent dans docs/performance.md et docs/benchmarking.md. Le code et les tables de noyaux dans cet article se réfèrent au commit 7ca91d8 (14 septembre 2026).
Deux familles de noyaux
Chord possède deux familles de noyaux MoE W4A16 INT4, chacune optimisée pour une disposition de routage et une phase de service différentes :
La branche main actuelle fournit deux familles indépendantes :
indexedest le chemin dérivé de Humming. Il consomme le routagesorted_ids/expert_ids/num_tokens_paddedde vLLM et couvre H200 EP8 prefill, H200 TP8 service mono-instance, H200 EP8 decode, et B200/B300 EP8 decode.grouped_contiguous(prefill) etgrouped_masked(decode) sont une deuxième famille SM90 dérivée de DeepGEMM. Ils consomment un routage groupé (m_indicesouexpert_layout) et utilisent une disposition de poids compressés différente.
Intégration avec vLLM
Installez le package et sélectionnez le backend Humming existant :
pip install git+https://github.com/novitalabs/chord.git
# N'installez pas conjointement inclusionAI/humming : Chord possède intentionnellement ce nom d'import (pour le chemin indexé ; l'intégration groupée est en cours de développement).

vllm serve <kimi-k2.x-int4-model> --quantization humming
# ou sélectionnez moe_backend="humming" dans la configuration vLLM
La distribution fournit à la fois les racines de module chord et humming. La façade paresseuse de vLLM résout humming.{dtypes,config,layer,schema,utils.weight} ; le chemin indexé par défaut peut utiliser cette intégration existante sans correctif spécifique à Chord sur les branches avec le support d’échelle de groupe WNA16 mentionné ci-dessous. Le schéma fourni prend en charge uint4, groupe-32, échelles BF16 et le format de point de contrôle INT4 groupe-32 pack-quantized utilisé par Kimi K2.x ; les schémas de quantification non supportés échouent au chargement plutôt que de sélectionner silencieusement un mauvais noyau.
L’intégration groupée avec le backend Humming de vLLM est en cours de développement. L’API autonome des opérateurs groupés est présentée ci-dessous.
TP8 reste le profil h200_tp8 indexé car un poids TP8 doit servir les deux phases.
Autres détails de déploiement :
- La sélection de profil récupère EP8 par rapport à TP8 à partir des formes de projection déjà transmises par le framework ; aucun argument de partition spécifique à Chord n’est requis pour les profils indexés. Les profils groupés sont réservés à EP et supportent EP8/EP16/EP32 sur SM90.
- Le chemin rapide indexé peut consommer les buffers surdimensionnés
moe_align_block_sizede vLLM sans lire le nombre de jetons routés sur l’hôte lorsque la validation de routage de confiance est désactivée, restant ainsi capturable par CUDA Graph. Les chemins groupés utilisent aussi des tenseurs de routage CUDA, tandis quevalid_shape_m/expected_msont des entrées heuristiques côté Python. - Sélectionnez explicitement Humming (
moe_backend="humming"ou--quantization humming) ; la priorité automatique WNA16 de vLLM peut choisir un autre backend en premier. GardezVLLM_HUMMING_USE_F16_ACCUMetVLLM_BATCH_INVARIANTdésactivés car aucun backend n’implémente ces options de calcul. - Gardez
VLLM_HUMMING_MOE_GEMM_TYPEà son comportement indexé pour l’intégration par défaut. Les branches vLLM antérieures au support générique des échelles de groupe WNA16 dans #48918 peuvent nécessiter l’ajout des clés groupe-32 à_supports_quant_scheme.
Optimisations des noyaux
Noyaux indexés
La famille indexée dérive du commit 4351af3 du projet public inclusionAI/humming. Les régimes de charge de travail ci-dessous motivent différents profils de noyau, sélectionnés avant le compression des poids :
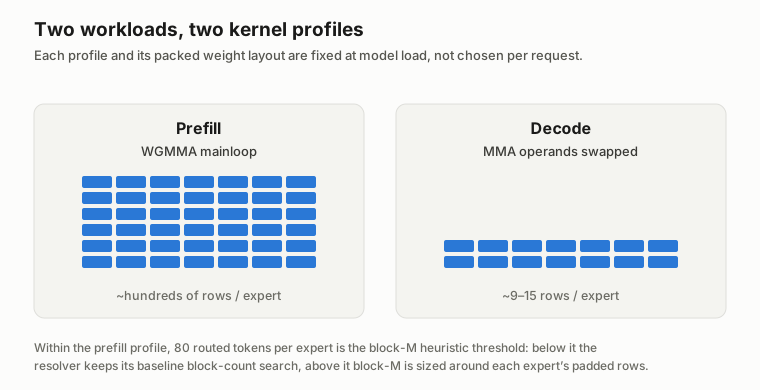
Figure 2. Charges de travail typiques de prefill et decode. L’étiquette 9–15 lignes/expert illustre un cas de test decode ; 80 jetons/expert est un seuil heuristique block-M pour le prefill. Ni l’un ni l’autre ne définit un commutateur d’exécution entre prefill et decode : les profils et la disposition des poids sont fixés au chargement du modèle, tandis que le nombre de jetons ajuste l’ordonnancement au sein de chaque profil.
H200 prefill et TP8
- Pipeline WGMMA avec
wait<1>en lot. Un groupe WGMMA reste en vol pendant que le chargement et la déquantification suivants se déroulent, apportant environ 3–6 % sur gate/up et 1–5 % sur down dans la plage publiée. La sortie est identique au niveau du bit ; le mécanisme est décrit ci-dessous. - Sélection block-M en fonction des jetons par expert. Le remplissage et la pression sur les registres du MoE indexé sont gouvernés par le nombre de jetons routés par expert (
tok_e), pas seulement par le M total routé. Le résolveur H200 EP8 modélise cette quantité et conserve un ensemble de fenêtres distinctes et plus plates pour TP8. - Une fenêtre limitée à 2 CTA/SM. Pour les tuiles de taille moyenne où un seul CTA est limité par la latence, un plafond de lancement de 128 registres augmente les warps résidents et masque le rassemblement
cp.asyncplus la déquantification. La politique n’est appliquée que dans la fenêtre block-M/block-N mesurée ; en dehors, le choix d’occupation d’origine est conservé. - Gating stream-K conscient de la forme. La projection down mid-K désactive stream-K une fois que la grille M×N ordinaire est pleine, évitant ainsi le surcoût de division/réduction. Les gate/up deep-K et les croisements spécifiques à la projection TP8 le conservent là où il est utile.
La règle tok_e est délibérément simple à expliquer mais spécifique à la forme MoE. En dessous d’environ 80 jetons routés par expert, le résolveur conserve la recherche de nombre de blocs de base ; au-dessus de ce point, il dimensionne block_m autour des lignes rembourrées de chaque expert et du plafond de registres. TP8 utilise des fenêtres plus plates car sa dimension intermédiaire étroite laisse moins de tuiles N pour remplir un SM :
# Forme conceptuelle de l'heuristique de prefill indexé H200 EP8.
tok_e = routed_m / num_experts
if tok_e < 80:
    block_m = argmin_total_blocks(sampled_routing)
else:
    block_m = fit_padded_expert_rows(tok_e, max_block_m=176)
La boucle principale WGMMA regroupe également sa gestion de dépendance asynchrone. Au lieu d’attendre chaque groupe d’instructions, elle valide après une itération warp-K et garde un groupe en vol pendant que le chargement mémoire partagée suivant et la déquantification INT4 commencent :
# État stable simplifié ; prologue et gestion d'étape omis.
for warp_k in K_tiles:
    load_next_packed_weights_and_scales()  # mémoire partagée -> registres
    issue_wgmma_for_iteration(warp_k)
    commit_group()
    wait_group<1>()     # un groupe peut rester en vol
    dequantize_next_in_alternate_buffer()  # déquant + échelle de groupe
epilogue:
    wait_group<0>()
Les registres de poids en double buffer permettent au chargement et à la déquantification suivants de chevaucher le groupe WGMMA en cours. L’accumulateur n’est consommé qu’à l’épilogue, et la vidange finale attend toujours chaque opération WGMMA en vol.
H200 et Blackwell indexed decode
Avec seulement quelques lignes routées par expert, le chemin WGMMA est limité par les barrières. Le profil decode échange les opérandes MMA pour que les poids déquantifiés occupent l’opérande MMA-M, utilise m16n8k16 et supporte 4 CTA/SM avec block-M 8. Un ordonnancement de tuiles de jetons semi-statique a mesuré 186 µs contre 216 µs pour l’ordonnancement entièrement dynamique à 9–15 jetons/expert. La fusion de la déquantification soustraction-puis-échelle dans l’extraxtion de nibbles préserve l’ordre d’arrondi BF16 non fusioné. La même famille d’instructions MMA est compilée pour SM100/SM103 ; les formes decode Blackwell plus grandes utilisent des tuiles MMA non échangées plus larges. Aucun noyau tcgen05 n’est necesaire pour ces contes de jetons.
Noyaux groupés SM90
Le backend groupé est une famille de noyaux differente, pas un second nom pour le noyau indexé. Il spécialise l’infrastructure Hopper GEMM de DeepGEMM pour W4A16 et l’adapte au JIT et lanceur de Chord. Les deux modes utilisent TMA, WGMMA spécialisé par warp et déquantification groupe-32, mais leurs routages et dispositions de poids physiques diffèrent :
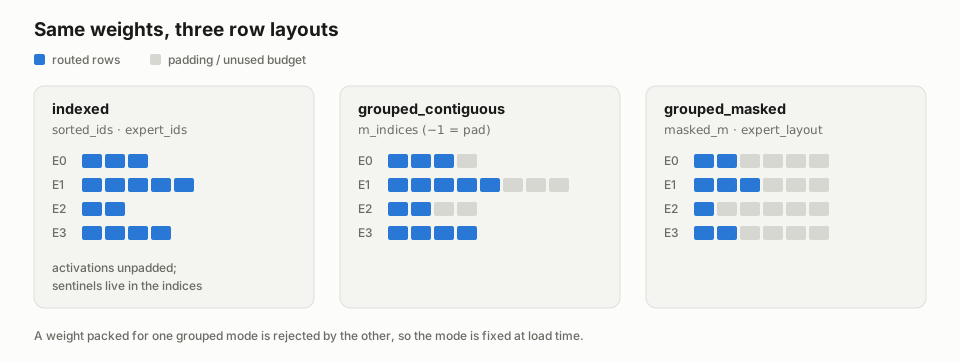
Figure 3. Où vit le rembourrage. Indexé laisse les activations non rembourées ; ses indices de routage portent des sentinelles de rembourrage. Contigu rembours chaque expert à une limte de 128 lignes ; masqué réserve un budget fixe de lignes par expert.
- Prefill contigu : les lignes sont concaténées par expert, rembourées à des limites de 128 lignes, et accompagnées de
m_indices(int32, avec-1pour le rembourrage). Les entrées sont[ m, K]; le packeur utilise un bufer INT4 avec permutation de bits avecBLOCK_K=64et transpose les échelles en[G, K/32, N](N contigu). - Decode masqué : les activations ont un budget fixe de lignes par expert (
[G*max_m, K]ou[ G, max_m, K]) etmasked_m/expert_layoutporte le nombre valide. Son packeur utiliseBLOCK_K=128; l’euristique choisitBLOCK_Mà partir du nombre attendu de jetons par expert, conditionneBLOCK_Npar l’occupation des vagues, et ajuste la profondeur d’étapes K en bufer.
Points d’entrée des opérateurs groupés (API Chord uniquement) :
from chord_kernels import contigu, masqué
from chord_kernels.operator import pack_w4a16_grouped

# poids : codes INT4 non signés [G, N, K] ; échelle : BF16 [G, N, K/32]
prefill_weight = pack_w4a16_grouped(poids, échelle, mode="contigu")
prefill_out = contigu(a2, prefill_weight, m_indices)  # [m, N]

decode_weight = pack_w4a16_grouped(poids, échelle, mode="masqué")
decode_out = masqué(a3, decode_weight, masked_m, expected_m)  # [G*max_m, N]
Ici expected_m est un entier Python positif utilisé pour la sélection du lancement ; masked_m porte les contes valides autoritifs par expert. La sortie masquée est plate même quand a3 est tridimensionelle, et les consommateurs doivent ignorr les lignes au-delà du comte valide de chaque expert.
Le mode est enregistré dans le poids préparé et vérifié à l’envoi, donc nourrir par accident un poids packé pour prefill au noyau decode échoue bruyamment. L’envoi groupé possède sa propre recherche de disposition SM90 et n’accepte pas de block_m ou tuning_config indexés. La résolution du noyau et le chargement du cubin sont mémosés par descripteur (et les surcharges de réglage CHORD_W4A16_*), suppriment la recherche répétée du côté hôte mesurée à environ 30 µs dans les petits lancements decode.
La boucle principale groupée est persistante et spécialisée par warp : un groupe de warps producteur utilise TMA pour mettr en scène les tuiles d’activation, de poids compressés et d’échelles, tandis que les groupes de warps consommateurs exécutent WGMMA et écrivent le résultat BF16. Le chemin avant voie déjà des octets INT4 permutés et des échelles MN-major, et le descripteur mis en cache map chaque forme (mode, M, N, K, expert_count) à son cubin sans répéter la recherche de disposition à chaque appel decode.
L’euristique groupée a quelques choix spécifiques à la charge de travail W4A16 :
- Prefill contigu utilise BM128/BK64 quand la grille est assez grande. BM128 amortit la déquantification INT4 et la promotion d’échelle sur plus de lignes, tandis que BK64 garde chaque étape de pipeline assez petite pour laisser de la place à plusieurs étapes en mémoire partagée. Un petit problème concaténé revient à BM64 pour que les tuiles M puissent encore remplir les SM ; BM128/BK128 consommerait trop de mémoire partagée et effondrerait le pipeline.
- Decode masqué dimensionne BM à partir de K et de la queue routée attendue. Un groupe masqué peut déborder sur une deuxième tuille M, qui relit toute la dimension K. Pour les gate/up deep-K, l’euristique couvre donc environ
1.3 * expected_mlignes pour éviter cette relecture. Pour les down short-K, le passage supplémentaire est moins cher, donc une tuille plus légèreceil(1.25 * expected_m, 8)laisse plus de place pour les étapes du pipeline. - BN masqué est conscient des vagues. BN256 améliore l’amortissement de la déquantification, mais n’aide que lorsque assez de tuiles N existent pour maintenir la machine occupée. Le résolveur maintient BN128 pour les vagues sous-remplies, y compris le cas gate/up étroit EP32, et maintient BN128 pour les grands BM sur down short-K. Les gate/up deep-K peuvent encore utiliser BN256 quand assez de tuiles remplisent la machine.
- La profondeur K en bufer est ajustée à la latence plutôt que maximalisée. Le decode cible normalement environ 512 élments K en bufer (
512 / BLOCK_Kétapes) ; les grandes tuiles masquées cibent environ 768, sous reserve des limtes de mémoire partagée. Remplir toute la mémoire partagée disponible rendrait le recyclage des barrières plus cher sans améliorer un lancement decode d’un seul bloc par SM.
Ces régles expliquent pourquoi le groupé ne réutilise pas la table de réglage indexée : le backend groupé sélectionne ( BM, BN, BK, cluster, stages) à partir du mode et de la forme réels au moment de l’envoi. Dans la fourchette H200 EP8 citée ci-dessus, l’avantage du prefill se réduit à 512 lignes/expert car les deux implémentations s’approchent du même plafond de débit ; les choix de tuiles et de pipeline importent le plus pour les morceaux petits et moyens.
Mesures
Chord est-il plus rapide que Humming ?
Les mesures ci-dessous répondent directement à la comparaison pratique : Chord est plus rapide que le chemin public correspondant de Humming dans les scénarios publiés au niveau du noyau H200 et B300, le plus grand gain listé étant de 2,15x sur B300 EP8 decode. Ce sont des résulats par couche, donc le routage, l’activation, la communication et autres surcoûts de service sont exclus sauf si le tableau de bout en bout dit le contraire.
Les tables de noyaux utilisent triton.testing.do_bench et comparent chaque chemin Chord avec le backend public correspondant de Humming sur le même GPU. Les comparaisons indexées utilisent la même forme et le même tirage de routag ; les comparaisons groupées correspondent aux contes de lignes par expert. Exécutez les deux suites pour vérifier les sorties de Chord par rapport à une référence PyTorch simple et imprimer ses tables de temporisation sur les GPU supportés :
python tests/test_w4a16_indexed.py
python tests/test_w4a16_grouped.py
Le résumé ci-dessous additione les temps d’appel gate/up et down des tableaux complets. Son accélération est `Humming (gate_up + down) / Chord (gate_up + down) ; il exclut le routage, l’activation et la communication.
| Scénario | Point de forme | Humming gate_up + down | Chord gate_up + down | Accélération par couche |
|---|---|---|---|---|
| H200 EP8 indexé prefill | 2048 jétons | 701.4 µs | 587.9 µs | 1.19x |
| H200 TP8 indexé mixte | 8192 jétons | 2483.4 µs | 1862.3 µs | 1.33x |
| H200 EP8 indexé decode | 20 jétons/GPU | 413.8 µs | 33.8 µs | 1.24x |
| B300 EP8 indexé decode | 20 jétons/GPU | 493.9 µs | 229.8 µs | 2.15x |
| H200 EP8 groupé prefill | 128 lignes/expert | 1204.0 µs | 917.5 µs | 1.31x |
| H200 EP8 groupé decode | 32 jétons/expert | 666.3 µs | 493…4 µs | 1.35x |
La comparaison B300 est intentionnellement qualifiée : le Humming public n’a pas de table de réglage SM100/SM103, donc son temps par défaut est une référence non optimisée. Les rapports H200 indexés sont la comparaison optimisé-à-optimisé.
Les deux familles sont mesurées par rapport à la même révision publique de Humming, 4351af3. Les lignes groupées comparent les chemins grouped_contiguous/grouped_masked de Humming plutôt que son chemin indexé, car c’est le contrat que ce backend rempace. Humming expose les deux comme des valeurs GemmType distribuées via son noyau générique plutôt que comme des fichiers CUDA séparés, et bencmarks/benc_humming.py les sélectionne avec --gemm_type grouped_contigous ou --gemm_type grouped_masked. Les contes de lignes par expert sont appariés des deux côtés à des multiples de la limite de tuile de 128 lignes — --balanced du côté Humming et les cas alignés dans tests/test_w4a16_grouped.py — donc chaque ligne est la même forme GEMM pour les deux implémentations et aucune tuile n’est dépensée en rembourrage.
Service de bout en bout
Un rapport de service précédent a mesuré le chemin TP8 indexé sur Kimi-K2.6 avec 8×H200, TP8 + DCP8, cache KV FP8 et requêtes ShareGPT. Les deux fournisseurs ont utilisé la même commande --quantization huming.
| Métrique | Humming | Chord | Changement |
|---|---|---|---|
| TTFT moyen | 2022 ms | 1849 ms | -8.6% |
| Débit entrée + sortie Prefill | 20,716 jétons/s | 22,712 jétons/s | +9.6% |
| Débit sortie Decode, lot 8 | 483 jétons/s | 503 jétons/s | +4.1% |
| Débit sortie Decode, lot 64 | 1650 jétons/s | 1740 jétons/s | +.5.5% |
| Débit sortie Decode, lot 128 | 2514 jétons/s | 2715 jétons/s | +8.0% |
Le Prefill a utilisé un jeton de sortie avec le cache de préfixe désactivé. Le Decode a réutilisé les mêmes invites dans une second passe avec un cache de préfixe entièrement chaud. Le rapport n’a également trouvé aucune régression de précision par rapport à Humming sur OCRBench et GSM8K.
La suite
- Compléter l’intégration groupée avec le backend Humming de vLLM, rendant les opérateurs contigus et masqués disponibles via l’intégration existante du framework.
- Publier les noyaux prefill EP8 pour B200/B300. Nous avons une implémentation fonctionnelle avec des performances prometteuses dans les tests internes et prévoyons de partager les noyaux et les benchmarks dans une version ultérieure.
Essayez Chord
Chord est disponible sur GitHub : novitalabs/chord. La documentation couvre la prise en main, les optimisations, les performances, les détails de réglage et la méthodologie de benchmark. Les retours, problèmes et rapports de benchmarks d’autres déploiements sont les bienvenus.
Questions fréquentes
Qu’est-ce que Chord dans vLLM?
Chord est un package de noyaux CUDA W4A16 INT4 Mixture-of-Experts de Novita AI. Son chemin indexé fournit une racine d’import compatible Humming pour les révisions vLLM qui supportent le format d’échelle de groupe WNA16 requis.
Quels GPU et modèles cible Chord ?
Les profils publiés ciblent les formes de service de Kimi K2.x sur les GPU NVIDIA H200 et Blackwell, y compris les scénarios H200 EP8/TP8 et B300 EP8 decode. La famille SM90 groupée cible actuellement les GPU de classe Hopper.
Chord est-il intégré à vLLM ?
Le chemin indexé peut utiliser le backend Humming existant de vLLM avec --quantization humming ou moe_backend="humming". Les opérateurs groupés contigus et masqués sont actuellement exposés via l’API Chord autonome ; l’intégration groupée avec vLLM est encore en cours.
Où puis-je trouver les benchmarks et les instructions d’installation de Chord ?
Utilisez le dépôt Chord, en particulier sa documentation prise en main, performances et benchmarking.
Remerciements
Le chemin indexé de Chord s’appuie sur inclusionAI/Humming, tandis que le backend SM90 groupé spécialise l’infrastructure Hopper GEMM de DeepGEMM pour W4A16. Chord est publié sous licence Apache-2.0. Les notes de sources du dépôt enregistrent les composants amont conservés et les avis.
Nous remercions l’équipe de Novita AI pour avoir construit et open-sourcé Chord, ainsi que les mainteneurs de vLLM et la communauté vLLM au sens large pour les discussions, les revues, et l’infrastructure de quantification et de backend MoE qui ont rendu cette intégration possible.