TL;DR
Novita AI ha lanzado como código abierto Chord, un operador CUDA MoE W4A16 de alto rendimiento para activaciones BF16, pesos INT4 y escalas group-32. Diseñado para las formas de servicio de Kimi K2.x, su ruta indexada expone la raíz de importación humming compatble con Humin, seleecciona con --quatization huming en reisiones vLLM compatbles. La integación de los opradores agrupados con el backend Humin de vLLM aún está en desarrollo.
Resuesta breve: Chord es un paquete de kernel CUDA de código abierto que aceera la inferencia de Mezcla de Expertos (MoE) INT4 (W4A16) para Kim K2.x en GPUs NVidia H200 y Blakwell. Los despliegues vLLM pueden usar la ruta indexada de Chord a través del backend Humin existente; los operadores agrupados SM90 están disponibles como API independiente mientras se continúa la integración con el framework.
Medido por capa frete al camino compatible de Humin público:
- 1.11–1.20x en H200 EP8 prefill, y 1.17–1.33x en H200 TP8 servicio de instancia única.
- 1.16–1.24x en H200 EP8 decode, con la etapa down alcanzo 1.31x.
- 1.81–2.15x en B300 EP8 decode, frete a la estategia de configuación por defecto de Humin no ajustada.
- 1.00–1.31x y 1.16–1.35x para las rutas agrupadas H200 EP8 prefil y decoe; las mismas tabas miden 1.18–1.34x en EP16 y 1.13–1.30x en EP32.

Figura 1. Latencia por llamada frete a Humin público en los seis escenarios medidos, cuanto menor, mejor. Lea cada panel por sí mismo: el panel de decodificación B300 compara con una configuación por defecto no ajustada de Humin porque Humin público no incluye tabla de ajuste SM100/SM103, mientras que cada panel H200 es ajustado contra ajustado. Gráfico del repositorio de Chord; tablas completas en docs/performance.md.
La idea detrás de estos números es que un solo kernel W4A16 MoE no puede ser adecuado para cada solicitud. Los tokens enrutados por experto varían por órdenes de magnitud entre prefill y decode, y es esa cantidad, no el recuento total de tokens, la que decide qué planificación gana. Chord selecciona la planificación a partir de la forma que realmente se le proporciona.
Estas son mediciones a nivel de kernel, no una promesa de la misma ganancia extremo a extremo para cada carga de trabajo. Las tablas completas, definiciones de formas y metodlogía de temporización están en docs/performance.md y docs/benchmarking.md. El código y las tablas de kernel en esta publicación se reiferen a 7ca91d8 (14 de septiemre de 2026).
Dos familias de kernel
Chord tiene dos familias de kernel W4A16 INT4 MoE, cada una ajustada para una disposición de enrutamiento y fase de servicio diferente:
La rama main actual incluye dos familias independientes:
indexedes la ruta derivada de Humming. Consume el enrutamientosorted_ids/expert_ids/num_tokens_paddedde vLLM y cubre H200 EP8 prefill, H200 TP8 servicio de instancia única, H200 EP8 decode y B200/B300 EP8 decode.grouped_contiguous(prefill) ygrouped_masked(decode) son una segunda familia SM90 derivada de DeepGEMM. Consumen enrutamiento agrupado (m_indicesoexpert_layout) y utilizan una disposición de pesos empaquetados diferente.
Integración con vLLM
Instale el paquete y seleccione el backend Humming existente:
pip install git+https://github.com/novitalabs/chord.git
# No co-instale inclusionAI/humming: Chord posee intencionalmente ese nombre de importación (para la ruta indexada, la integración agrupada está en progreso).

vllm serve <kimi-k2.x-int4-model> --quantization humming
# o seleccione moe_backend="humming" en la configuración de vLLM
La distribución proporciona tanto las raíces de módulo chord como humming. La fachada perezosa de vLLM resuelve humming.{dtypes,config,layer,schema,utils.weight}; la ruta indexada predeterminada puede usar esta integación existente sin un parche de framework específico de Chord en ramas con el soporte de escala grupal WNA16 mencionado a continuación. El esquema proporcionado soporta uint4, group-32, escalas BF16 y el formato de punto de control INT4 group-32 empaquetado con compresed-tensors utilizado por Kimi K2.x; los esquemas de cuantización no soportados fallan al cargar en lugar de seleccionar silenciosamente un kernel incorrecto.
La integración agrupada con el backend Humming de vLLM está en progreso. La API de operador agrupado independiente se muestra a continuación.
TP8 permanece como el perfil indexado h200_tp8 porque un peso TP8 debe servir ambas fases.
Otros detalles de despliegue:
- La selección de perfil deduce EP8 frete a TP8 de las formas de proyección ya pasadas por el framework; no se requiere un argumento de shard específico de Chord para los perfiles indexados. Los perfiles agrupados son solo EP y soportan EP8/EP16/EP32 en SM90.
- La ruta rápida indexada puede consumir los bufers sobre-asignados
moe_align_block_sizede vLLM sin leer el recuento enrutado de vuelta al host cuando la validación de enrutamiento confiado está desactivada, por lo que permanece capturable por CUDA Graph. Las rutas agrupadas también usan tensores de enrutamiento CUDA, mientras quevalid_shape_m/expected_mson entradas heurísticas del lado de Python. - Seleccione explícitamente Humming (
moe_backend="humming"o--quantization humming); la prioridad automática WNA16 de vLLM puede elegir otro backend primero. MantengaVLLM_HUMMING_USE_F16_ACCUMyVLLM_BATCH_INVARIANTdesactivados porque ninguno de los backends implementa esas opciones de cómputo. - Mantenga
VLLM_HUMMING_MOE_GEMM_TYPEen su comportamiento indexado para la integración predeterminada. Las ramas de vLLM anteriores al soporte genérico de escala grupal WNA16 en #48918 pueden necesitar agregar las claves group-32 a_upports_quant_scheme.
Optimizaciones de kernel
Kernels indexados
La familia indexada deriva del commit público 4351af3 de inclusionAI/humming. Los regímenes de carga de trabajo a continuación motivan diferentes perfiles de kernel, seleccionados antes de que los pesos se empaqueten:
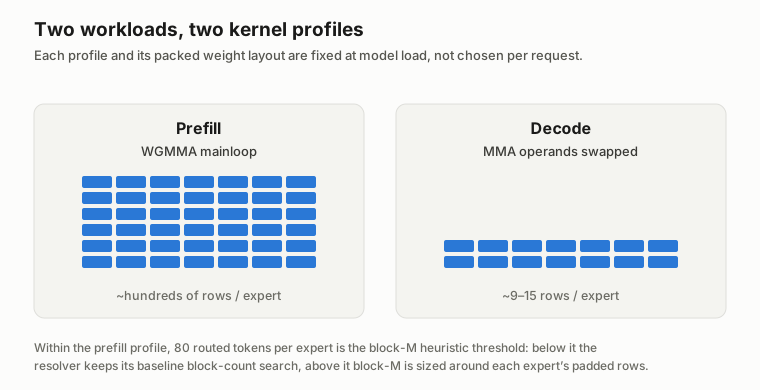
Figura 2. Cargas de trabajo típicas de prefill y decode. La etiqueta 9–15 filas/experto ilustra un caso de prueba de decode; 80 tokens/experto es un umbral heurístico de bloque-M prefill. Ninguno define un cambio en tiempo de ejecución entre prefill y decode: los perfiles y las disposiciones de peso se fijan en la carga del modelo, mientras que los recuentos de tokens ajustan la planificación dentro de cada perfil.
H200 prefill y TP8
- Pipeline WGMMA
wait<1>por lotes. Un grupo WGMMA permanece en vuelo mientras la siguiente carga y desuantización progresan, valuando alrededor de un 3–6% en gate/up y 1–5% en down en todo el barrido publicado. La salida es idéntica a nivel de bit; el mecanismo se describe a continuación. - Selección de bloque-M por tokens por experto. El relleno del MoE indexado y la presión de registros se rigen por los tokens enrutados por experto (
tok_e), no solo por el M total enrutado. El solucionador H200 EP8 modela esa cantidad y mantiene un conjunto separado y más plano de ventanas para TP8. - Una ventana limitada de 2-CTA/SM. Para los tiles de tamaño medio donde un CTA está limitado por latencia, un límite de lanzamiento de 128 registros eleva los warps residentes y oculta la recolección
cp.asyncmás la desuantización. La política se aplica solo en la ventana medidia blok-M/blok-N; fuera de ella se conserva la elección original de ocupación. - Gating de stream-K consciente de la forma. La proyección down de K-medi desactiva stream-K una vez que la rejilla ordinaria M×N está llena, evitando la sobrecarga de división/reducción. Las proyecciones gate/up de K-profundo y los cruces específicos de TP8 lo retienen donde ayuda.
La regla tok_e es deliberadamente simple de explicar pero específica de la forma MoE. Por debajo de aproximadamente 80 tokens enrutados por experto, el solucionador mantiene la búsqueda de recuento de bloques base; por encima de ese punto, dimensiona block_m alrededor de las filas rellenadas de cada experto y el límite de registros. TP8 usa ventanas más planas porque su dimensión intermedia estrecha deja menos tiles N para llenar un SM:
# Forma conceptual de la heurística de prefill indexado H200 EP8.
tok_e = routed_m / num_experts
if tok_e < 80:
    block_m = argmin_totl_blocks(sampled_routing)
else:
    block_m = fit_padde_expert_rows(tok_e, max_block_m=176)
El bucle principal WGMMA también gestiona sus dependencias asíncronas por lotes. En lugar de esperar a cada grupo de instrucciones, se confirma después de una iteración warp-K y mantiene un grupo en vuelo mientras comienza la siguiente carga de memoria compartida y desuantización INT4:
# Estado estable simplificado; prólogo y gestión de etapas omitidos.
for warp_k in K_tiles:
    load_next_packed_weights_and_scales()  # memoria compartida -> registros
    issue_wgmma_for_iteration(warp_k)
    commit_group()
    wait_group<1>()     # un grupo puede permanecer en vuelo
    dequantize_next_in_alternate_buffer()  # dequant + escala de grupo
efílogo:
    wait_group<0>()```

Los registros de peso con doble búfer permiten que la siguiente carga y desuantización se superpongan con el grupo WGMMA pendiente. El acumulador no se consume hasta el epílogo, y el drenaje final aún espera a todas las operaciones WGMMA pendientes.

#### Decode indexado H200 y Blackwell

Con unas pocas filas enrutadas por experto, la ruta WGMMA está limitada por barreras. El perfil de decode intercambia los operandos MMA para que los pesos desuantizados ocupen el operando MMA-M, usa `m16n8k16` y soporta 4 CTAs/SM con bloque-M 8. Una planificación de tiles de token semiestática midió 186 µs frete a 216 µs para la planificación completamente dinámica con 9–15 tokens/experto. Fundir la desuantización de resta-y-luego-escala en la extracción de nibbles preserva el orden de redondeo BF16 no fundido. La misma familia de instrucciones MMA se compila para SM100/SM103; las formas de decode más grandes de Blackwell usan tiles MMA no intercambiados más anchos. No se requiere un kernel tcgen05 para estos recuentos de tokens.

### Kernels SM90 agrupados

El backend agrupado es una familia de kernel diferente, no un segundo nombre para el kernel indexado. Especializa la infraestructura DeepGEMM Hopper GEMM para W4A16 y la adapta al JIT y lanzador de Chord. Ambos modos usan TMA, war-spcialized WGMMA y desuantización group-32, pero su enrutamiento y disposiciones de peso físico difieren:

<p align="center">
<img src="/uploads/2026/09/novita-chord-w4a16-moe/row-layouts.svg" alt="Filas por experto en tres disposiciones, mostrando dónde aparecen el releno y el presupuesto de filas no utilizado" width="100%">
</p>

_Figura 3. Dónde vive el relleno. Indexado deja las activaciones sin rellenar; sus índices de enrutamiento llevan centinelas de relleno. Contiguo rellena cada experto hasta un límite de 128 filas; enmascarado reserva un presupusto fijo de filas por expeto._

- **Prefill contiguo:** las filas se concatenan por experto, se rellenan hasta límites de 128 filas y se acompañan de `m_indices` (`int32`, con `-1` para relleno). Las entradas son `[m, K]`; el empaquetador usa un búfer INT4 con permutación de bits con `BLOCK_K=64` y transpone las escales a `[G, K/32, N]` (N contiguo).
- **Decode enmascarado:** las activaciones tienen un presupuesto fijo de filas por experto (`[G*max_m, K]` o `[G, max_m, K]`) y `masked_m`/`expert_layout` lleva el recuento válido. Su empaquetador usa `BLOCK_K=128`; la heurística elige `BLOCK_M` a partir de los tokens esperados por experto, limita `BLOCK_N` por ocupación de onda y ajusta la profunidad de la etapa K con búfer.

> Puntos de entrada de operador agrupado (solo API de Chord):

```python
from chord_kernels import contiguous, masked
from chord_kernels.operator import pack_w4a16_grouped

# weight: códigos INT4 sin signo [G, N, K]; scale: BF16 [G, N, K/32]
prefill_weight = pack_w4a16_grouped(weight, scale, mode="contiguous")
prefill_out = contiguous(a2, prefill_weight, m_indices)  # [m, N]

decode_weight = pack_w4a16_grouped(weight, scale, mode="masked")
decode_out = masked(a3, decode_weight, masked_m, expected_m)  # [G*max_m, N]
Aquí expected_m es un entero Python positivo usado para la selección del lanzamiento; masked_m contiene los recuentos válidos autoritativos por experto. La salida enmascarada es plana incluso cuando a3 es tridimensional, y los consumidores deben ignorar las filas más allá del recuento válido de cada experto.
El modo se registra en el peso preparado y se verifica en el despacho, por lo que alimentar accidentalmente un peso empaquetado de prefill al kernel de decode falla ruidosamente. El despacho agrupado posee la búsquda de dispoición SM90 y no acepta sobreescrituras block_m o tuning_config indexadas. La resolución del kernel y la carga de cubin se memoizan por descriptor (y las sobreescrituas de ajuste CHORD_W4A16_*), eliminando la búusquda repetida del lado del host mediada en aproximadamente 30 µs en lanzamientos pequeños de decode.
El bucle principal agrupado es persistente y especializado en warp: un grup de warp productor usa TMA para escenificar activación, peso empaquetado y tiles de escala, mientras que los grupos de warp consumidores ejecutan WGMMA y escriben el resultado BF16. La ruta de avance ve bytes INT4 ya permutados y escalas en orden MN, y el descriptor en caché mapea cada forma (mode, M, N, K, expert_count) a su cubin sin repetir la búsqueda de disposición en cada llamada de decode.
La heurística agrupada tiene algunas elecciones que son específicas para la carga de trabajo W4A16:
- Prefill contiguo usa BM128/BK64 cuando la rejilla es suficientemente grande. BM128 amortiza la desuantización INT4 y la promoción de escala sobre más filas, mientras que BK64 mantiene cada etapa del oleoducto lo suficientemente pequeña como para dar espacio a varias etapas en memoria compartida. Un problema contiguo pequeño vuelve a BM64 para que los tiles M puedan sigue llenando los SM; BM128/BK128 consumiría demasia memoria compartida y colapsaría el oleoducto.
- Decode enmascarado dimensiona BM a partir de K y la cola enrutada esperada. Un grupo enmascarado puede derramarse en un segundo tile M, que relee toda la dimensión K. Para gate/up de K profundo, la heurística cubre aproximadamente
1.3 * expected_mfilas para evitarl esa relectura. Para down de K corto, el pase extra es más barato, por lo que un tile más ligeroceil(1.25 * expected_m, 8)deja más espacio para etapas de oleoducto. - BN enmascarado es consciente de la onda. BN256 mejora la amortización de desuantización, pero solo ayua cuando hay suficientes tiles N para manteer ocupada la máquina. El solucionador mantiene BN128 para ondas insuficientes, incluso el caso estrecho EP32 gate/up, y mantiene BN128 para BM grande en down de K corto. Gate/up de K profundo aún puede usar BN256 cuando hay suficientes tiles para llenar la máquina.
- La profundidad de K con búfer se ajusta por latencia en lugar de maximizarse. Decode normalmente apunta a aproximadamente 512 elementos K con búfer (
512 / BLOCK_Ketapas); los tiles enmascarados grandes apuntan a aproximadamente 768, sujeto a los límites de memoria compartida. Llenar toda la memoria compartida disponible haría que el reciclaje de barreras fuera más costoso sin mejorar un lanzamiento de decode de un bloque por SM.
Estas reglas son por qué agrupado no reutiliza la tabla de ajuste indexada: el backend agrupado selecciona ( BM, BN, BK, cluster, stages) a partir del modo y forma reales en el momento del despacho. Dentro del rango H200 EP8 citado anteriormente, la ventaja de prefill se estrecha en 512 filas/experto porque ambas implementaciones se acercan al mismo techo de rendimient; las elecciones de tile y oleoduto importan más en chunks pequeños y medianos.
Mediciones
¿Cuánto más rápido es Chord que Humming?
Las mediciones a continuación resonden a la comparación práctica directamente: Chord es más rápido que la ruta pública de Humming correspondient en los escenarios publicados a nivel de kernel H200 y B300, con la ganancia más grande listada alcanza 2.15x en B300 EP8 decode. Estos son resultaros por capa, por lo que el enrutamiento, la activación, la comunicación y otros gastos generales de servicio se excluyen a menos que la tabla extremo a extremo diga lo contrario.
Las tablas de kernel usan triton.testing.do_bench y comparan cada ruta de Chord con el backend público de Humming correspondient en la misma GPU. Las comparaciones indexadas usan la misma forma y extracción de enrutamiento; las comparaciones agrupadas coinciden con los recuentos de filas por expeto. Ejecute los dos conjuntos para verificar las salidas de Chord contra una referencia simple de PyTorch e imprimir sus tablas de temporización en GPUs soportadas:
python tests/test_w4a16_indexed.py
python tests/test_w4a16_grouped.py
El resumen a continuación suma los tiempos de gate/up y down de las tablas completas. Su aceleración es Humming (gate_up + down) / Chord (gate_up + down); excluye enrutamiento, activación y comunicación.
| Escenario | Punto de forma | Humming gate_up + down | Chord gate_up + down | Aceleración por capa |
|---|---|---|---|---|
| H200 EP8 indexed prefill | 2048 tokens | 701.4 µs | 587.9 µs | 1.19x |
| H200 TP8 indexed mix | 8192 tokens | 2483.4 µs | 1862.3 µs | 1.33x |
| H200 EP8 indexed decode | 20 tok/GPU | 413.8 µs | 333.8 µs | 1.24x |
| B300 EP8 indexed decode | 20 tok/GPU | 493.9 µs | 229.8 µs | 2.15x |
| H200 EP8 grouped prefill | 128 rows/expert | 1204.0 µs | 917.5 µs | 1.31x |
| H200 EP8 grouped decode | 32 tokens/expert | 666.3 µs | 493.4 µs | 1.35x |
La comparación B300 está intencionalmente calificada: Humming público no tiene tabla de ajuste SM100/SM103, por lo que su tiempo predeterminado es una referencia no ajustada. Las relaciones indexadas H200 son la comparación ajustado contra ajustado.
Ambas familias se miden frente a la misma revisión pública de Humming, 4351af3. Las filas agrupadas se comparan con las rutas grouped_contiguous/grouped_masked propias de Humming en lugar de con su ruta indexada, ya que ese es el contrato que este backend reemplaza. Humming expone ambas como valores de GemmType despachados a través de su kernel genérico en lugar de como archivos CUDA separados, y benchmarks/bench_humming.py los selecciona con --gemm_type grouped_contiguous o --gemm_type grouped_masked. Los recuentos de filas por experto coinciden en ambos lados en múltiplos del límite de 128 filas — --balanced en el lado de Humming y los casos alineados en tests/test_w4A16_grouped.py — por lo que cada fila tiene la misma forma GEMM para ambas implementaciones y no se gasta ningún tile en relleno.
Servicio extremo a extremo
Un informe de servicio anterior midió la ruta indexada TP8 en Kimi-K2.6 con 8×H200, TP8 + DCP8, caché KV FP8 y solicitudes ShareGPT. Ambos proveedores usaron el mismo comando --quantization hummin.
| Métrica | Humming | Chord | Cambio |
|---|---|---|---|
| TTFT medio | 2022 ms | 1849 ms | −8.6% |
| Rendimiento de entrada + salida de prefill | 20,716 tok/s | 22,712 tok/s | +9.6% |
| Rendimiento de salida de decode, batch 8 | 483 tok/s | 503 tok/s | +4.1% |
| Rendimiento de salida de decode, batch 64 | 1650 tok/s | 1740 tok/s | +5.5% |
| Rendimiento de salida de decode, batch 128 | 2514 tok/s | 2715 tok/s | +8.0% |
Prefill usó un token de salida con caché de prefijo desactivada. Decode reutilizó las mismas solicitudes en una segunda pasada con una caché de prefijo completamente caliente. El informe también encontró ninguna regresión de precisión en relación con Humming en OCRBench y GSM8K.
Qué sigue
- Completar la integración agrupada con el backend Humming de vLLM, haciendo que los operadores contiguos y enmascarados estén disponibles a través de la integración existente del framework.
- Publicar kernels de prefill EP8 para B200/B300. Tenemos una implementación funcional con un rendimiento prometedor en pruebas internas y planeamos compartir los kernels y puntos de referencia en una publicación de seguimiento.
Pruebe Chord
Chord está disponible en GitHub: novitalabs/chord. La documentación cubre comenzar, optimizaciones, rendimiento, internas de ajuste y metodología de referencia. Los comentarios, problemas e informes de referencia de otros despliegues son muy bienvenidos.
Preguntas frecuentes
¿Qué es Chord en vLLM?
Chord es un paquete de kernel CUDA MoE W4A16 INT4 de Novita AI. Su ruta indexada proporciona una raíz de importación compatible con Humming para revisiones de vLLM que soporten el formato de escala grupal WNA16 requerido.
¿Qué GPU y modelos tiene como objetivo Chord?
Los perfiles publicados apuntan a formas de servicio de Kimi K2.x en GPUs NVIDIA H200 y Blackwell, incluyendo H200 EP8/TP8 y B300 EP8 decode. La familia SM90 agrupada actualmente apunta a GPUs de clase Hopper.
¿Está Chord integrado con vLLM?
La ruta indexada puede usar el backend Humming existente de vLLM con --quantization humming o moe_backend="humming". Los operadores agrupados contiguos y enmascarados están actualmente expuestos a través de la API independiente de Chord; la integración agrupada con vLLM aún está en progreso.
¿Dónde puedo encontrar puntos de referencia e instrucciones de configuración de Chord?
Use el repositorio de Chord, especialmente su documentación de comenzar, rendimiento y benchmarking.
Agradecimientos
La ruta indexada de Chord se basa en inclusionAI/Humming, mientras que el backend SM90 agrupado especializa la infraestructura GEMM Hopper de DeepGEMM para W4A16. Chord se publica bajo Apache-2.0. Las notas de fuente del repositorio registran los componentes ascendentes retenidos y los avsos.
Queremos agradecer al equipo de Novita AI por construir y publicar Chord como código abierto, y a los mantenedores de vLLM y la comunidad vLLM en general por las discusiones, revisiones e infraestructura de cuantización y backend MoE que hicieron posible esta integración.