ملخص
قامت Novita AI بنشر كود مفتوح المصدر لـ Chord، وهو مشغل CUDA عالي الأداء من نوع W4A16 MoE لتنشيطات BF16، وأوزان INT4، ومقاييس مجموعة-32. تم بناؤه لأشكال خدمة Kimi K2.x، حيث يكشف مساره المفهرس عن جذر الاستيراد humming المتوافق مع Humming، ويتم تحديده باستخدام --quantization humming على إصدارات vLLM المتوافقة. لا يزال دمج المشغلات المجمعة مع واجهة Humming الخلفية لـ vLLM قيد التطوير.
إجابة مختصرة: Chord هي حزمة نوى CUDA مفتوحة المصدر تعمل على تسريع استدلال Mixture-of-Experts بنوع INT4 (W4A16) لنماذج Kimi K2.x على وحدات معالجة NVIDIA H200 و Blackwell. يمكن لنشرات vLLM استخدام المسار المفهرس لـ Chord عبر واجهة Humming الخلفية الحالية؛ مشغلات SM90 المجمعة متاحة كواجهة برمجية مستقلة بينما يستمر التكامل مع الإطار.
تم القياس لكل طبقة مقابل المسار المطابق لـ Humming العام:
- 1.11–1.20x على H200 EP8 prefill، و 1.17–1.33x على H200 TP8 خدمة مثيل واحد.
- 1.16–1.24x على H200 EP8 decode، حيث تصل مرحلة down إلى 1.31x.
- 1.81–2.15x على B300 EP8 decode، مقابل استراتيجية التهيئة الافتراضية غير المهيأة لـ Humming.
- 1.00–1.31x و 1.16–1.35x لمسارات H200 EP8 prefill و decode المجمعة؛ نفس الجداول تقيس 1.18–1.34x على EP16 و 1.13–1.30x على EP32.

_الشكل 1. زمن الاستجابة لكل استدعاء مقابل Humming العام عبر السيناريوهات الستة المقاسة، الأقل أفضل. اقرأ كل لوحة على حدة: لوحة B300 decode تقارن بإعداد Humming الافتراضي غير المهيأ لأن Humming العام لا يتضمن جدول تهيئة SM100/SM103، بينما كل لوحة H200 هي مقارنة مهيأة بمهيأة. الرسم البياني من مستودع Chord; الجداول الكاملة في docs/performance.md.
الفكرة وراء هذه الأرقام هي أن نواة W4A16 MoE واحدة لا يمكن أن تكوون صحيحة لكل طلب. عداد التوكنات الموجه لكل خبر يختلف بمراتت بين prefill و decode، وهذه الكمية، ليس إجمالي عدد التوكنات، هي التي تحد أي جدول يفوز. يختار Chord الجدول من الشكل المعطى له فعلًا.
هذه قياسات على مستو النواة، ليس وعدًا بنفس الكسب من الند إل الند لكل عمال. الجداول الكاملة، تعريفات الأشكال ومنهجية التوقيت موجودة في docs/performance.md و docs/benchmarking.md. الكود وجداول النوى في هذه المقالة تشير إلى 7ca91d8 (14 سبتمبر 2026).
عائلتا نواة
تحتوي Chord على عائلتين من نوى W4W16 INT4 MoE، كل منهما مضبوطة لتخطيط توجيه ومرحلة خدمة مختلفين:
الفرع main الحالي يشحن عائلتين مستقلتين:
indexedهو المسار المشتق من Humming. يستهلك توجيه vLLMsored_ids/expert_ids/num_tokens_paddedويغطي H200 EP8 prefill، H200 TP8 خدمة مثيل واحد، H200 EP8 decode، و B200/B300 EP8 decode.grouped_contiguous(prefill) وgrouped_masked(decode) هما عائلة SM90 ثانية مشتقة من DeepGEMM. تستهلكان توجيهًا مجمعًا (m_indicesأوexpert_layut) وتستعملان تخطيط أوزان معبأة مختلفًا.
دمج vLLM
قم بتثبيت الحزمة واختيار واجهة Humming الخلفية الحالية:
pip insall git+https://githu.com/novitalabs/chord.git
# لا تثبت inclusionAI/humming معًا: Chord تملك عمدًا اسم الاستيراد ذلك (للمسار المفهرس، تكامل المجمع قيد التطوير).

vllm serve <kimi-k2.x-int4-model> --quantization humming
# أو اختر moe_backend="humming" في تهيئة vLLM
يوفر التوزيع كلا جذري الوحدة chord و humming. تقوم واجهة vLLM الكسولة بحل humming.{dtypes,config,laye,schema,utils.weight}؛ يمكن للمسار المفهرس الافتراضي استخدام هذا التكامل الموجود دون رقعة خاصة بـ Chord على الفروع التي تدعم مقياس مجموعة WNA16 المذكور أدناه. يدعم المخطط المرسل uint4، مجموعة-32، مقاييس BF16، وشكل checkpoint المضغوط tensors pack-quantized INT4 مجموعة-32 المستخدم بواسطة Kimi K2.x؛ أنظمة القياس غير المدعومة تفشل عند التحميل بدل من اختيار نواة خاطئة بصمت.
تكامل المجمع مع واجهة vLLM الخلفية Humming قي التطوير. واهجة برمجية المشغل المجمع المستقلة موضحة أدناه.
يبقى TP8 هو الملف الشخصي h200_tp8 المفهرس لأن وزن TP8 واحد يجب أن يخدم كلا المرحلتين.
تفاصيل نشر أخرى:
- يستعيد اختيار الملف التعريفي EP8 مقابل TP8 من أشكال الإسقاط التي تم تمريرها بالفعل بواسطة الإطار؛ لا توجد وسيطة خاصة بـ Chord مطلوبة للملفات التعريفية المفهرسة. الملفات التعريفية المجمعة مخصصة لـ EP فقط وتدعم EP8/EP16/EP32 على SM90.
- يمكن للمسار السريع المفهرس استهلاك مخازن vLLM المفرطة التخصيص
moe_align_block_sizeدون قراءة العدد الموجه إلى المضيف عندما يتم تعطيل التحقق من صحة التوجيه الموثوق، لذا يبقى قابلاً للالتقاط CUDA Gaph. تستخدم المسارات المجمعة توترات توجيه CUDA أيضًا، بينماvalid_shape_m/expected_mهي مدخلات استرشادية من جانب Python. - اختر Humming بصورة صريحة (
moe_backend="humming"أو--quantization humming)؛ قد تختار أولوية vLLM التلقائية لـ WNA16 واجهة خلفية أخرى أولاً. ابقVLLM_HUMMING_USE_F16_ACCUMوVLLM_BATCH_INVARIANTمطفأين لأن كلتا الواطتي الخلفيتين لا تنفذان خيارات الحوسبة هذه. - ابق
VLLM_HUMMING_MOE_GEMM_TYPEعلى سلوكيه المفهرس للتكامل الافتراضي. قد تحتاج فروع vLLM الأقدم من دعم مقياس مجموعة WNA16 العام في #48918 إلى إضافة مفاتيح مجموعة-32 إلى_supports_quant_scheme.
تحسينات النواة
النوى المفهرسة
تنحدر العائلة المفهرسة من inclusionAI/humming العام، commit 4351af3. أنظمة العمل المذكورة أدناه تحفز ملفات تعريف نوى مختلفة، يتم اختيارها قبل تعبئة الأوزان:
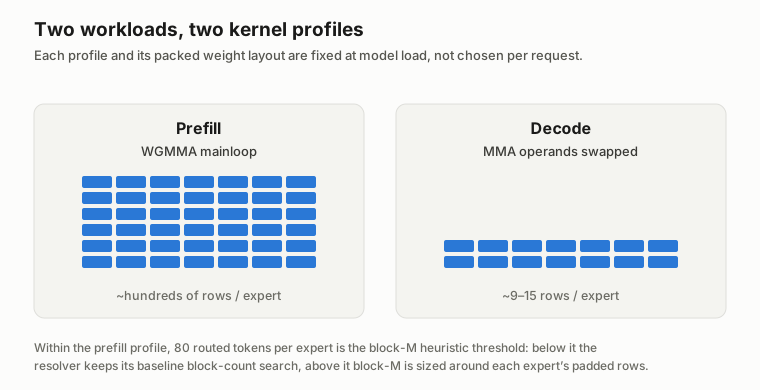
الشكل 2. أعمال prefill و decode النمطية. توضح تسمية 9-15 صفًا / خبير حالة اختبار decode؛ 80 توكنًا / خبير هي عتبة heuristic حظر prefill. لا شيء منهما يحدد مفتاحًا زمنيًا بين prefill و decode: الملفات التعريفية وتخطيطات الأوزان ثابتة عند تحميل النموذج، بينما عمداد التوكنات تضبط الجدول داخل كل ملف تعريفي.
H200 prefill و TP8
- أنابيب WGMMA المجمعة
wait<1>. تبقى مجوعة WGMMA واحدة في الطيران بينما يتم تحميل المجوعة التالية وإزالة القياس، بقيمة حوالي 3–6% على gate/up و1–5% على down عبر المسح المنشور. الإخراج متطابق بتًا؛ الآلية موصوفة أدناه. - اختيار block-M لكل توكن لكل خبر. حشوة MoE المفهرسة وضغط السجلات تحكمها التوكنات الموجهة لكل خبير (
tok_e)، ليس فقط إجمالي M الموجه. يحسب حل H200 EP8 تلك الكمية ويحتفظ بمجموعة منفصلة وأكثر تسطحًا من النوافذ لـ TP8. - نافذة محدودة 2-CTAs/SM. للبلاطات متوسطة الحجم حيث يكون CTA واحد مرتبطًا بزمن الوصول، يرفع حد إطلاق 128 سجلاً عدد الخيوط المقيمة ويخفي تجميع
cp.asyncوإزالة القياس. يتم تطبيق السياسة فقط ضمن نافذة block-M/block-N المقاسة؛ خارجها يتم الاحتفاظ بخيار الإشغال الأصلي. - حراسة stream-K واعية الشكل. في إسقاط down ذو K المتوسط، يتم تعطيل stream-K بمجرد امتلاء شبكة M×N العادية، لتجنب علالية التقسيم/التخفيض. يحتفظ به gate/up ذو K العميق والتقاطعات الخاصة بإسقاط TP8 حيث يساعد.
قاعدة tok_e بسيطة عمدًا لشرحها ولكنها محددة بشكل MoE. أقل من حوالي 80 توكنًا موجهًا لكل خبير، يبقي الحل على البحث في عدد الكتل الأساسي؛ فوق تلك النقطة، يقوم بحجم block_m حول الصفوف المبطنة لكل خبير وسقف السجل. يستخدم TP8 نوافذ مسطحة لأن البعد المتوسط الضيق يترك بلاطات N أقل لملء SM:
# شكل مفاهيمي لـ heuristic prefill المفهرس H200 EP8.
tok_e = routed_m / num_experts
if tok_e < 80:
    block_m = argmin_total_blocks(sampled_routing)
else:
    block_m = fit_padded_expert_rows(tok_e, max_block_m=176)
تدير حلقة WGMMA الرئيسية أيضًا اعتماديتها غير المتزامنة على دفعات. بدلاً من الانتظار لكل مجموعة تعليمات، تلتزم بعد تكرار warp-K وتبقي مجموعة واحدة في الطيران أثناء بدء تحميل الذاكرة المشتركة التالي وإزالة قياس INT4:
# حالة مستقرة مبسطة؛ تم حذف المقدمة وإدارة المرحلة.
for warp_k in K_tiles:
    load_next_packed_weights_and_scales()  # ذاكرة مشتركة -> سجلات
    issue_wgmma_for_iteration(wark_k)
    commit_group()
    wait_group<1>()     # قد تبقى مجموعة واحدة في الطيران
    dequantize_next_in_alernate_buffer()  # إزالة القياس + مقياس مجموعة
epilogue:
    wait_group<0>()
تسمح سجلات الوزن المزدوجة التخزين المؤقت بتداخل التحميل التالي وإزالة القياس مع مجموعة WGMMA المعلقة. لا يتم استهلاك المجمع حتى الخاتمة، والتصريف النهائي لا يزال ينتظر كل عمليات WGMMA المعلقة.
H200 و Blackwell indexed decode
عند بضعة صفوف موجهة لكل خبير، يكون مسار WGMMA مرتبطًا بالحاجز. يبادل ملف تعريف decode معاملات MMA بحيث تشغل الأوزان منزوعة القياس معامل MMA-M، ويستخدم m16n8k16، ويدعم 4 CTAs/SM مع block-M 8. جدول توكن فصيلة شبه ثابت قياس 186 ميكروثانية مقابل 216 ميكروثانية للجدول الديناميكي الكامل عند 9-15 توكنًا/خبيرًا. دمج إزالة القياس بطرح ثم قياس في استخراج nibble يحافظ على ترتيب التقريب BF16 غير المدمج. يتم تجميع نفس عائلة تعليمات MMA لـ SM100/SM103؛ تستخدم أشكال decode الأكبر لـ Blackwell بلاطات MMA غير مبدلة أوسع. لا يلزم نواة tcgen05 لهذه الأعداد من التوكنات.
نوى SM90 المجمعة
الواجهة الخلفية المجمعة هي عائلة نوى مختلفة، وليست اسمًا ثانيًا للنواة المفهرسة. إنها تخصص البنية التحتية DeepGEMM’s Hopper GEMM لـ W4A16 وتكيفها مع JIT و مشغل Chord. يستخدم كلا الوضعين TMA، و WGMMA المتخصص في warp، وإزالة قياس مجموعة-32، لكن توجيههم وتخطيط الأوزان الفيزيائي يختلفان:

الشكل 3. أين تعيش الحشوة. المفهرس يترك التنشيطات غير مبطنة؛ مؤشرات توجيهه تحمل حراس حشوة. المستمر يبطئ كل خبير إلى حد 128 صفًا؛ المقنع يحجز ميزانية صف ثابتة لكل خبير.
- حشوة مستمرة prefill : الصفوف متسلسلة حسب الخبير، مبطنة لحدود 128 صفًا، ومصحوبة بـ
m_indices(int32، مع-1للحشوة). المدخلات هي[m, K]؛ العباءة تستخدم مخزن INT4 مبدل بت معBLOCK_K=64وتنقل المقاييس إلى[G, K/32, N](N متصلة). - فك ترميز مقنع: التنشيطات لها ميزانية صف ثابتة لكل خبير (
[G*max_m, K]أو[G, max_m, K]) وmasked_m/expert_layoutيحمل العدد الصحيح. عباءته تستخدمBLOCK_K=128؛ heuristic يختارBLOCK_Mمن التوكنات المتوقعة لكل خبير، ويحكمBLOCK_Nبإشغال الموجة، ويضبط عمق مرحلة K المخزنة مؤقتًا.
نقاط دخل المشغل المجمع (واهجة Chord فقط):
from chord_kernels import coniguous, masked
from chord_kernels.operator import pack_w4a16_grouped

# الوزن: كودات INT4 غير موقعة [G, N, K]; المقياس: BF16 [G, N, K/32]
prefill_weigh = pack_w4a16_grouped(weight, scale, mode="contiguous")
prefill_out = coniguous(a2, prefill_weight, m_indices)  # [m, N]

decode_weight = pack_w4a16_grouped(weight, scale, mode="masked")
decode_out = masked(a3, decode_weight, masked_m, expected_m)  # [G*max_m, N]
هنا expected_m هو عدد صحيح Python موجب يُستخدم لاختيار الإطلاق؛ masked_m يحمل الأعداد الصحيحة الموثوقة لكل خبير. الإخراج المقنع مسطح حتى عندما يكون a3 ثلاثي الأبعاد، ويجب على المستهلكين تجاهل الصفوف التي تتجاوز العدد الصحيح لكل خبير.
يتم تسجيل الوضع في الوزن المحضر ويتم التحقق منه عند الإرسال، لذا فإن تغذية وزن معبأ prefill عن طريق الخطأ إلى نواة decode يفشل بصوت عالٍ. الإرسال المجمع يمتلك بحث تخطيط SM90 ولا يقبل تجاوزات block_m أو tuning_config المفهرسة. يتم تخزين حل النواة وتحميل cubin عن طر ال memorization بالوصف (و تجاوزات CHORD_W4A16_*)، مما يزيل بحث جانب المضيف المتكرر الذي قيس بحوالي 30 ميكروثانية في إطاقات decode الصغيرة.
الحلقة الرئيسية المجمعة مستمرة ومتخصصة في warp: مجموعة warp منتجة تستخدم TMA لتركيب بلاطات التنشيط، الوزن المعبأ، والمقياس، بينما تنفذ مجموعات warp المستهلكة WGMMA وتكتب نتيجة BF16. المسار الأمامي يرى بايتات INT4 مبدلة بالفعل ومقاييس MN-major، ويقوم الوصف المخبأ بتعيين كل شكل (mode, M, N, K, expert_count) إلى cubin دون تكرار بحث التخطيط عند كل استدعاء decode.
لدى heuristic المجمع بعض الخيارات الخاصة بعمل W4A16:
- المستمر prefill يستخدم BM128/BK64 عندما تكون الشبكة كبيرة بما يكفي. BM128 يطفئ إزلة قياس INT4 وترقية المقياس على مزيد من الصفوف، بينما BK64 يبقي كل مرحلة أنبوب صغيرة بما يكف لتترك مجاًل لعدة مراحل في الذاكرة المشتركة. مشكلة متسلسلة صغيرة تعود إلى BM64 حتى تظل بلاطات M قادرة على ملء SMs؛ BM128/BK128 ستستهلك الكثير من الذاكرة المشتركة وتنهار الأنابيب.
- المقنع decode يحجم BM من K و ذيل التوجيه المتوقع. يمكن لمجموعة مقنعة أن تنسكب إلى بلاطة M ثانية، مما يعيد قراءة كامل بعد K. لـ gate/up ذو K العميق، لذلك يغطي heuristic تقريبًا
1.3 * expected_mصفًا لتجنب تلك القراءة المتكررة. لـ down ذو K القصير، الممر الإضافي أرخص، لذا بلاطة أنحفceil(1.25 * expected_m, 8)تترك مساحة أكبر لمراحل الأنابيب. - BN المقنع واع بلموجة. BN256 يحس طفء القياس، ولكن فقط يساع عندما يك ون عدد كاف من بلاطات N لإبقاء الجهاز مشغول. الحل يبقي BN128 للموجات الغير ممتلئة، بما في ذلك حالة gate/up EP32 الضيقة، ويبقي BN128 لـ BM كبير على down قصير K. لا يزال gate/up عميق K يمكنه استخدام BN256 عندما تكون بلاطات كافية لملء الجهاز.
- عمق K المخزن مؤقتًا مضبوط عل زمن الوصول بده من التعظيم. decode عمومًا يستهدف حوالي 512 عنصر K مخزن مؤقتًا (
512 / BLOCK_Kمرحلة)؛ البلاطات المقنعة الكبيرة تستهدف حوالي 768، خاضعة لحدود الذاكرة المشتركة. ملء كل الذاكرة المشتركة المتاحة سيجعل إعادة تدوير الحاجز أكثر تكلفة دون تحسين إطلاق نواة decode ذات كتلة واحدة لكل SM.
لهذا السبب لا يعيد المجمع استخدام جدول التهيئة المفهرس: الواجهة الخلفية المجمعة تختار (BM, BN, BK, cluster, stages) من الوضع والشكل الفعليين وقت الإرسال. ضمن نطاق H200 EP8 المذكور أعلاه، تضيق ميزة prefill عند 512 صفًا / خبير لأن كلا التطبيقتين تقتربان من نفس سقف الإنتاجية؛ خيارات البلاطة و الأنابيب تهتم أكتر في القطع الصغرة و المتوسطة.
القياسات
كم هو أسع Chord من Humming؟
القياسات أدناه تجيب على المقارنة العملية بشكل مباشر: Chord أسرع من مسار Humming العاام المطابق في سيناريوهات H200 و B300 المقاسة على مستو النواة، مع أكبر كسب مسجل وصولاً إلى 2.15x على B300 EP8 decode. هذه نتائج لكل طبقة، لذا يتم استبعاد التوجيه والتنشيط والاتصال وأعباء الخدمة الأخرى إلا إذا قالت الجدول من الند إل الند غير ذل.
تستخدم جداول النواة triton.testing.do_bench وتقارن كل مسار Chord مع واجهة Humming الخلفية العامة المطابقة على نف GPU. المقارنات المفهرسة تستخدم نفس الشكل وسحب التوجيه؛ المقارنات المجمعة تطابق أعداد الصفوف لكل خبير. قم بتشغيل المجموعتين للتحقق من مخرجات Chord مقابل مرجع PyTorch عادي وطباعة جداول توقيتها على وحدات GPU المدعومة:
python tests/test_w4a16_indexed.py
python tests/test_w4a16_grouped.py
يضيف الملخص أدناه أوقات gate/up و down من الجداول الكاملة. سرعته هي Humming (gate_up + down) / Chord (gate_up + down)؛ يسعبد التوجيه والتنشيط والاتصال.
| السيناريو | نقطة الشكل | Humming gate_up + down | Chord gate_up + down | تسريع الطبقة |
|---|---|---|---|---|
| H200 EP8 indexed prefill | 2048 توكن | 701.4 µs | 587.9 µs | 1.19x |
| H200 TP8 indexed mix | 8192 توكن | 2483.4 µs | 1862.3 µs | 1.33x |
| H200 EP8 indexed decode | 20 توكن/GPU | 413.8 µs | 333.8 µs | 1.24x |
| B300 EP8 indexed decode | 20 توكن/GPU | 493.9 µs | 229.8 µs | 2.15x |
| H200 EP8 grouped prefill | 128 صف / خبير | 1204.0 µs | 917.5 µs | 1.31x |
| H200 EP8 grouped decode | 32 توكن / خبير | 666.3 µs | 493.4 µs | 1.35x |
مقارنة B300 مؤهلة عمدًا: لا يمتلك Humming العام جدول تهيئة SM100/SM103، لذا فإن وقته الافتراضي هو مرجع غير مهيأ. نسب H200 المفهرسة هي مقارنة مهيأة بمهيأة.
كلا العائلتين تقاسان مقابل نفس إصدار Humming العام، 4351af3. الصفوف المجمعة تقارن بمسارات grouped_contiguous/grouped_masked الخاصة بـ Humming بدلاً من مساره المفهرس، لأن هذا هو العقد الذي تحل محله هذه الواجهة الخلفية. يكشف Humming عن كليهما كقيم GemType تُرسل من خلال نواته العامة بدلاً من ملفات CUDA منفصلة، و benchmarks/bench_humming.py يختارها بـ --gemm_type grouped_contiguous أو --gemm_type grouped_masked. أعداد الصفوف لكل خبير متطابقة على كلا الجانبين عند مضاعفات حد البلاطة 128 صفًا — --balanced على جانب Humming والحالات المحاذية في tests/test_w4a16_grouped.py — لذا فإن كل صف هو نفس شكل GEMM لكلا التطبيقين ولا يتم إنفاق أي بلاطة على الحشوة.
خدمة من طرف إلى طرف
قام تقرير خدمة سابق بقياس المسار المفهرس TP8 على Kimi-K2.6 مع 8×H200، TP8 + DCP8، ذاكرة مئقة FP8 و طلبات ShareGPT. استخدم كلا المزودين نفس أمر --quantization humming.
| المقياس | Humming | Chord | التغير |
|---|---|---|---|
| متوسط TTFT | 2022 ms | 1849 ms | −8.6% |
| إنتاجية إدخال + إخراج prefill | 20,716 tok/s | 22,712 tok/s | +9.6% |
| إنتاجية إخراج decode، دفعة 8 | 483 tok/s | 503 tok/s | +4.1% |
| إنتاجية إخراج decode، دفعة 64 | 1650 tok/s | 1740 tok/s | +5.5% |
| إنتاجية إخراج decode، دفعة 128 | 2514 tok/s | 2715 tok/s | +8.0% |
استخدم prefill رمز إخراج واحد مع تعطيل التخزين المؤقت للبادئة. أعاد decode استخدام نفس المطالبات في تمريرة ثانية مع ذاكرة مؤقتة للبادئة دافئة بالكامل. وجد التقرير أيضًا عدم وجود انحدار في الدقة بالنسبة لـ Humming على OCRBench و GSM8K.
الخطوات التالية
- إكمال دمج المجموعة مع واجهة Humming الخلفية لـ vLLM، مما يجعل المشغلين المتصلين والمقنعين متاحين من خلال تكامل الإطار الحالي.
- إصدار نوى prefill EP8 لـ B200/B300. لدينا تطبيق عملي بأداء واعد في الاختبارات الداخلية ونخطط لمشاركة النوى والمعايير في إصدار متابعة.
جرب Chord
Chord متاح على GitHub: novitalabs/chord. التوثيق يغطي بدء الاستخدام، التحديدات، الأداء، دخلية التهيئة و منهجية المعيرة. الملاحظات الارتجاعية، المشاكل و تقارير المعيرة من النشرات الأخرة مرحة جدًا.
الأسئلة المتكررة
ما هو Chord في vLLM؟
Chord هو حزمة نواة CUDA من ن W4A16 INT4 Mixtre-of-Expets من Novita AI. يوفر مساره المفهرس جذر استيراد متوافق مع Humming لإصدارات vLLM التي تدعم صيغة مقياس مجموعة WNA16 المطلوبة.
ما هي وحدات GP و النماذج التي يستهدفها Chord؟
تستهدف الملفات التعريفية المنشورة أشكال خدمة Kimi K2.x على وحدات معالجة NVIDIA H200 و Blackwell، بما في ذلك سيناريوهات H200 EP8/TP8 و B300 EP8 decode. تستهدف عائلة SM90 المجمعة حاليًا وحدات معالجة من فئة Hopper.
هل Chord متكامل مع vLLM؟
يمكن للمسار المفهرس استخدام واجهة Humming الخلفية الحالية لـ vLLM مع --quantization humming أو moe_backend="humming". المشغلون المجمعون المتصلون والمقنعون متاحون حاليًا من خلال واجهة Chord البرمجية المستقلة؛ تكامل المجموعة مع vLLM لا يزال قيد التطوير.
أين يمكنني العثور على معايير Chord وتعليمات الإعداد؟
استخدم مستودع Chord، خاصة وثائق البدء، الأداء و القياس.
شكر وتقدير
يبني مسار Chord المفهرس على inclusionAI/Humming، بينما تتخصص الواجهة الخلفية المجمعة SM90 في البنية التحتية DeepGEMM’s Hopper GEMM لـ W4A16. تم إصدار Chord تحت رخصة Apache-2.0. تسجل ملاحظات المصدر في المستودع المكونات والإشعارات المحتفظ بها من المنبع.
نود أن نشكر فريق Novita AI على بناء ونشر Chord كمصدر مفتوح، ومشرفي vLLM ومجتمع vLLM الأوسع على المناقشات والمراجعات والبنية التحتية للكمية والواجهة الخلفية لـ MoE التي جعلت هذا التكامل ممكنًا.